


Siti che generano ricavi
Tieni sotto controllo esterno ricorrente negozio, prenotazioni, prodotto in abbonamento o sito di acquisizione lead.
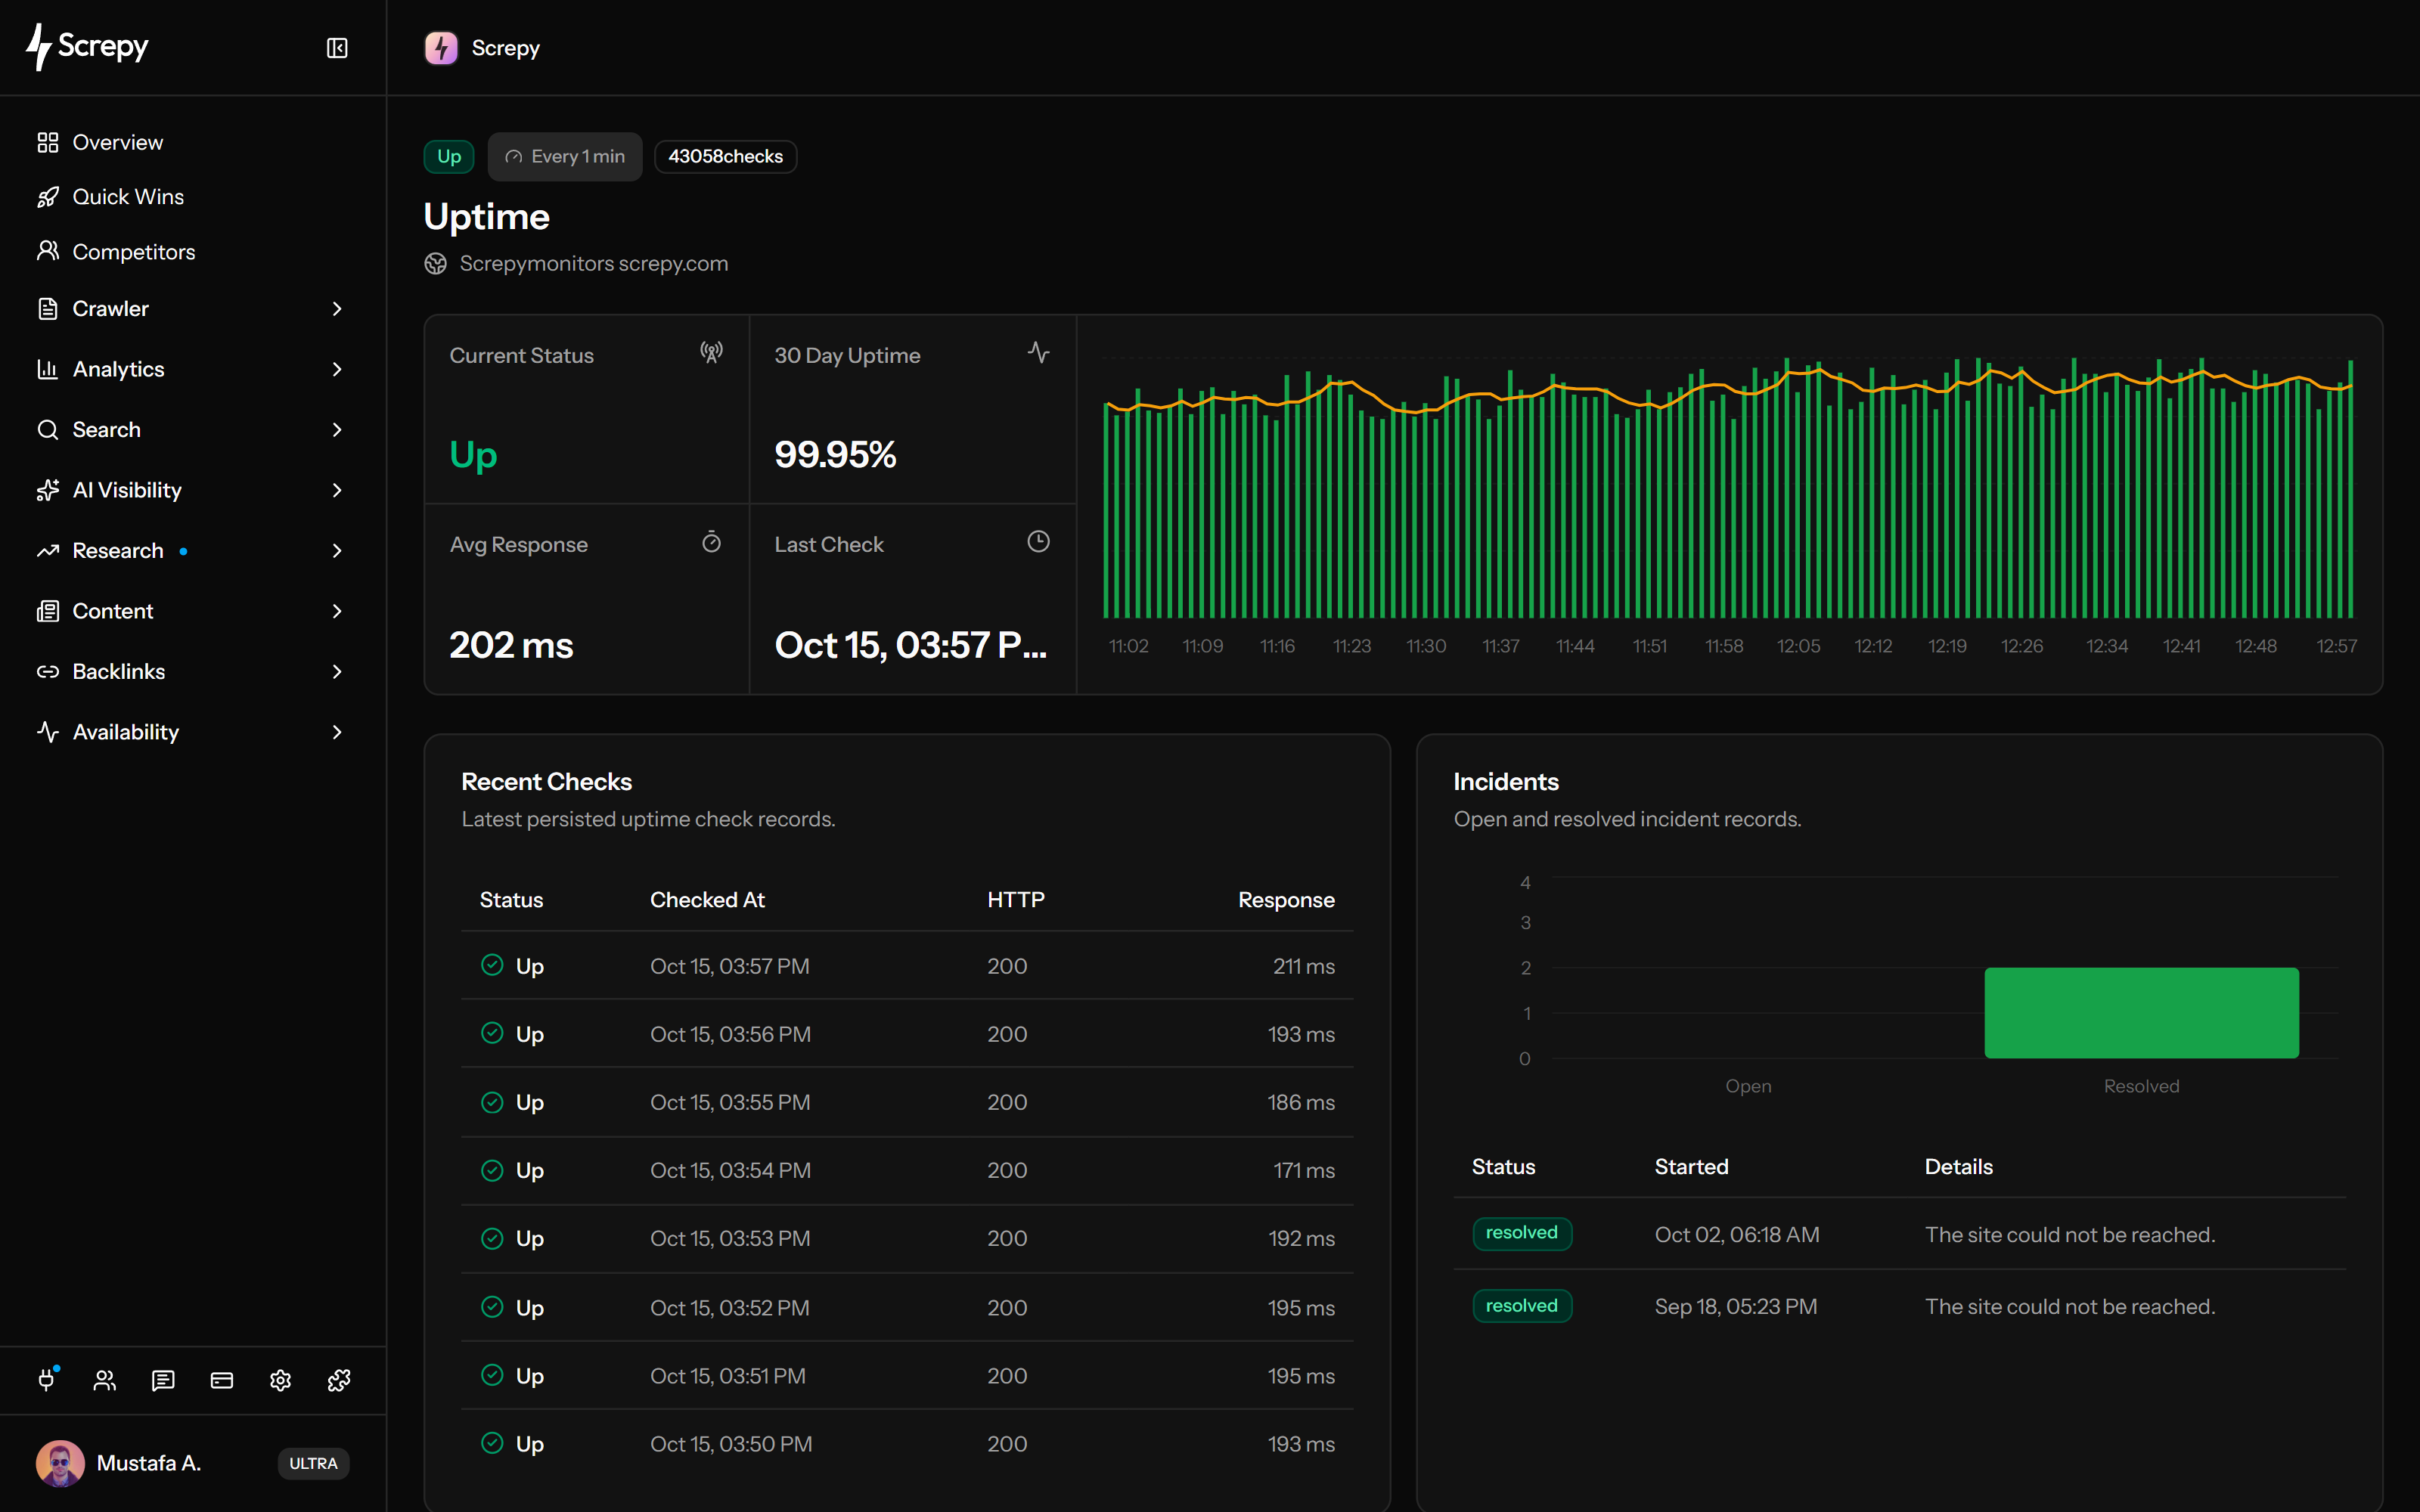
Monitora l’URL pubblico del progetto, esamina disponibilità e risposte di 30 giorni e indaga sui controlli HTTP falliti. Affianca storico degli incidenti e email idonee al lavoro SEO.


Attiva controlli periodici sull’URL pubblico salvato nel progetto Screpy. Scegli una destinazione utile ai visitatori prima di impostare la frequenza.
example.com60 s
Scopri quanti controlli hanno avuto successo negli ultimi 30 giorni. Leggi la percentuale insieme al numero di controlli e all’ultima data.
Disponibilità
93,8%Individua risposte lente e fallimenti ripetuti nel grafico. Un URL raggiungibile può comunque rispondere lentamente.
Tempo di risposta
240 msConsulta gli otto ultimi controlli con stato, data, codice HTTP e risposta. Confrontali con il comportamento previsto dell’URL pubblico.
Stato HTTP
200GET /HTTP/2 200Segui un incidente dal primo controllo fallito a uno successivo riuscito. L’indagine sulla causa resta separata.
Periodo
12 minInvia avvisi idonei ai membri del progetto e a un indirizzo aggiuntivo facoltativo. L’incidente viene registrato prima di poter generare un’email.
Progettoexample.com
RevisioneChiedi a un assistente connesso di spiegare risultati salvati di un progetto accessibile. Usa la data per distinguere dati registrati da un nuovo controllo.
/projectsJSON{
"data": [
{ "domain": "example.com" }
]
}Condividi dati di disponibilità in un report salvato per cliente o team. Un’istantanea risponde a una domanda diversa dal monitoraggio in diretta.
aACMEReportPDF
Leggi con SEO MCP uptime salvato di 30 giorni e record recenti di stato e risposta. Verifica la data prima di considerarli disponibilità attuale; non include incidenti o codici HTTP.
Scegli una destinazione pubblica, attiva il monitoraggio e configura un indirizzo responsabile. In caso di errore, esamina i record attuali e conferma un controllo successivo riuscito.
Usa l’URL pubblico previsto senza accesso obbligatorio. Verifica separatamente le destinazioni, perché i controlli non seguono reindirizzamenti.
Attiva il monitoraggio nelle impostazioni, salva intervallo e indirizzo facoltativo; conferma accesso a pagamento idoneo e controlli recenti.
Leggi stato, ultimo controllo, esiti HTTP e dettagli. Un errore critico va indagato subito; la percentuale di 30 giorni offre contesto, non un motivo per aspettare.
Confronta l’errore con log di distribuzione, DNS, TLS, hosting e applicazione. Conferma un controllo riuscito; risolvere l’incidente non verifica ogni percorso dei visitatori.
Usa controlli ricorrenti per progetti in cui la disponibilità influenza vendite, lead, campagne, accesso dei clienti o recupero dei contenuti pubblici da parte dei crawler.
Tieni sotto controllo esterno ricorrente negozio, prenotazioni, prodotto in abbonamento o sito di acquisizione lead.
Osserva il sito pubblico che crawler e visitatori organici devono raggiungere prima che contenuti o ranking possano contare.
Monitora il sito durante lanci, migrazioni, redesign e campagne attive, quando un problema di disponibilità ha un costo immediato.
Esamina l'uptime separatamente per ogni progetto Screpy e gestisci siti cliente o brand nello stesso flusso.
Screpy offre prove HTTP esterne e storico degli incidenti per il sito configurato. Usa infrastruttura, log, test transazionali e dati di ricerca quando la domanda supera questo perimetro.
Uptime Monitoring controlla l'URL pubblico configurato per il progetto Screpy; non è un elenco generico di monitor indipendenti.
Il risultato descrive se la destinazione pubblica ha risposto. Non ispeziona CPU, memoria, container, database, reti private o log del server.
Stato HTTP, tempi e orari restringono l'analisi ma non dimostrano se la causa fosse DNS, TLS, hosting, deploy, firewall o codice.
Una pagina pubblica funzionante è necessaria a visitatori e crawler, ma un uptime elevato non garantisce indicizzazione, ranking, traffico, ricavi o conversioni.
Monitora la raggiungibilità nel tempo, analizza l'intero sito quando errori o pattern di crawling si ripetono, oppure controlla le prestazioni dopo aver stabilizzato la disponibilità.
Esamina uptime di 30 giorni basato sui controlli, risposte, esiti HTTP e incidenti dell’URL pubblico.
Scansiona il sito per trovare pagine fallite ricorrenti, problemi di redirect, destinazioni non funzionanti e pattern tecnici attorno a un problema di disponibilità.
Esegui controlli di prestazioni in laboratorio quando il sito è raggiungibile ma caricamento o reattività richiedono ancora analisi.
Documentazione di Screpy
Impara a scegliere una destinazione pubblica, configurare monitoraggio e notifiche, interpretare risposte e indagare sugli incidenti.
Risposte su campionamento, progetti inattivi, reindirizzamenti, controlli mancanti, email idonee e prestazioni delle pagine.
Un errore successivo in un incidente aperto può generare email su 404, 410, 500, 501, 502, 503, 504, 505, 507, 508, 525 o 526. Membri e indirizzo aggiuntivo distinto ricevono gli avvisi idonei. Interruzione e ripristino hanno ciascuno un limite di un’email per progetto ogni 24 ore. Un incidente soppresso non viene notificato più tardi; il ripristino richiede una notifica precedente non soppressa. Timeout, errori senza codice e altri codici non sono idonei.
Screpy registra stato, codice HTTP disponibile, risposta e data di un URL pubblico. La dashboard calcola percentuale e medie sui controlli di 30 giorni, mostra otto controlli recenti e separatamente conteggi storici e ultimi cinque incidenti.
Errori server persistenti possono rallentare la scansione e impedire il recupero dei contenuti. Un risultato disponibile non prova accesso Googlebot, destinazione dei redirect, indicizzazione o ranking. Indaga anche con dati di scansione e ricerca.
Sì. Il grafico carica fino a 160 risposte recenti di 30 giorni, meno visibili sugli schermi piccoli. La tendenza di cinque controlli differisce dalla media dei controlli riusciti dei 30 giorni. La risposta HTTP non misura rendering o interazioni.
Il primo errore apre l’incidente, i successivi lo mantengono aperto e un controllo riuscito lo risolve. La dashboard mostra stato, inizio e dettagli; le email idonee di ripristino includono la durata registrata. I campioni non individuano l’inizio esatto né ogni breve interruzione.
Le impostazioni accettano 1–60 minuti con accesso a pagamento. Entro un giorno dall’attività del team si usa quell’intervallo; dopo almeno 10 minuti e dopo sette giorni almeno 60. Dopo 30 giorni inattivi cessano i controlli pianificati. Consulta sempre l’ultima data effettiva.
HTTP 200–399 indica disponibilità, altre risposte HTTP indisponibilità; timeout ed errori sono stati distinti. Non si seguono reindirizzamenti né si verifica il contenuto: un redirect o una pagina di errore HTTP 200 può risultare disponibile senza confermare la pagina prevista.
No. Screpy controlla una destinazione HTTP(S) pubblica. Non esamina infrastruttura privata, esegue accessi o acquisti, verifica contenuti, prova disponibilità geografica o diagnostica cause. Usa log e controlli specifici.
Una suite completa di strumenti SEO a un prezzo davvero accessibile.