


Sitios de ingresos
Mantén la tienda, el sitio de reservas, el producto de suscripción o la web de captación bajo comprobaciones externas recurrentes.
Supervisa la URL pública del proyecto, revisa disponibilidad y respuestas de 30 días e investiga controles HTTP fallidos. Mantén incidentes y avisos por correo que cumplan las condiciones junto a tu trabajo SEO.
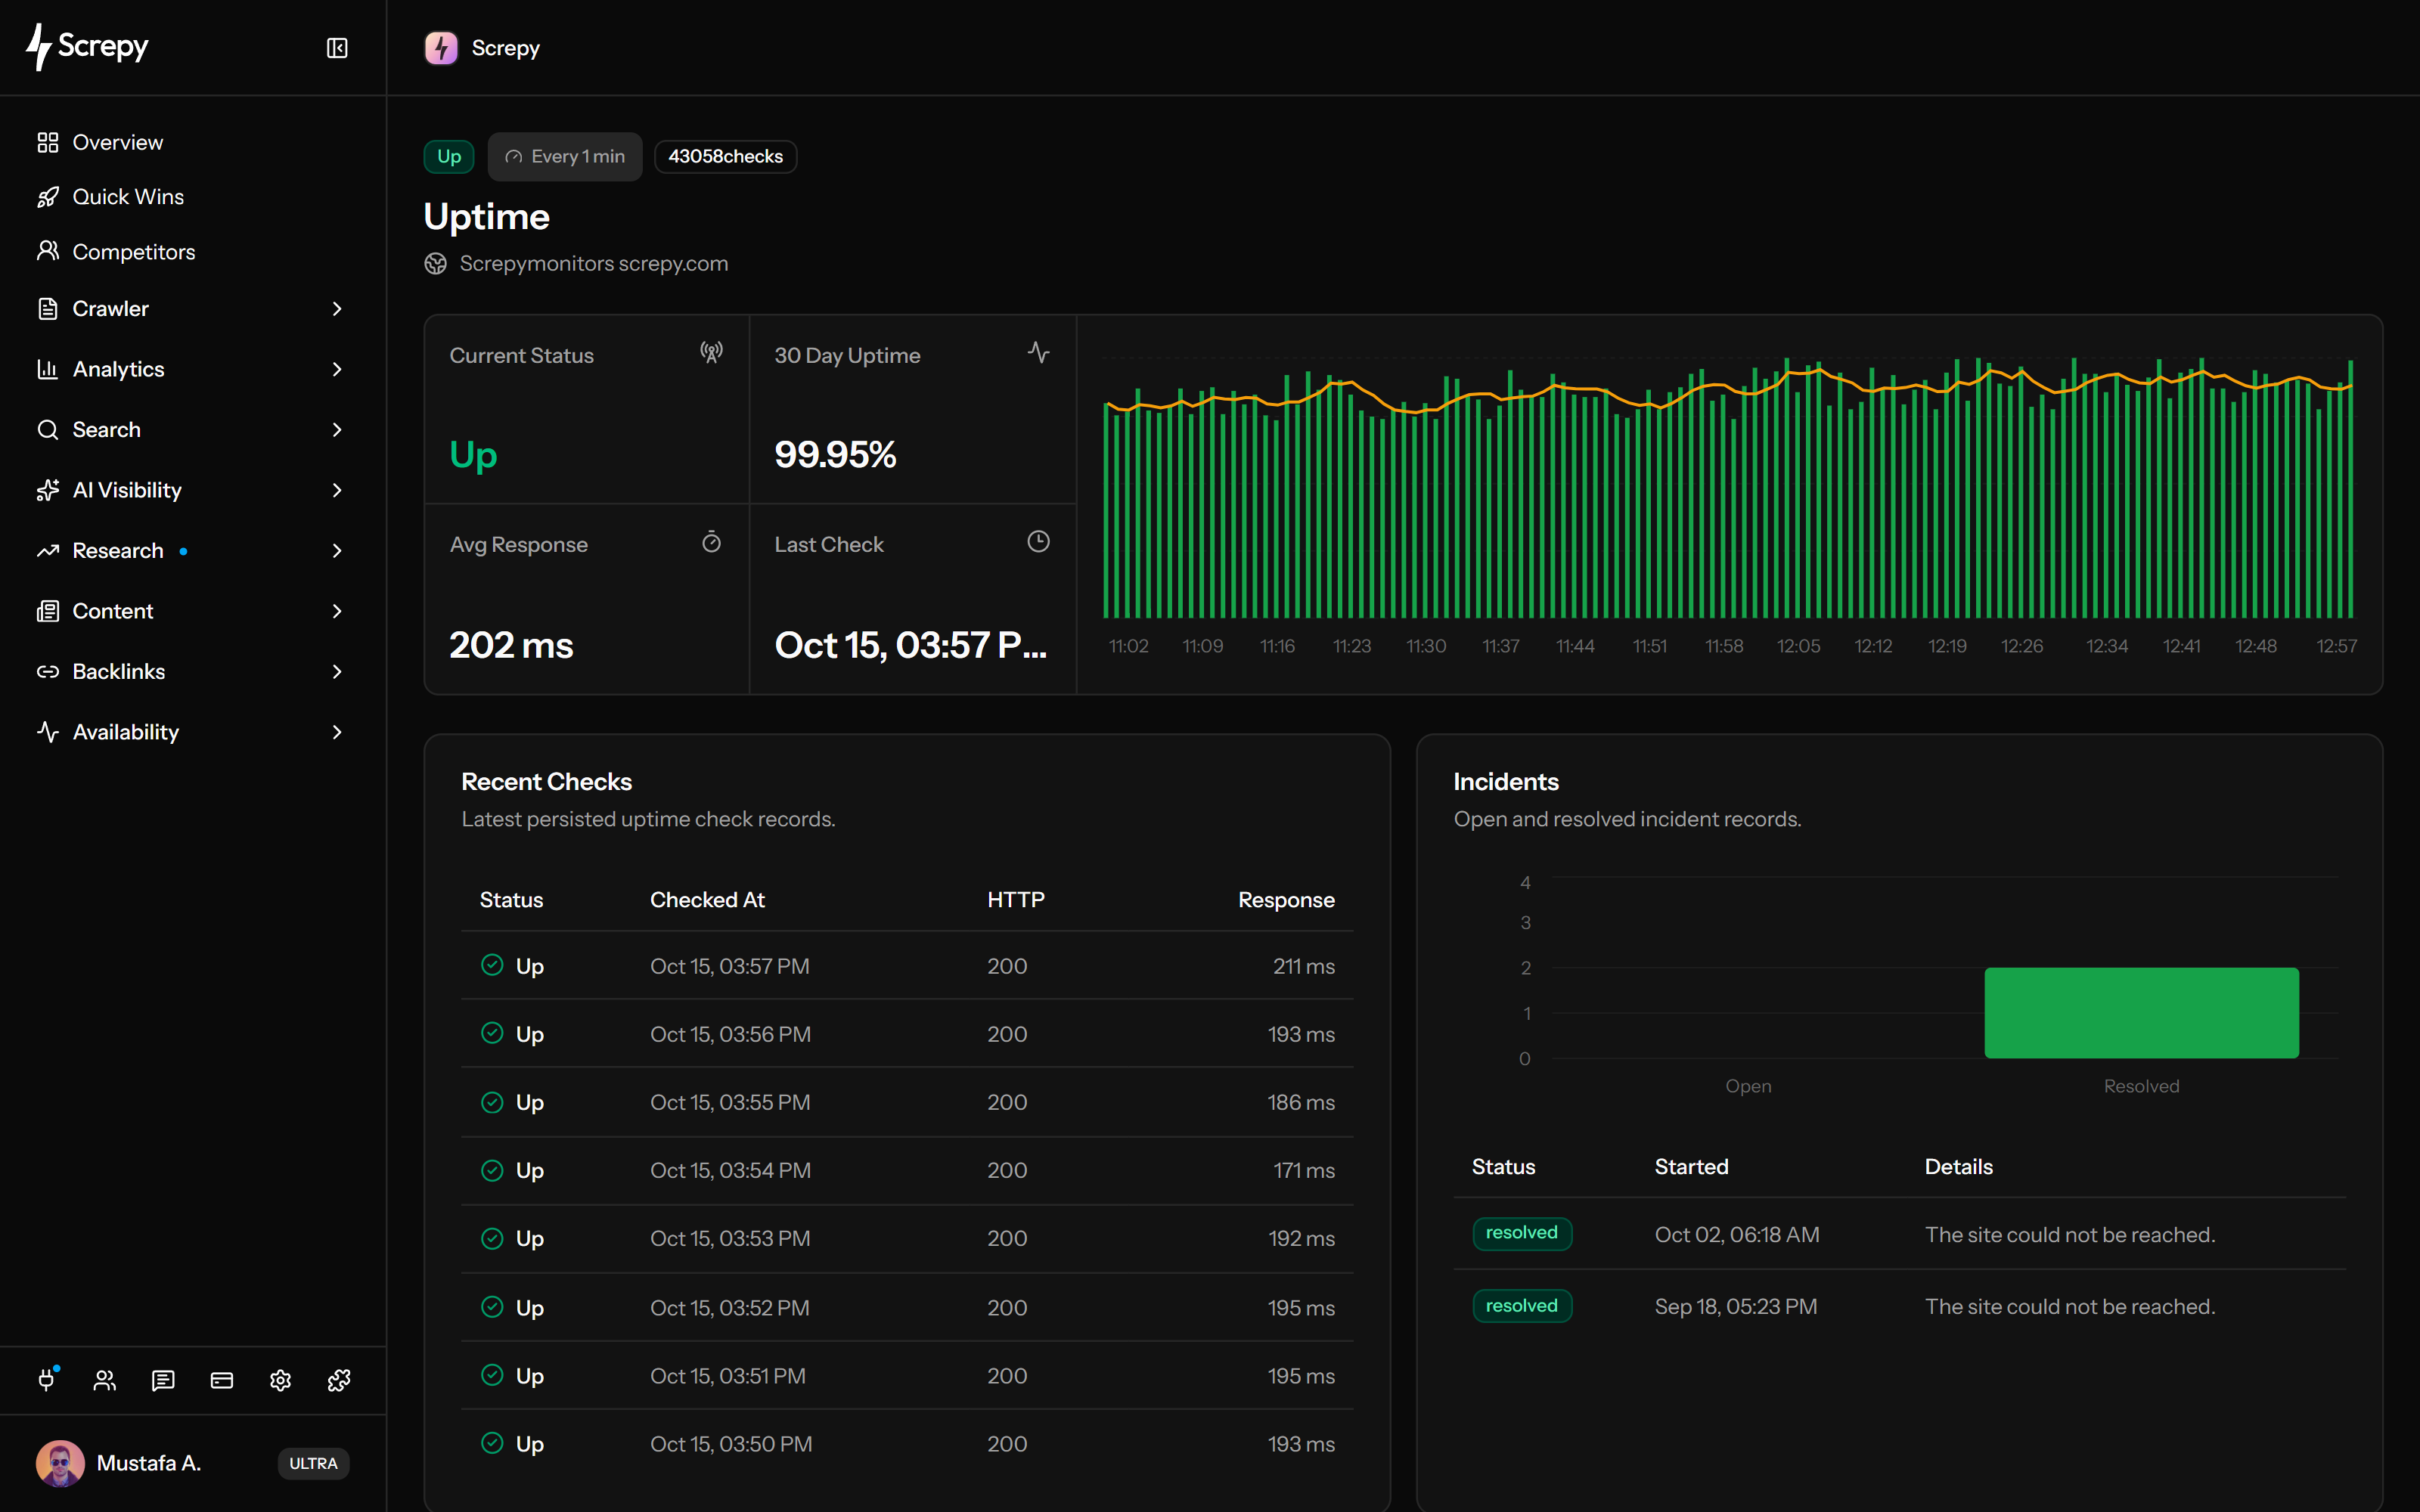


Activa controles periódicos para la URL pública guardada en tu proyecto Screpy. Elige un destino útil para los visitantes antes de definir la frecuencia.
example.com60 s
Comprueba qué proporción de controles respondió correctamente durante los últimos 30 días. Considera también el número de controles y la última fecha.
Disponibilidad
93,8 %Localiza respuestas más lentas y fallos repetidos en la gráfica. Una URL accesible también puede responder lentamente.
Tiempo de respuesta
240 msConsulta los ocho últimos controles con estado, fecha, código HTTP y tiempo de respuesta. Compáralos con la respuesta esperada de la URL pública.
Estado HTTP
200GET /HTTP/2 200Sigue un incidente desde el primer control fallido hasta uno posterior correcto. Investiga la causa por separado.
Periodo
12 minEnvía avisos que cumplan las condiciones a los miembros del proyecto y a un correo adicional opcional. El incidente se registra antes de que pueda enviarse el correo.
Proyectoexample.com
RevisiónPide a un asistente conectado que explique resultados guardados de un proyecto accesible. Usa la fecha para distinguir datos registrados de un control nuevo.
/projectsJSON{
"data": [
{ "domain": "example.com" }
]
}Incluye datos de disponibilidad en un informe guardado para un cliente o equipo. La instantánea responde a una pregunta distinta de la supervisión en directo.
aACMEInformePDF
Lee con SEO MCP disponibilidad guardada de 30 días y registros recientes de estado y respuesta. Revisa la fecha antes de interpretar el estado como disponibilidad actual; no incluye incidentes ni códigos HTTP.
Elige un destino público, activa la supervisión y configura un correo responsable. Ante un fallo, investiga los registros actuales y confirma un control posterior correcto.
Usa la URL pública prevista del proyecto. Evita rutas con inicio de sesión y verifica los destinos de redirección aparte, porque estos controles no siguen redirecciones.
Activa la supervisión en ajustes, guarda el intervalo y el correo opcional; confirma acceso de pago compatible y controles recientes.
Lee estado, último control, resultados HTTP y detalles del incidente. Investiga un fallo crítico ahora; el porcentaje de 30 días aporta contexto, no justifica esperar.
Compara el fallo con registros de despliegue, DNS, TLS, alojamiento y aplicación. Confirma un control correcto; resolver el incidente no verifica todos los recorridos de visitantes.
Usa comprobaciones recurrentes en proyectos donde la disponibilidad afecta a ventas, leads, campañas, acceso de clientes o a la recuperación de contenido público por los rastreadores.
Mantén la tienda, el sitio de reservas, el producto de suscripción o la web de captación bajo comprobaciones externas recurrentes.
Vigila el sitio público que deben alcanzar rastreadores y visitantes orgánicos antes de que importen el contenido o el posicionamiento.
Sigue el sitio durante lanzamientos, migraciones, rediseños y campañas activas, cuando un problema de disponibilidad tiene un coste inmediato.
Revisa el uptime de cada proyecto de Screpy por separado para mantener sitios de clientes o marcas en un solo flujo.
Screpy ofrece evidencia HTTP externa e historial de incidentes para el sitio configurado. Usa infraestructura, registros, pruebas de transacciones y datos de búsqueda cuando la pregunta supere ese alcance.
Uptime Monitoring comprueba la URL pública configurada para el proyecto Screpy; no es una lista general de monitores de endpoints independientes.
El resultado indica si respondió el destino público. No inspecciona CPU, memoria, contenedores, bases de datos, redes privadas ni registros del servidor.
Estado HTTP, tiempos y marcas del incidente acotan la investigación, pero no prueban si la causa fue DNS, TLS, hosting, despliegue, firewall o código.
Una página pública funcional es necesaria para visitas y rastreo, pero un uptime alto no garantiza indexación, rankings, tráfico, ingresos ni conversiones.
Monitoriza accesibilidad con el tiempo, audita el sitio cuando se repitan fallos o patrones de rastreo, o revisa rendimiento después de estabilizar la disponibilidad.
Revisa disponibilidad de 30 días basada en controles, respuestas, resultados HTTP e incidentes de la URL pública del proyecto.
Rastrea el sitio para encontrar páginas fallidas repetidas, problemas de redirección, destinos rotos y patrones técnicos alrededor de una incidencia.
Ejecuta controles de rendimiento en laboratorio cuando el sitio es accesible pero el tiempo de carga o la respuesta aún requieren investigación.
Documentación de Screpy
Aprende a elegir un destino público, configurar supervisión y avisos, interpretar respuestas e investigar incidentes.
Respuestas sobre muestreo, proyectos inactivos, redirecciones, controles ausentes, condiciones del correo y rendimiento de páginas.
Un fallo posterior de un incidente abierto puede generar correo ante 404, 410, 500, 501, 502, 503, 504, 505, 507, 508, 525 o 526. Lo reciben miembros y un correo opcional distinto. Caída y recuperación tienen límites separados de un correo por proyecto cada 24 horas. Un incidente suprimido no se notifica más tarde; la recuperación exige un aviso de caída previo no suprimido. Los tiempos de espera, errores sin código y otros códigos no cumplen las condiciones.
Los ajustes aceptan 1–60 minutos y requieren acceso de pago. Durante el día posterior a la actividad del equipo se usa ese intervalo; después, al menos 10 minutos y tras siete días, al menos 60. Tras 30 días inactivos se detienen los controles programados. Revisa siempre la última fecha real.
Los errores persistentes del servidor pueden ralentizar el rastreo e impedir recuperar contenido. Un resultado disponible no demuestra acceso de Googlebot, destino de redirección, indexación ni posiciones. Investiga también con datos de rastreo y búsqueda.
El primer fallo abre un incidente; los siguientes lo mantienen abierto y un control correcto lo resuelve. El panel muestra estado, inicio y detalles; los correos de recuperación elegibles incluyen duración registrada. Las muestras no precisan el inicio entre controles ni detectan necesariamente toda caída breve.
Screpy registra estado, código HTTP cuando existe, respuesta y fecha de una URL pública del proyecto. El panel calcula porcentaje y medias con controles de 30 días, muestra ocho controles recientes y, aparte, recuentos históricos y cinco últimos incidentes.
HTTP 200–399 cuenta como disponible y otras respuestas HTTP como caída; tiempo de espera y error son estados separados. No se siguen redirecciones ni se valida contenido: una redirección o página de error HTTP 200 puede estar disponible sin que funcione la página prevista.
Sí. Se cargan hasta 160 respuestas recientes de 30 días y se ven menos en pantallas pequeñas. La tendencia de cinco controles difiere de la media de 30 días de controles correctos. La respuesta HTTP no mide renderizado ni interacciones.
No. Screpy controla un destino HTTP(S) público. No inspecciona infraestructura privada, ejecuta inicios de sesión o compras, valida contenido, demuestra disponibilidad geográfica ni diagnostica causas. Usa registros y pruebas específicas para esas preguntas.
Un conjunto completo de herramientas SEO a un precio realmente asequible.