


Sites générateurs de revenus
Gardez boutique, site de réservation, produit par abonnement ou site de prospects sous contrôles externes récurrents.
Surveillez l’URL publique du projet, examinez disponibilité et réponses sur 30 jours et enquêtez sur les contrôles HTTP échoués. Retrouvez incidents et e-mails admissibles dans votre travail SEO.
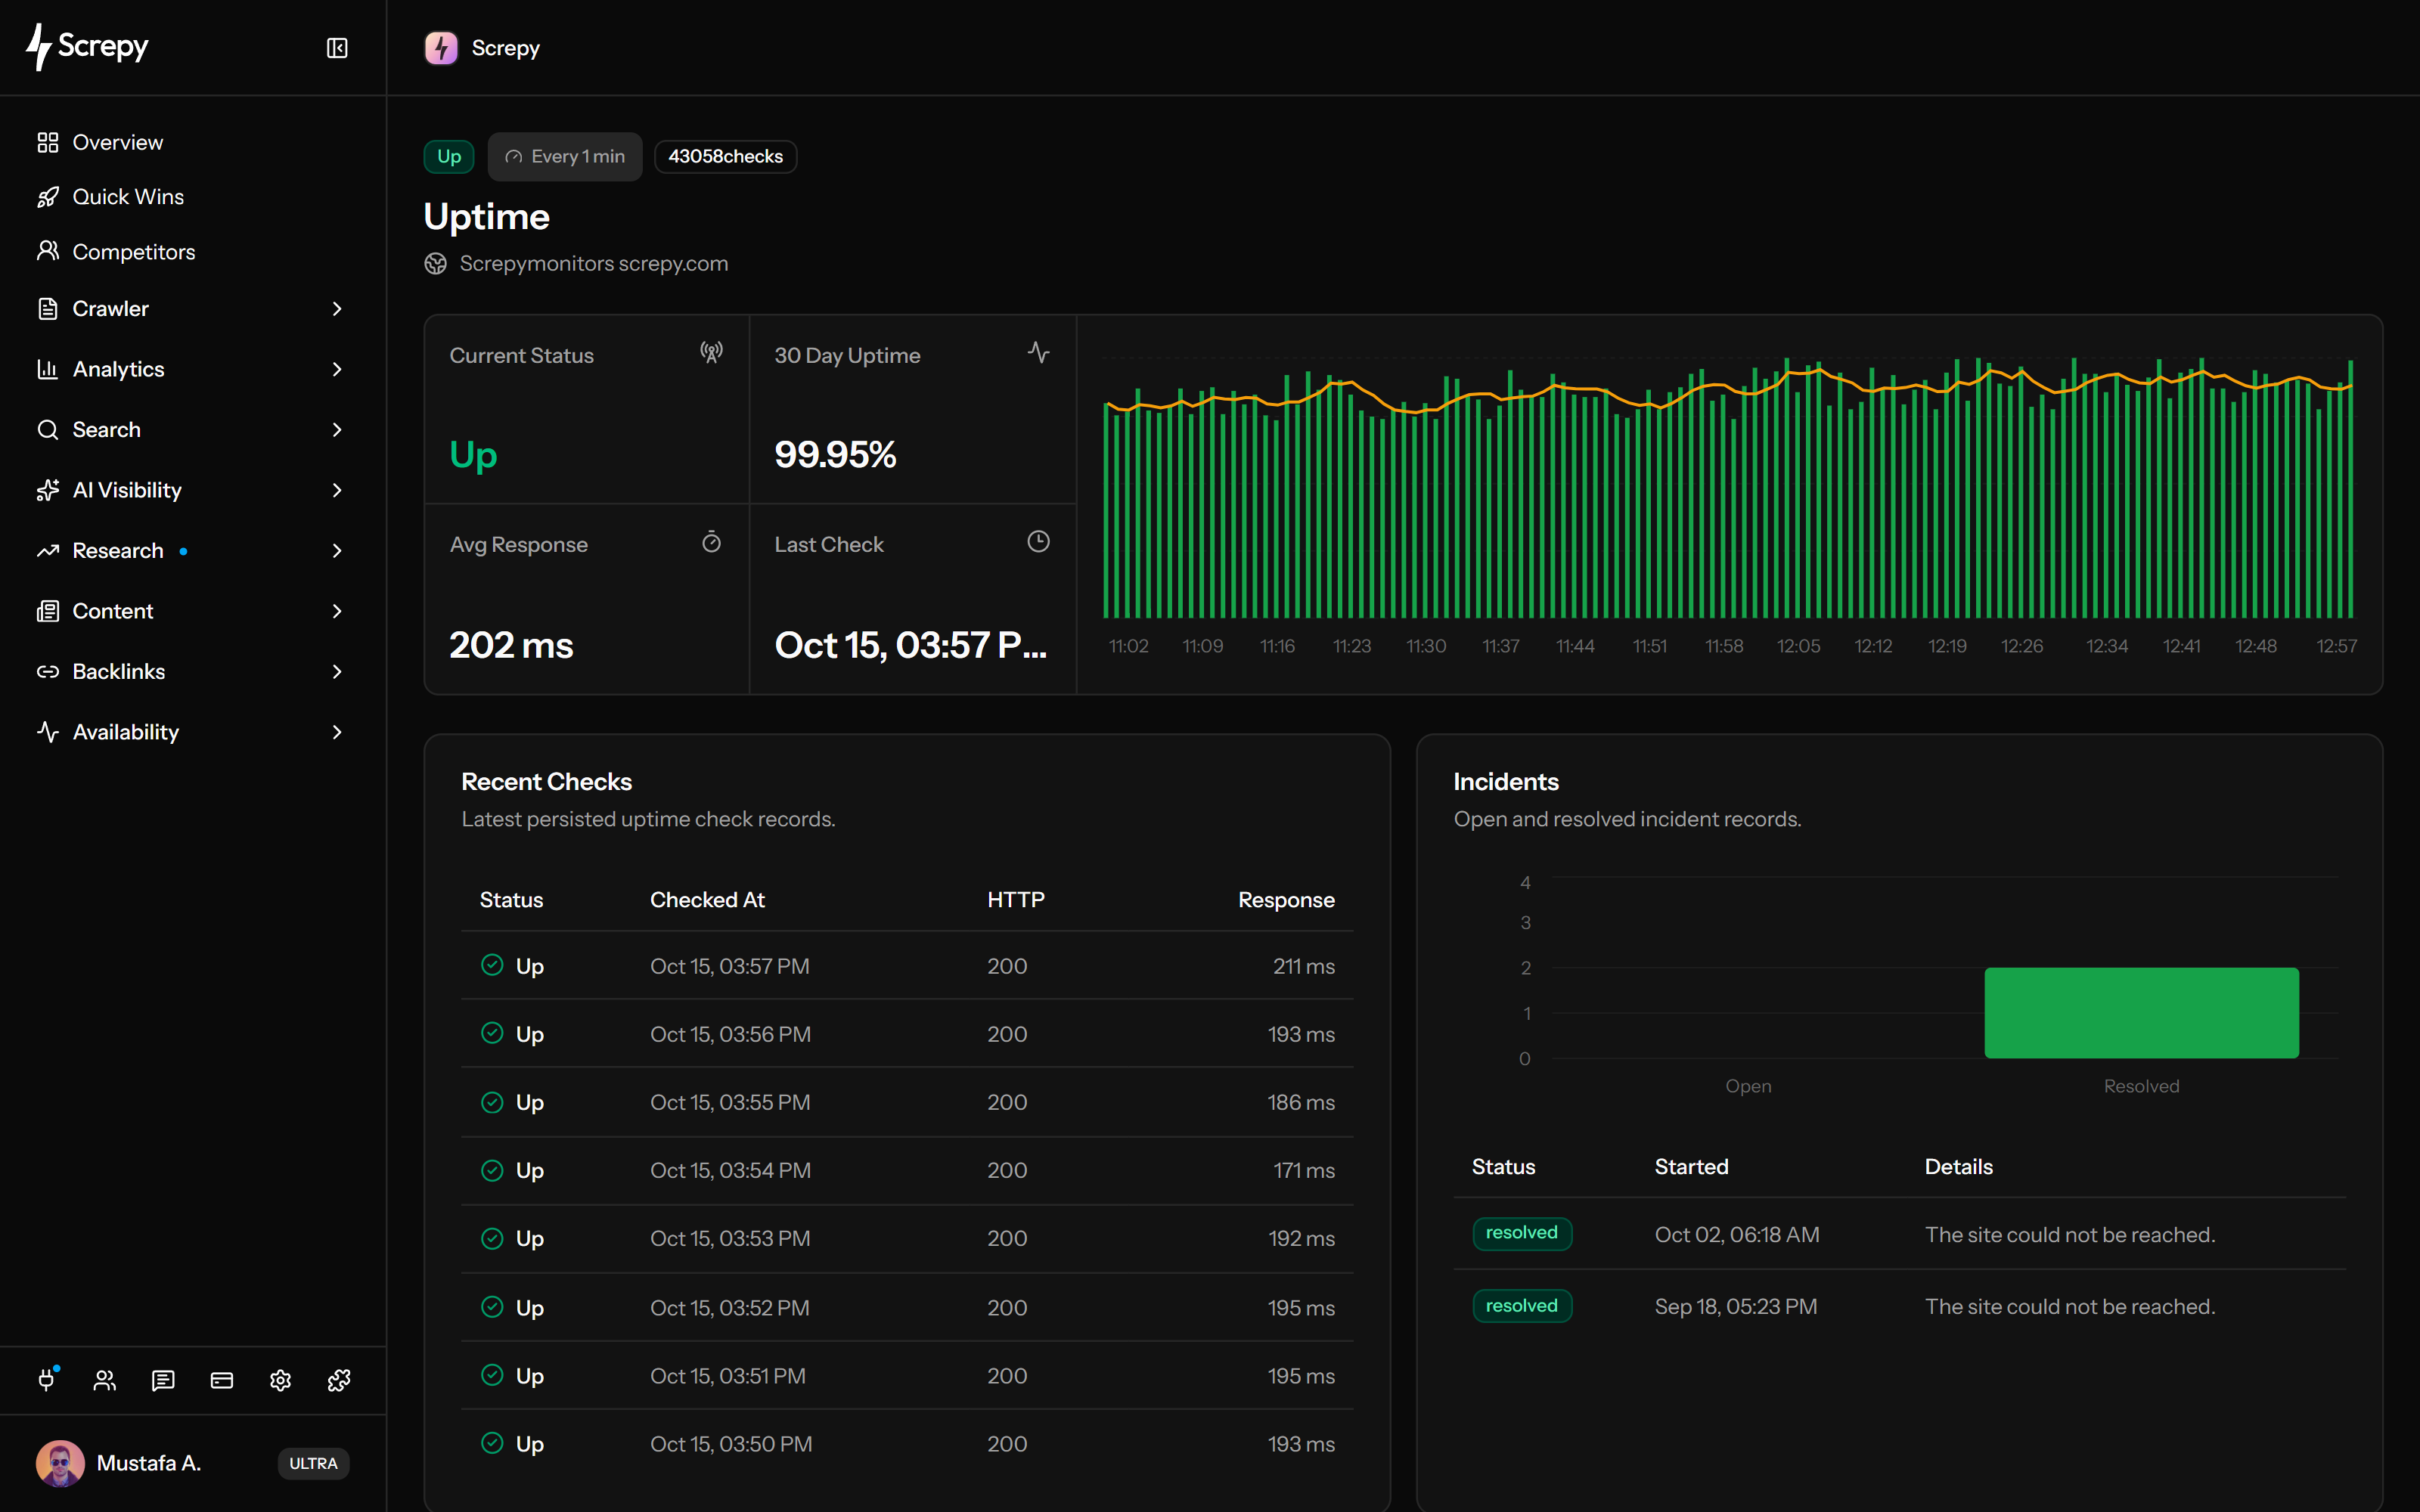


Activez les contrôles récurrents de l’URL publique du projet Screpy. Choisissez une cible utile aux visiteurs avant de fixer la fréquence.
example.com60 s
Consultez la proportion de contrôles réussis sur les 30 derniers jours. Lisez le taux avec le nombre de contrôles et leur dernière date.
Disponibilité
93,8 %Repérez les réponses lentes et les échecs répétés dans le graphique. Une URL accessible peut néanmoins répondre lentement.
Temps de réponse
240 msConsultez les huit derniers contrôles : état, date, code HTTP et réponse. Comparez-les au comportement attendu de l’URL publique.
Statut HTTP
200GET /HTTP/2 200Suivez l’incident du premier échec jusqu’à un contrôle réussi. La recherche de la cause reste une enquête distincte.
Période
12 minEnvoyez les avis admissibles aux membres et à une adresse supplémentaire facultative. L’incident est enregistré avant de devenir admissible à un e-mail.
Projetexample.com
ExamenDemandez à un assistant connecté d’expliquer les résultats enregistrés d’un projet accessible. La date distingue une observation existante d’un nouveau contrôle.
/projectsJSON{
"data": [
{ "domain": "example.com" }
]
}Partagez les observations dans un rapport enregistré pour un client ou une équipe. Un instantané diffère d’un écran de surveillance en direct.
aACMERapportPDF
Lisez via SEO MCP la disponibilité enregistrée sur 30 jours et les états/réponses récents. Vérifiez la date avant d’interpréter le dernier état comme actuel ; la réponse ne contient ni incidents ni codes HTTP.
Choisissez une cible publique, activez la surveillance et configurez une adresse responsable. Lors d’un échec, examinez les données actuelles et confirmez un contrôle réussi ultérieur.
Utilisez l’URL publique prévue sans connexion obligatoire. Vérifiez les destinations séparément : les contrôles ne suivent pas les redirections.
Activez la surveillance dans les paramètres, enregistrez intervalle et adresse facultative ; confirmez accès payant compatible et contrôles récents.
Consultez état, dernier contrôle, résultats HTTP et détails de l’incident. Examinez immédiatement une panne critique ; le taux sur 30 jours apporte du contexte, pas une raison d’attendre.
Comparez l’échec aux journaux de déploiement, DNS, TLS, hébergement et application. Confirmez un contrôle réussi ; résoudre l’incident ne valide pas tous les parcours.
Utilisez des contrôles récurrents pour les projets dont la disponibilité affecte ventes, prospects, campagnes, accès client ou récupération du contenu public par les robots.
Gardez boutique, site de réservation, produit par abonnement ou site de prospects sous contrôles externes récurrents.
Surveillez le site public que robots et visiteurs organiques doivent atteindre avant que le contenu ou le référencement puisse compter.
Suivez le site pendant lancements, migrations, refontes et campagnes actives lorsque le coût d'une indisponibilité est immédiat.
Examinez l'uptime séparément pour chaque projet Screpy afin de gérer les sites clients ou de marque dans un seul flux.
Screpy fournit des preuves HTTP externes et l'historique des incidents du site configuré. Utilisez infrastructure, journaux, tests transactionnels et données de recherche lorsque la question dépasse ce périmètre.
Uptime Monitoring vérifie l'URL publique configurée du projet Screpy ; ce n'est pas une liste générale de moniteurs de points de terminaison indépendants.
Le résultat indique si la cible publique a répondu. Il n'inspecte ni CPU, mémoire, conteneurs, bases de données, réseaux privés ni journaux serveur.
Statut HTTP, délais et horodatages réduisent le champ d'enquête mais ne prouvent pas si DNS, TLS, hébergement, déploiement, pare-feu ou code était en cause.
Une page publique fonctionnelle est nécessaire aux visiteurs et au crawl, mais un uptime élevé ne garantit ni indexation, ni classements, ni trafic, ni revenus, ni conversions.
Surveillez l'accessibilité dans le temps, auditez le site si les erreurs ou schémas de crawl se répètent, ou examinez les performances après stabilisation de la disponibilité.
Examinez disponibilité sur 30 jours fondée sur les contrôles, réponses, résultats HTTP et incidents de l’URL publique.
Explorez le site pour trouver les pages en échec récurrentes, les problèmes de redirection, les destinations cassées et les schémas techniques liés à l'incident.
Lancez des contrôles de performances en laboratoire lorsque le site est accessible mais que chargement ou réactivité nécessitent encore une enquête.
Documentation Screpy
Apprenez à choisir une cible publique, configurer surveillance et notifications, interpréter les réponses et enquêter sur les incidents.
Réponses sur échantillonnage, projets inactifs, redirections, contrôles absents, e-mails admissibles et performance des pages.
Screpy enregistre état, code HTTP disponible, réponse et date d’une URL publique. Le tableau de bord calcule disponibilité et moyennes sur 30 jours, affiche huit contrôles récents et, séparément, nombres historiques et cinq derniers incidents.
Les paramètres acceptent 1–60 minutes avec un accès payant. Dans la journée suivant l’activité de l’équipe, cet intervalle s’applique. Ensuite, au moins 10 minutes ; après sept jours, au moins 60. Après 30 jours inactifs, les contrôles planifiés cessent. Vérifiez la dernière date réelle.
Les erreurs serveur persistantes peuvent ralentir l’exploration et empêcher la récupération du contenu. Un résultat disponible ne prouve ni accès Googlebot, ni destination d’une redirection, ni indexation ou classement. Examinez aussi les données d’exploration et de recherche.
Le premier échec ouvre un incident, les suivants le maintiennent ouvert et un contrôle réussi le résout. Le tableau de bord montre état, début et détails ; les e-mails admissibles de rétablissement incluent la durée enregistrée. L’échantillonnage ne précise pas le début exact ni toutes les pannes brèves.
Un échec ultérieur d’un incident ouvert peut déclencher un e-mail pour 404, 410, 500, 501, 502, 503, 504, 505, 507, 508, 525 ou 526. Membres et adresse supplémentaire distincte reçoivent les avis admissibles. Panne et rétablissement ont chacun une limite d’un e-mail par projet et par 24 heures. Un incident supprimé n’est pas renotifié plus tard ; le rétablissement nécessite une notification de panne antérieure non supprimée. Délais expirés, erreurs sans code et autres codes ne sont pas admissibles.
HTTP 200–399 est disponible ; les autres réponses indiquent une indisponibilité. Délai expiré et erreur sont distincts. Les redirections ne sont pas suivies et le contenu n’est pas validé : une redirection ou page d’erreur HTTP 200 peut être disponible sans confirmer la page attendue.
Oui. Jusqu’à 160 réponses récentes sur 30 jours alimentent le graphique, avec moins de points visibles sur petit écran. La tendance de cinq contrôles diffère de la moyenne des contrôles réussis sur 30 jours. La réponse HTTP ne mesure ni rendu ni interactions.
Non. Screpy contrôle une cible publique HTTP(S), sans inspecter l’infrastructure privée, exécuter connexion ou achat, valider le contenu, prouver une disponibilité géographique ou diagnostiquer la cause. Utilisez journaux et contrôles dédiés.
Une boîte à outils SEO complète à un prix vraiment abordable.