Vérificateur groupé de l’état d’indexation Google

Auditez les URL explorables d’un crawl de site terminé face à la vue indexée de Google, regroupez les pages indexées et non indexées par motif de couverture et analysez chaque résultat avec mots, titres, liens internes et profondeur de crawl.

Vérifier l’indexation du site Lire le guide de l’audit
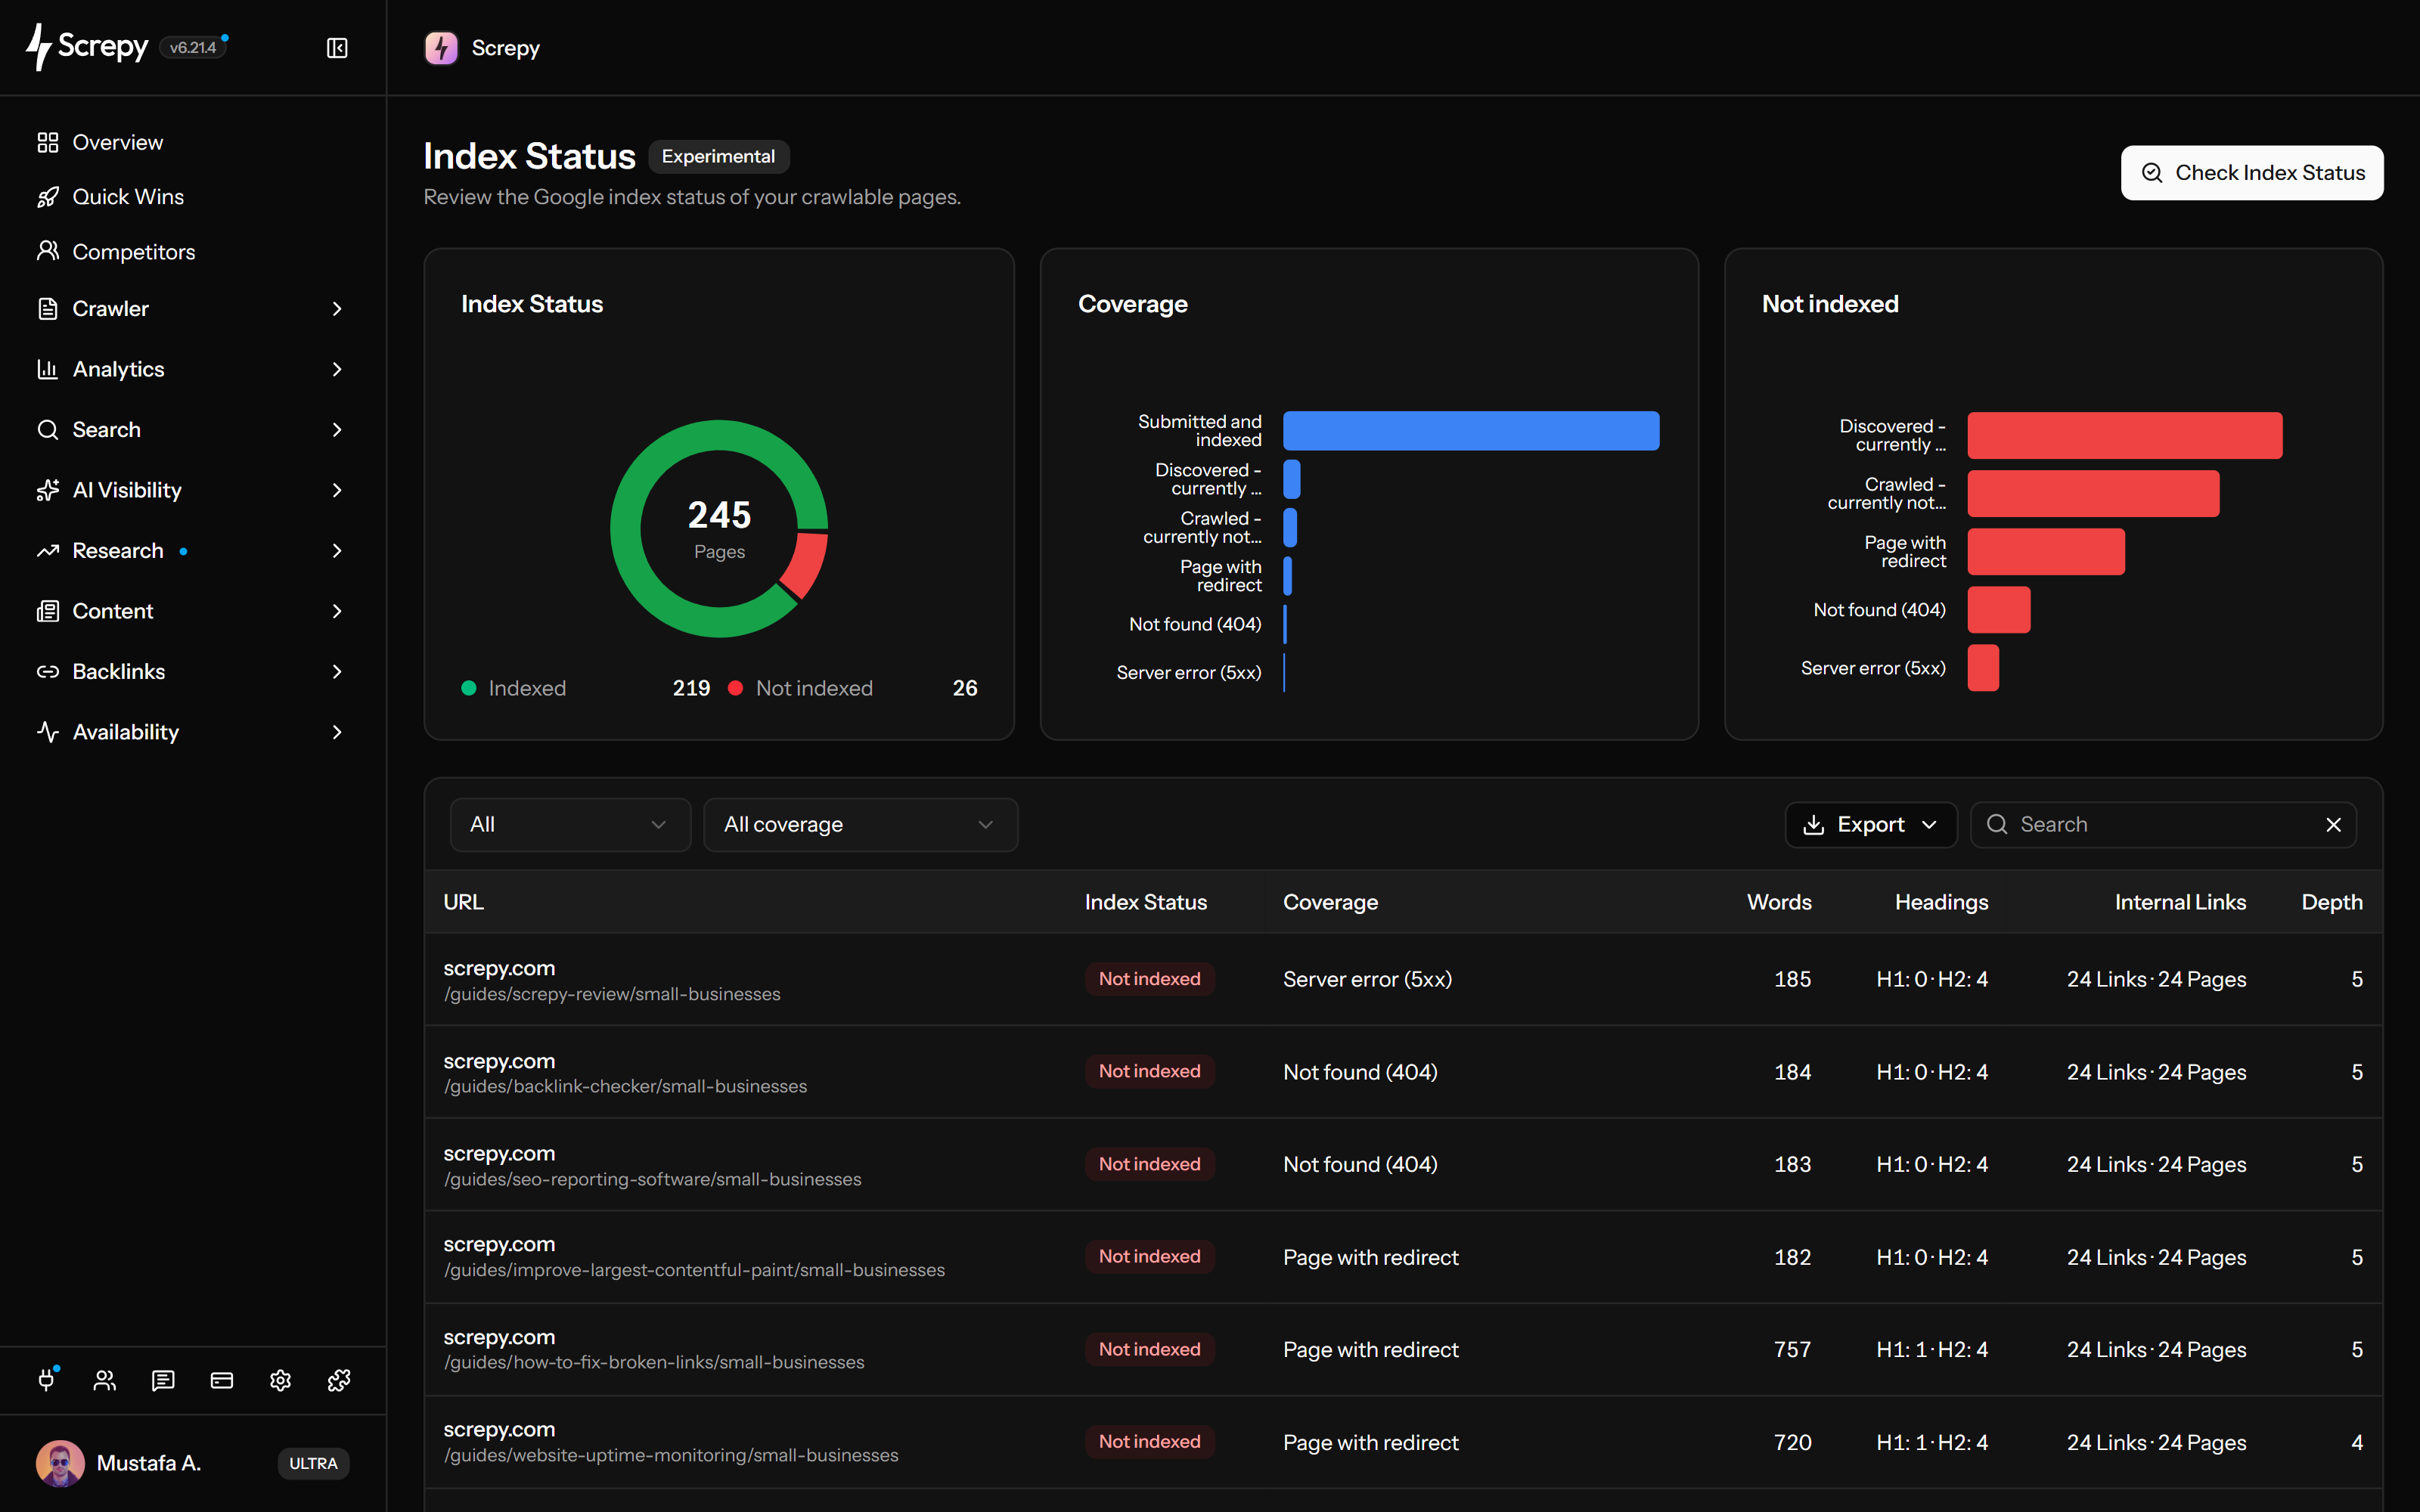
Tableau d'état d'indexation Screpy avec URL des pages, couverture de l'index Google et détails des statuts
Logo Uber dans la section de confiance client de la plateforme SEO Screpy
Logo Philips dans la section de confiance client de la plateforme SEO Screpy
Logo FedEx Express dans la section de confiance client de la plateforme SEO Screpy
Logo Bosch dans la section de confiance client de la plateforme SEO Screpy
Logo Champion dans la section de confiance client de la plateforme SEO Screpy
Logo Iconfinder dans la section de confiance client de la plateforme SEO Screpy
Logo T-Mobile dans la section de confiance client de la plateforme SEO Screpy
Logo Carrefour dans la section de confiance client de la plateforme SEO Screpy
Logo Stanley dans la section de confiance client de la plateforme SEO Screpy
Logo Skoda dans la section de confiance client de la plateforme SEO Screpy

Vérifiez l’indexation Google

Commencez par le dernier crawl du projet terminé avec succès et la propriété Google Search Console correspondante. Screpy vérifie les URL admissibles selon la vue indexée de Google : les résultats décrivent les pages inspectées, pas toutes les URL du site.

  • Le crawl fournit les pages répondant en 2xx, sans canonical ou dont le canonical correspond à l’URL finale.
  • L’URL finale est utilisée lorsqu’elle est disponible ; les URL hors de la propriété connectée sont ignorées.
  • Le tableau et le résumé d’indexation contiennent les inspections terminées, pas les demandes en attente, ignorées ou en échec.
  • Un résultat indexé ne garantit ni classement, ni clics, ni présence pour une requête précise.

Trouvez les pages non indexées

Limitez les résultats aux pages importantes qui devraient apparaître dans Google Search. Combinez état d’indexation, couverture et recherche d’URL pour examiner une catégorie de produits, un dossier d’articles ou une page de destination sans considérer chaque exclusion comme un défaut.

  • Choisissez Toutes, Indexées ou Non indexées et combinez ce choix avec un motif de couverture disponible.
  • Recherchez une URL complète ou un chemin commun pour analyser des pages liées dans le même audit.
  • Décidez si chaque page doit être indexée ; les exclusions volontaires et les variantes dupliquées peuvent être légitimes.

Examinez les motifs de couverture

Le résumé sépare les inspections indexées et non indexées, détaille les états de couverture disponibles et présente les motifs des pages non indexées. Les motifs récurrents aident à choisir les modèles ou groupes d’URL à examiner en premier.

  • Lisez le motif renvoyé à côté de chaque URL ; son absence signifie une information indisponible, pas un diagnostic.
  • Comparez les pages partageant le même motif et leur rôle avant de choisir une correction commune.
  • Vérifiez les conditions actuelles avec Website Audit et la page en ligne ; le libellé de couverture décrit la vue indexée de Google.

Examinez les données de crawl

Gardez les données du crawl à côté du résultat d’indexation pendant l’analyse. Mots, nombres de H1/H2, liens internes entrants, pages sources et profondeur viennent du crawl utilisé par cet audit ; ils peuvent différer du dernier état traité par Google.

  • Comparez les nombres de mots et de titres entre pages similaires ; ces nombres seuls ne mesurent pas la qualité du contenu.
  • Distinguez le nombre d’occurrences des liens entrants du nombre de pages sources qui pointent vers l’URL.
  • Utilisez la profondeur pour examiner la distance entre une page importante et le point de départ du crawl.
  • Un tiret indique une métrique indisponible ; examinez la page dans Website Audit avant de conclure.

Reprenez les audits d’indexation

Un grand audit peut atteindre la limite quotidienne d’inspection ou nécessiter une reconnexion à Google. Reprendre l’audit est disponible pour les exécutions interrompues admissibles et conserve les inspections terminées au lieu de recommencer toute l’analyse.

  • Continuez avec la même propriété Search Console et le périmètre de crawl de l’audit initial.
  • Revenez lorsque la capacité d’inspection est disponible ou reconnectez Google si l’autorisation doit être renouvelée.
  • La reprise traite le travail restant ; elle n’actualise pas les lignes déjà inspectées et ne relance pas un audit terminé.

Exportez les résultats d’indexation

Téléchargez un fichier CSV ou Excel ciblé après avoir appliqué les filtres utiles. L’export utilise la page du tableau actuellement chargée, avec 50 lignes au maximum ; il convient à une transmission pour analyse, pas au téléchargement de l’audit complet.

  • Le fichier contient l’URL, l’indicateur d’indexation, le motif de couverture, le nombre de mots et la profondeur de crawl.
  • Les cellules combinées de titres et de liens internes sont visibles dans le tableau de bord, mais absentes de cet export.
  • Vérifiez les filtres et la page actuelle avant de télécharger ; les autres pages de résultats ne sont pas ajoutées automatiquement.

Vérifiez les changements d’indexation

Après avoir corrigé une page à indexer, terminez un nouveau crawl du site et lancez un nouvel audit lorsque cela est possible. Reprendre un ancien audit conserve ses inspections ; en lancer un nouveau ne promet pas de changement immédiat des informations Google.

  • Un projet peut lancer un nouvel audit d’indexation toutes les 5 heures ; il faut d’abord résoudre l’audit actif.
  • Pour les URL récemment vérifiées, les mêmes informations d’inspection peuvent être réutilisées pendant 24 heures au maximum.
  • Laissez à Google le temps de traiter la page, puis évaluez la visibilité séparément avec les performances Search Console.

Parlez de État d’indexation. Avec SEO MCP.

Examinez les audits Index Status existants et leurs URL avec SEO MCP. Interrogez les pages concernées et les preuves d’inspection d’URL disponibles dans Search Console ; MCP ne lance pas de nouvel audit.

  1. Screpy: Bonjour ! Regardons État d’indexation pour example.com. Que souhaitez-vous savoir ?
  2. Vous: Quelles URL nécessitent un examen dans mon audit Index Status existant ?
  3. Screpy: Commencez par les URL signalées à examiner puis vérifiez leurs preuves. Un audit enregistré est un instantané, pas une garantie de l’index Google actuel. Preuves d’indexation: Audit existant: Enregistrements d’URL conservés. Inspection d’URL: Données Search Console disponibles.
  4. Vous: Transforme cela en un court plan d’action.
  5. Screpy: Je séparerai les constats des recommandations. Examinez les preuves, choisissez une modification puis vérifiez les résultats. Vos prochaines étapes: Examiner: Vérifier la source et la date de chaque constat.. Décider: Choisir la première modification.. Vérifier: Comparer les résultats après la modification..
  6. Vous: Peux-tu expliquer les preuves simplement ?
  7. Screpy: Oui. Interrogez-moi sur un résultat pris en charge pour comprendre ce qu’il montre, sa source et les incertitudes. Les données manquantes restent indisponibles ; les recommandations ne sont pas des corrections automatiques.

Transformez un contrôle groupé en analyse ciblée des pages.

Définissez les URL qui devraient être indexées, lancez l’audit sur un crawl connu, regroupez les états de couverture répétés et utilisez le contexte de page avant de décider quoi changer.

  1. Définir les URL qui doivent être indexées

    Commencez par le rôle de la page. Identifiez les URL canoniques de produits, services, catégories, articles ou campagnes destinées à la recherche, puis séparez doublons, redirections, filtres et pages volontairement exclues.

  2. Connecter la bonne propriété et terminer un crawl

    Connectez la propriété Search Console correspondant au projet. Un nouvel audit utilise automatiquement le dernier crawl du site terminé avec succès ; terminez d’abord un nouveau crawl si le site a changé.

  3. Lancer l’audit d’état d’indexation

    Lancez l’audit et examinez les lignes inspectées lorsqu’elles sont disponibles. Utilisez le résumé indexées/non indexées et les graphiques de couverture ; suivez les messages de limite ou de reconnexion et reprenez lorsque l’audit est admissible.

  4. Regrouper les preuves avant d’ouvrir les URL

    Commencez par les totaux indexées et non indexées, puis utilisez les graphiques de couverture et de motifs. Filtrez par état, couverture, URL complète ou chemin commun pour trouver les comportements répétés.

  5. Examiner la page et vérifier ensuite

    Comparez le contexte du crawl au motif de couverture et au rôle de la page. Corrigez uniquement les pages à indexer, terminez un nouveau crawl et lancez un nouvel audit lorsque possible. Tenez compte des informations d’inspection réutilisées et du délai de traitement de Google.

Utilisez l’état d’indexation lorsque importance des pages et motifs se rejoignent.

L’audit est le plus utile pour réduire un grand crawl aux URL prioritaires, aux motifs de couverture communs, aux chemins de découverte faibles ou aux groupes de pages comparables.

Protéger les pages stratégiques

Recherchez les URL importantes de produits, services, catégories, emplacements ou articles et vérifiez que leur état d’indexation correspond à leur rôle dans la découverte organique.

  • Revue des URL prioritaires
  • État indexé par rapport à l’état attendu
  • Preuves au niveau de la page

Trouver les motifs de couverture répétés

Regroupez les URL non indexées par motif Google disponible et examinez les templates ou chemins communs avant de traiter chaque page comme un problème distinct.

  • Regroupement de couverture
  • Motifs de template
  • Analyse de la cause commune

Examiner les chemins de découverte faibles

Utilisez les liens internes entrants, le nombre de pages sources et la profondeur de crawl pour voir si une URL importante est difficile à découvrir dans la structure explorée.

  • Liens internes entrants
  • Pages sources faisant un lien
  • Profondeur de crawl

Examiner le contexte du contenu avec l’état

Comparez les mots et le nombre de titres de pages similaires pour identifier les pages légères, incohérentes ou étonnamment vides qui méritent une analyse plus poussée.

  • Mots
  • Nombres de H1 et H2
  • Groupes de pages comparables

Interprétez l’index Google sans transformer chaque état en erreur.

L’indexation est nécessaire pour être éligible à la recherche, mais un état seul n’explique ni la valeur de la page, ni son indexabilité actuelle, ni son potentiel de classement, ni la bonne action technique.

Non indexée ne signifie pas toujours défectueuse

Doublons, URL alternatives, redirections et pages volontairement exclues peuvent rester correctement hors de l’index. Décidez d’abord si l’URL doit être indexée.

Indexée ne garantit pas la visibilité

Une page indexée peut apparaître, mais le résultat ne promet ni classement, ni impressions, ni clics, ni présence pour une requête donnée.

Le résultat est la vue indexée de Google

L’audit ne réalise pas de test d’URL en direct. Une modification récente du contenu, d’une directive, d’un canonical ou du serveur peut ne pas apparaître dans les informations renvoyées.

L’audit utilise un périmètre connu

Screpy vérifie les URL explorables du crawl terminé sélectionné, pas toutes les URL historiques ou externes connues de Google. Les quotas d’inspection peuvent aussi interrompre un grand audit.

Choisissez le workflow qui répond à votre question d’indexation.

Utilisez l’état d’indexation pour la vue indexée de Google sur les URL explorées, Website Audit pour les signaux actuels du crawl et de la page et Search Console pour les performances observées.

Documentation Screpy

Apprendre à analyser l’état d’indexation

Utilisez le guide Screpy pour examiner les URL indexées et non indexées, analyser les motifs de couverture et valider les changements.

Lire le guide de l’état d’indexation

FAQ du vérificateur d’état d’indexation Google

Comprenez ce qu’un audit d’état d’indexation rapporte, ce dont il a besoin et la place de son résultat dans votre workflow SEO.

Puis-je reprendre un audit incomplet ?

Oui. Lorsqu’un audit peut être repris, utilisez Reprendre l’audit pour continuer la même vérification sans supprimer sa progression. Une limite d’inspection quotidienne ou une interruption peut nécessiter un retour ultérieur.

Screpy demande-t-il l’indexation à Google ?

Non. L’état d’indexation rapporte les informations d’index Google pour les URL auditées. Il n’envoie pas de demande d’indexation, ne force pas Google à crawler une page et ne garantit pas qu’une URL apparaîtra dans les résultats.

Toute URL non indexée est-elle un problème SEO ?

Non. Les URL dupliquées, alternatives, redirigées, volontairement en noindex ou inutiles peuvent rester correctement hors de l’index. Décidez si l’URL doit être indexée avant de traiter son motif comme un problème.

L’audit inclut-il toutes les URL connues de Google ?

Non. Un nouvel audit part des pages 2xx du dernier crawl réussi, sans canonical ou avec un canonical correspondant à l’URL finale. Seules les URL dans la propriété connectée sont inspectées. Certaines URL explorées sont donc exclues ; ce n’est pas l’inventaire complet de Google. Une URL absente des résultats n’est pas automatiquement non indexée : elle peut être hors périmètre, en attente, ignorée ou avoir une inspection en échec.

L’état d’indexation effectue-t-il un test d’URL en direct ?

Non. L’audit vérifie la version représentée dans l’index Google via la propriété Search Console connectée. Il ne teste pas la page en ligne actuelle et ne prouve pas qu’une modification récente a déjà été traitée.

Que vérifie l’état d’indexation Screpy ?

L’état d’indexation Screpy compare les URL explorables d’un crawl de projet terminé aux informations d’index de la propriété Google Search Console connectée. Il rapporte les états indexées et non indexées, les motifs de couverture disponibles et le contexte de crawl associé.

Que faut-il pour un audit d’état d’indexation ?

Le projet nécessite une propriété Google Search Console connectée et accessible ainsi qu’un crawl réussi. Un nouvel audit utilise automatiquement le dernier crawl réussi. Un seul audit peut être actif ; un nouvel audit peut être lancé toutes les 5 heures.

L’état d’indexation Screpy est-il expérimental ?

Le tableau de bord indique actuellement que l’état d’indexation est expérimental. Les états d’audit et les informations de couverture Google peuvent évoluer ; validez les résultats importants avec la page actuelle, Search Console et un crawl récent.

Pourquoi une page indexée peut-elle rester peu visible ?

Être indexée signifie que Google possède une version de la page dans son index ; cela ne garantit ni classement, ni impressions, ni clics ni position précise. Examinez la page, son intention, ses conditions techniques et ses performances avant d’agir.