

Éditeurs et bibliothèques de contenu
Vérifiez si des familles vérifiées de robots de recherche et d'IA demandent le site et si des chemins importants renvoient des réponses non 2xx.
Connectez la zone Cloudflare associée à votre projet Screpy et examinez les sept derniers jours d'activité vérifiée des bots. Comparez catégories de robots, éditeurs, données transférées, tendances des requêtes, réponses réussies et URL non 2xx sans confondre une visite de robot avec une citation IA.
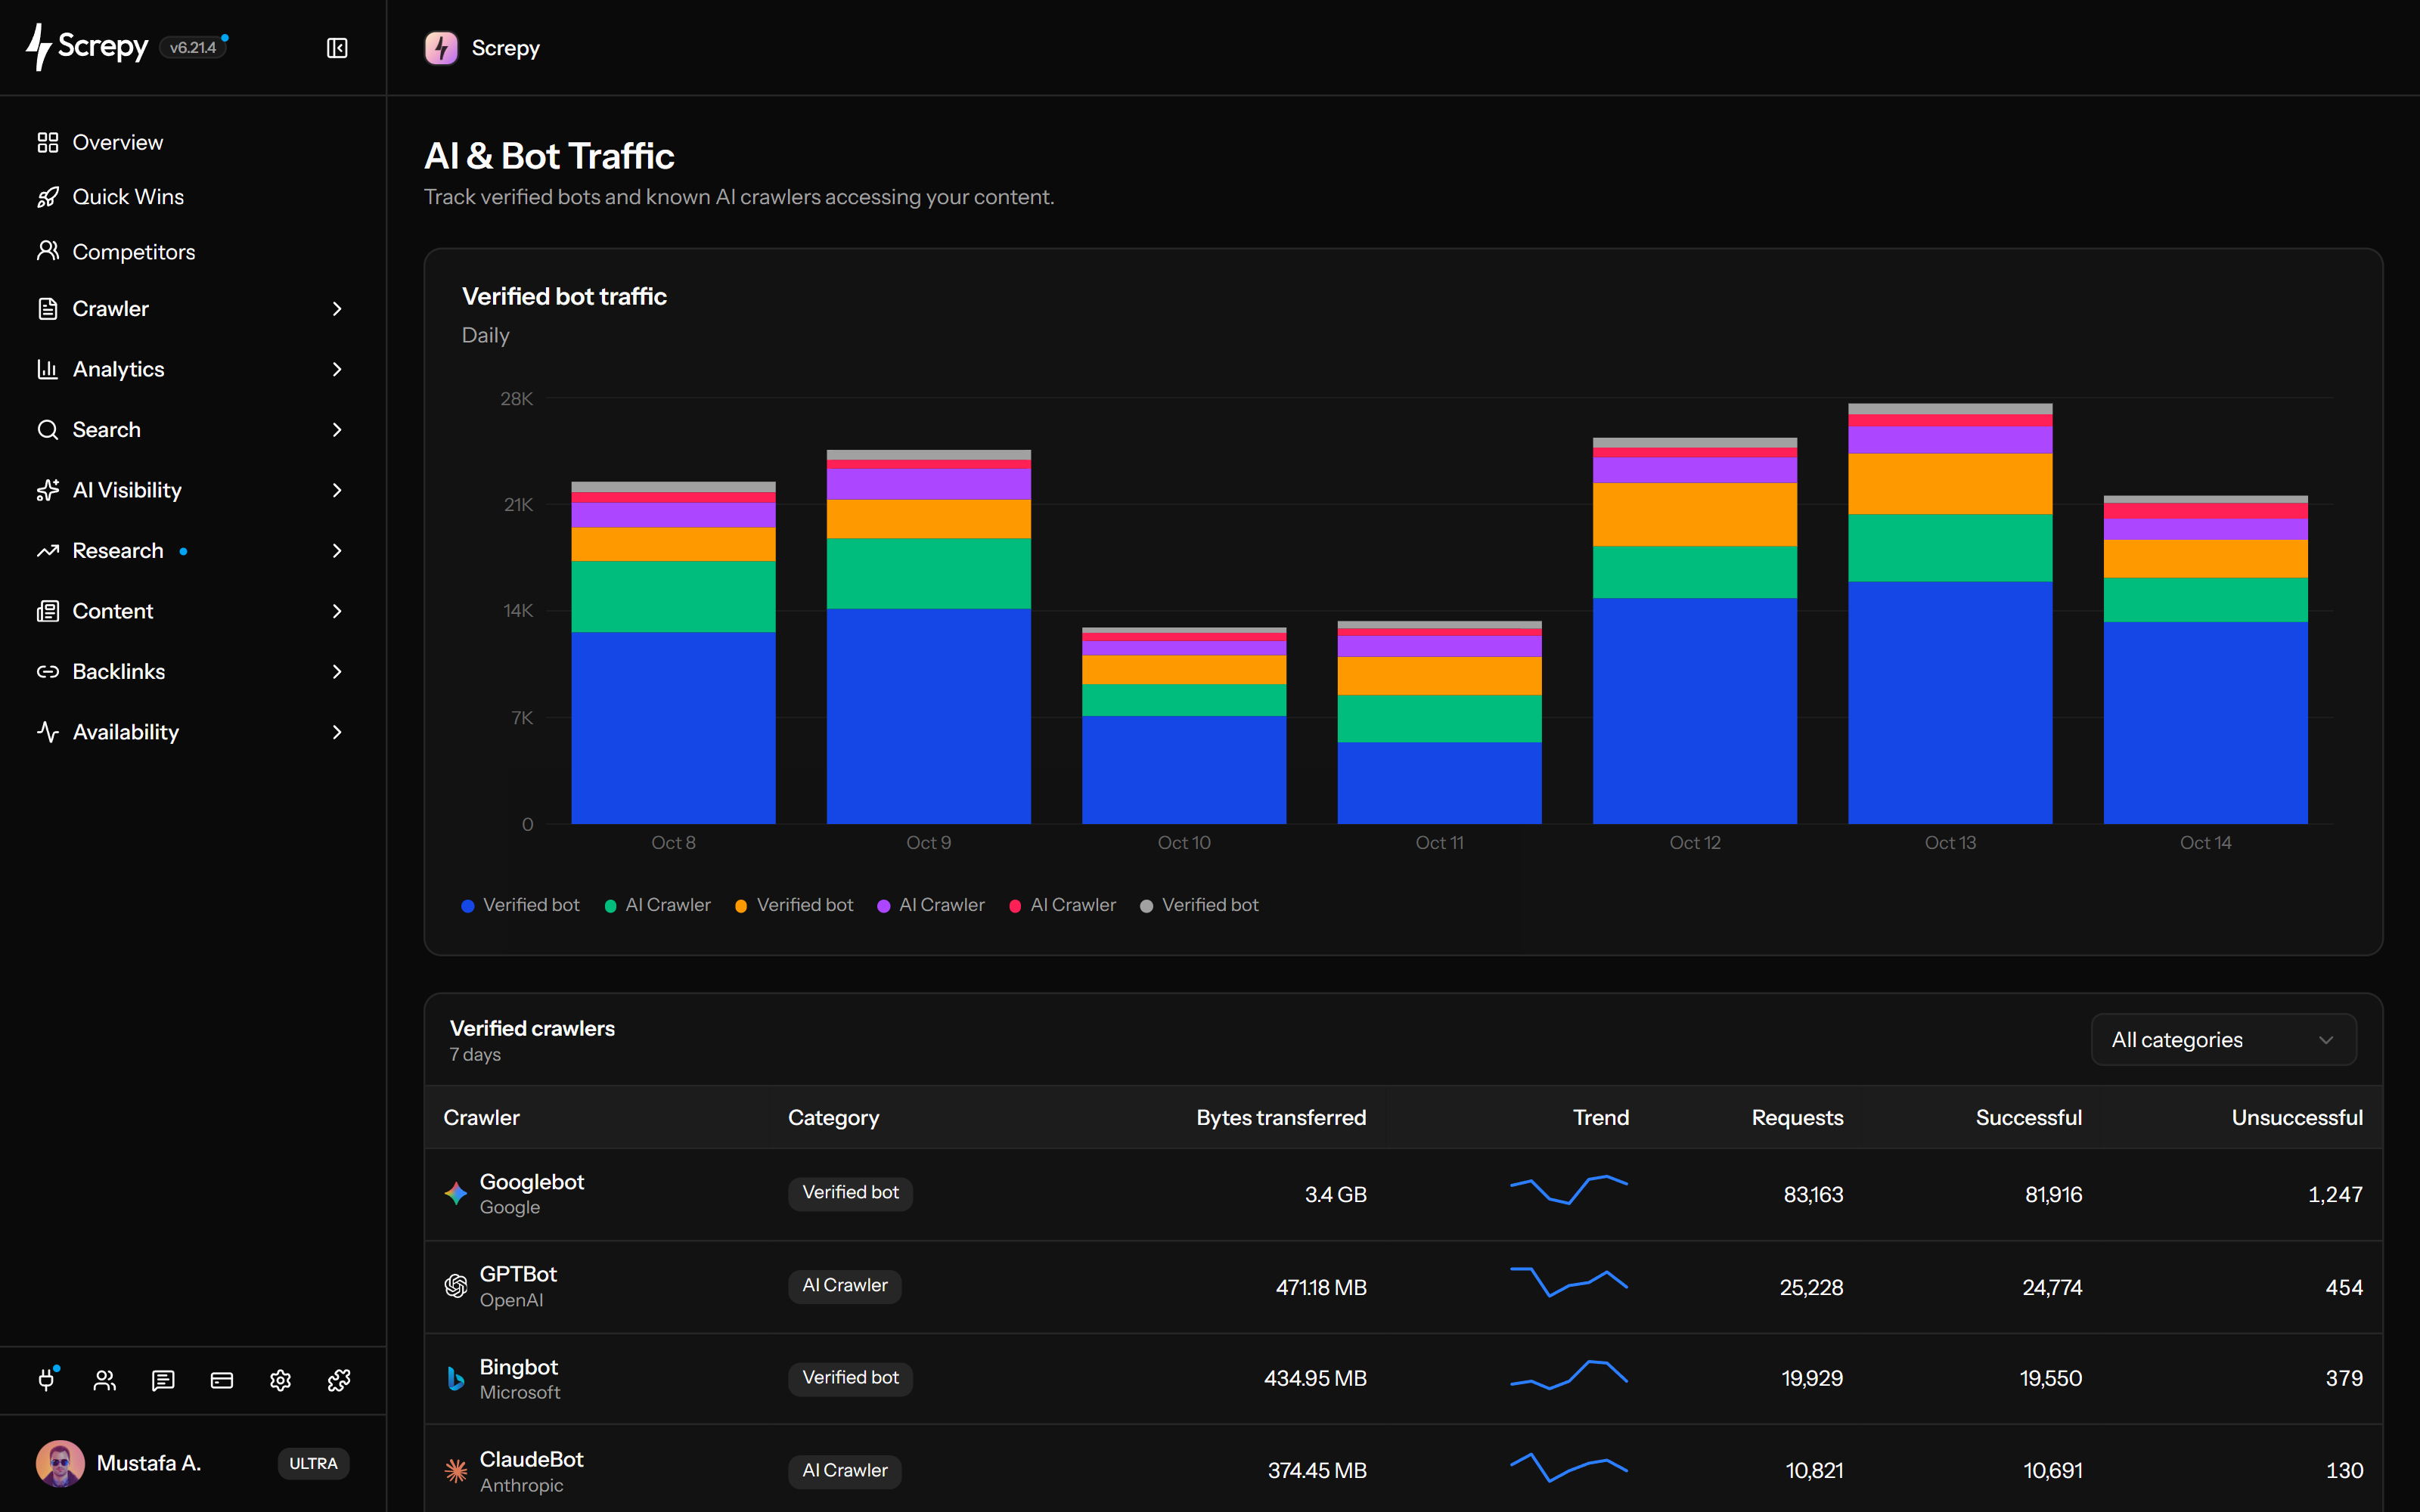


Connectez Cloudflare pour consulter les requêtes de bots vérifiés de la zone associée à votre projet Screpy. Vérifiez la connexion et le périmètre avant d’interpréter une table vide.
 Screpy
Repérez les familles de robots de recherche et d’IA présentes dans les données connectées. Le nom et l’éditeur permettent de savoir qui a envoyé des requêtes avant d’en examiner le volume ou les réponses.
Requêtes
42Repérez les concentrations de requêtes dans le graphique des catégories, puis examinez les mini-graphiques des robots sur les mêmes sept jours. La vue actuelle utilise une période fixe sans sélection libre de dates.
Requêtes
1 860Lisez ensemble le nombre de requêtes et les octets transférés. Ils décrivent le volume de trafic et la taille des réponses, pas des personnes uniques, la popularité des réponses IA ou la valeur du contenu.
Distinguez la classification d’une réponse de son diagnostic. La colonne des requêtes échouées comprend toutes les réponses hors 2xx ; un nombre élevé ne signifie pas à lui seul que le site est défaillant.
Statut HTTP
200GET /HTTP/2 200Ouvrez le nombre hors 2xx d’un robot pour voir les chemins ayant reçu ces réponses. Le chemin, le statut et la fréquence donnent aux équipes SEO ou techniques un point de départ concret.
SélectionnéGPTBot
| Chemin d’URL | Statut HTTP | Requêtes |
|---|---|---|
/guides/seo | 404 | 128 |
/guides/seo | 301 | 36 |
/setup | 503 | 12 |
Interrogez via SEO MCP les Quick Wins issus des données disponibles de recherche, de crawl et du trafic Cloudflare connecté. L’accès couvre ces opportunités, pas tout le tableau de bord d’analytique ou de trafic des bots.
Commencez par les catégories les plus actives, choisissez un robot et examinez les chemins hors 2xx récurrents. Vérifiez la réponse attendue avant de transmettre un problème précis de route ou d’accès à l’équipe responsable.
Utilisez un jeton API actif capable de lister la zone et de lire les analyses, puis confirmez que le domaine du projet possède une zone correspondante.
Recherchez activité durable, pics soudains, catégories attendues absentes ou grand segment Autre avant d'ouvrir les lignes individuelles.
Utilisez requêtes, octets transférés, tendance horaire, réponses 2xx réussies et nombres non 2xx pour choisir le robot à examiner en premier.
Examinez chaque chemin et statut répétés, confirmez leur intention, enquêtez sur les réponses inattendues et utilisez le trafic ultérieur pour confirmer l'évolution.
Cette vue est plus utile quand l'équipe connaît suffisamment le site pour déterminer si un modèle de trafic ou une réponse HTTP est attendu.
Vérifiez si des familles vérifiées de robots de recherche et d'IA demandent le site et si des chemins importants renvoient des réponses non 2xx.
Ajoutez des preuves réelles de requêtes aux discussions sur l'exploration sans présenter l'activité des robots comme preuve d'indexation, de citations ou de visibilité.
Transmettez robot, chemin, statut HTTP et nombre de requêtes lorsqu'une route ou un déploiement nécessite une étude technique.
Gardez chaque zone client ou site connectée au projet Screpy correspondant et appliquez la même méthode aux propriétés distinctes.
Des limites claires rendent les preuves plus sûres dans les échanges SEO, contenu, ingénierie et recherche IA.
Une requête de robot vérifié enregistre une tentative d’accès et sa réponse. Même une requête bloquée peut apparaître ; elle ne prouve ni téléchargement du contenu, ni indexation, entraînement, citation ou inclusion dans une réponse IA.
La vue Screpy actuelle utilise une période fixe de sept jours avec tendance horaire. Elle ne promet pas de plages arbitraires ni d'historique bot à long terme.
La vue repose sur les catégories de bots vérifiées disponibles dans la zone connectée. Ce n'est ni un explorateur de logs bruts ni un inventaire complet des scrapers.
Screpy rapporte activité et résultats. La vue ne bloque pas les robots, ne modifie pas les règles d'accès, n'envoie pas d'alertes et n'exporte pas un journal complet.
Utilisez l'analyse des robots pour les requêtes du site, AI Visibility pour les réponses suivies ou Website Audit lorsqu'un problème récurrent demande une enquête technique plus large.
Examinez sept jours de catégories vérifiées, tendances de requêtes, volume transféré, résultats et chemins non 2xx.
Surveillez des prompts sélectionnés pour les mentions de marque, citations, domaines sources, position, sentiment, concurrents et share of voice.
Explorez le site lorsque des requêtes bot non 2xx indiquent des redirections, destinations cassées, problèmes de liens internes ou erreurs de modèle récurrentes.
Comprenez la source connectée, la période fixe, le périmètre des robots vérifiés, la logique des réponses, le détail des URL et la différence entre accès d'un robot et visibilité dans une réponse IA.
Screpy utilise les analyses de la zone Cloudflare associée à un projet pour rapporter le trafic vérifié des bots sur les sept derniers jours. Le tableau de bord inclut une tendance horaire par catégorie et une table avec éditeur, catégorie, octets transférés, total de requêtes, requêtes réussies, requêtes non 2xx et tendance par robot.
Ouvrez le nombre non 2xx du robot concerné, examinez chaque chemin et statut HTTP et décidez si la réponse est intentionnelle. Comparez les redirections inattendues et réponses 4xx ou 5xx à la route réelle, aux liens internes, à la destination canonique, à la configuration de crawl et à un audit du site avant toute modification.
Non. Screpy lit les données agrégées disponibles de la zone Cloudflare associée ; il n’importe pas les journaux serveur bruts et n’affiche pas chaque événement de requête. Catégories, totaux par robot et détails des chemins utilisent des regroupements et limites de source différents ; ils ne constituent pas un registre complet et ne doivent pas nécessairement concorder exactement. Les données manquantes sont indiquées comme indisponibles.
Non. Cette fonctionnalité sert à analyser et enquêter. Les contrôles d'accès, règles de pare-feu, directives robots, alertes, analyses de provenance et exportations CSV ne sont pas gérés depuis cette page.
La table commence par le trafic classé comme bots vérifiés par la source connectée. Screpy ajoute les identités de familles connues comme Googlebot, Bingbot, OpenAI, Anthropic, Perplexity, Apple, Meta et d'autres services reconnus lorsque leurs requêtes sont présentes. Les lignes dépendent du trafic réel de la zone.
Screpy compte les réponses HTTP 2xx comme réussies. Les réponses hors 2xx sont considérées en échec dans cette vue, qui peut donc inclure redirections et erreurs client ou serveur. Vérifiez le statut exact avant de décider d'une correction.
Connectez un jeton API Cloudflare actif capable de lister la zone et de lire ses analyses. Screpy associe les domaines aux zones accessibles. En cas de permission manquante, d'absence de correspondance ou de jeu de données indisponible, le tableau affiche un état indisponible plutôt que des données de remplacement.
Non. L’analytique enregistre la requête et la réponse d’un robot vérifié pendant la période. Des requêtes bloquées peuvent être incluses ; cela ne prouve donc même pas que le robot a téléchargé le contenu. Cela n’établit ni indexation, entraînement de modèle, mention de marque, citation ou inclusion dans une réponse. Utilisez Visibilité IA pour examiner les prompts suivis et les réponses enregistrées.