

Publishers en contentbibliotheken
Zie of geverifieerde zoek- en AI-crawlerfamilies de site opvragen en of belangrijke contentpaden niet-2xx-antwoorden geven.
Koppel de Cloudflare-zone die bij je Screpy-project hoort en bekijk de laatste zeven dagen geverifieerde botactiviteit. Vergelijk crawlercategorieën, publishers, dataverkeer, verzoektrends, geslaagde antwoorden en niet-2xx-URL's zonder een crawlerbezoek te verwarren met een AI-citaat.


Koppel Cloudflare om geverifieerde botverzoeken voor de zone van je Screpy-project te bekijken. Controleer verbinding en bereik voordat je een lege tabel interpreteert.
 Screpy
Vind de zoekmachine- en AI-crawlerfamilies die in de gekoppelde gegevens voorkomen. Naam en uitgever helpen bepalen wie verzoeken stuurde voordat je volume of antwoorden onderzoekt.
Verzoeken
42Herken geconcentreerde verzoeken in de categoriegrafiek en bekijk daarna de crawlersparklines over dezelfde zeven dagen. De huidige weergave gebruikt een vast venster zonder vrije datumselectie.
Verzoeken
1.860Lees verzoekaantallen en overgedragen bytes samen. Ze beschrijven verkeersvolume en antwoordgrootte, niet unieke personen, populariteit van AI-antwoorden of de waarde van je inhoud.
Maak onderscheid tussen antwoordclassificatie en diagnose. De kolom met mislukte verzoeken bevat elk niet-2xx-antwoord; een hoog aantal bewijst op zichzelf geen defecte website.
HTTP-status
200GET /HTTP/2 200Open het niet-2xx-aantal van een crawler om te zien waar verzoeken die antwoorden kregen. Pad, status en frequentie bieden SEO- of technische teams een concreet onderzoekspunt.
GeselecteerdGPTBot
| URL-pad | HTTP-status | Verzoeken |
|---|---|---|
/guides/seo | 404 | 128 |
/guides/seo | 301 | 36 |
/setup | 503 | 12 |
Vraag via SEO MCP naar Quick Wins uit beschikbare zoek-, crawl- en gekoppelde Cloudflare-verkeerssignalen. De toegang omvat deze kansen, niet het volledige analytics- of botverkeerdashboard.
Begin bij de drukste categorieën, kies een crawler en onderzoek terugkerende niet-2xx-paden. Controleer het bedoelde antwoord voordat je een specifiek route- of toegangsprobleem aan het verantwoordelijke team doorgeeft.
Gebruik een actieve API-token die de websitezone kan weergeven en analyses kan lezen; bevestig daarna dat het projectdomein een overeenkomende verbonden zone heeft.
Let op aanhoudende activiteit, plotselinge pieken, ontbrekende verwachte categorieën of een groot segment Overig voordat je losse crawlerregels opent.
Gebruik verzoeken, overgedragen bytes, uurtrend, geslaagde 2xx-antwoorden en niet-2xx-aantallen om de crawler te kiezen die eerst aandacht nodig heeft.
Bekijk herhaalde paden en statussen, bevestig of ze opzettelijk zijn, onderzoek onverwachte antwoorden en gebruik later verkeer om de verandering te bevestigen.
De weergave is het nuttigst wanneer een team genoeg websitecontext heeft om te bepalen of een verkeerspatroon of HTTP-antwoord verwacht is.
Zie of geverifieerde zoek- en AI-crawlerfamilies de site opvragen en of belangrijke contentpaden niet-2xx-antwoorden geven.
Voeg echt verzoekbewijs toe aan crawlbaarheidsgesprekken zonder crawleractiviteit als bewijs voor indexering, citaties of antwoordzichtbaarheid te presenteren.
Draag crawler, pad, HTTP-status en verzoekaantal over wanneer een applicatieroute of deployment technisch onderzoek nodig heeft.
Houd elke klant- of websitezone gekoppeld aan het juiste Screpy-project en gebruik dezelfde methode voor afzonderlijke properties.
Duidelijke grenzen maken het bewijs veiliger in SEO-, content-, engineering- en AI-zoekgesprekken.
Een geverifieerd crawlerverzoek registreert een toegangspoging en het antwoord daarop. Ook geblokkeerde verzoeken kunnen verschijnen; dit bewijst geen inhoudsdownload, indexering, training, citatie of opname in een AI-antwoord.
De huidige Screpy-weergave gebruikt een vaste periode van zeven dagen met uurtrends. Vrije datumbereiken of langdurige bothistorie worden niet beloofd.
De weergave gebruikt geverifieerde botcategorieën uit de verbonden zone. Het is geen verkenner van ruwe serverlogs en geen volledige inventaris van scrapers.
Screpy rapporteert activiteit en antwoordresultaten. De huidige weergave blokkeert geen crawlers, wijzigt geen toegangsregels, stuurt geen botwaarschuwingen en exporteert geen volledig verzoeklog.
Gebruik crawleranalyse voor websiteverzoeken, AI Visibility voor gemonitorde antwoorden of Website Audit wanneer een terugkerend antwoordprobleem breder technisch onderzoek vereist.
Bekijk zeven dagen geverifieerde crawlercategorieën, verzoektrends, overdrachtsvolume, antwoordresultaten en niet-2xx-paden.
Monitor geselecteerde prompts op merkvermeldingen, citaties, brondomeinen, antwoordpositie, sentiment, concurrenten en share of voice.
Crawl de bredere site wanneer niet-2xx-botverzoeken wijzen op omleidingen, kapotte bestemmingen, interne-linkproblemen of terugkerende templatefouten.
Begrijp de verbonden bron, vaste rapportperiode, reikwijdte van geverifieerde crawlers, antwoordlogica, URL-detailweergave en het verschil tussen crawler-toegang en zichtbaarheid in AI-antwoorden.
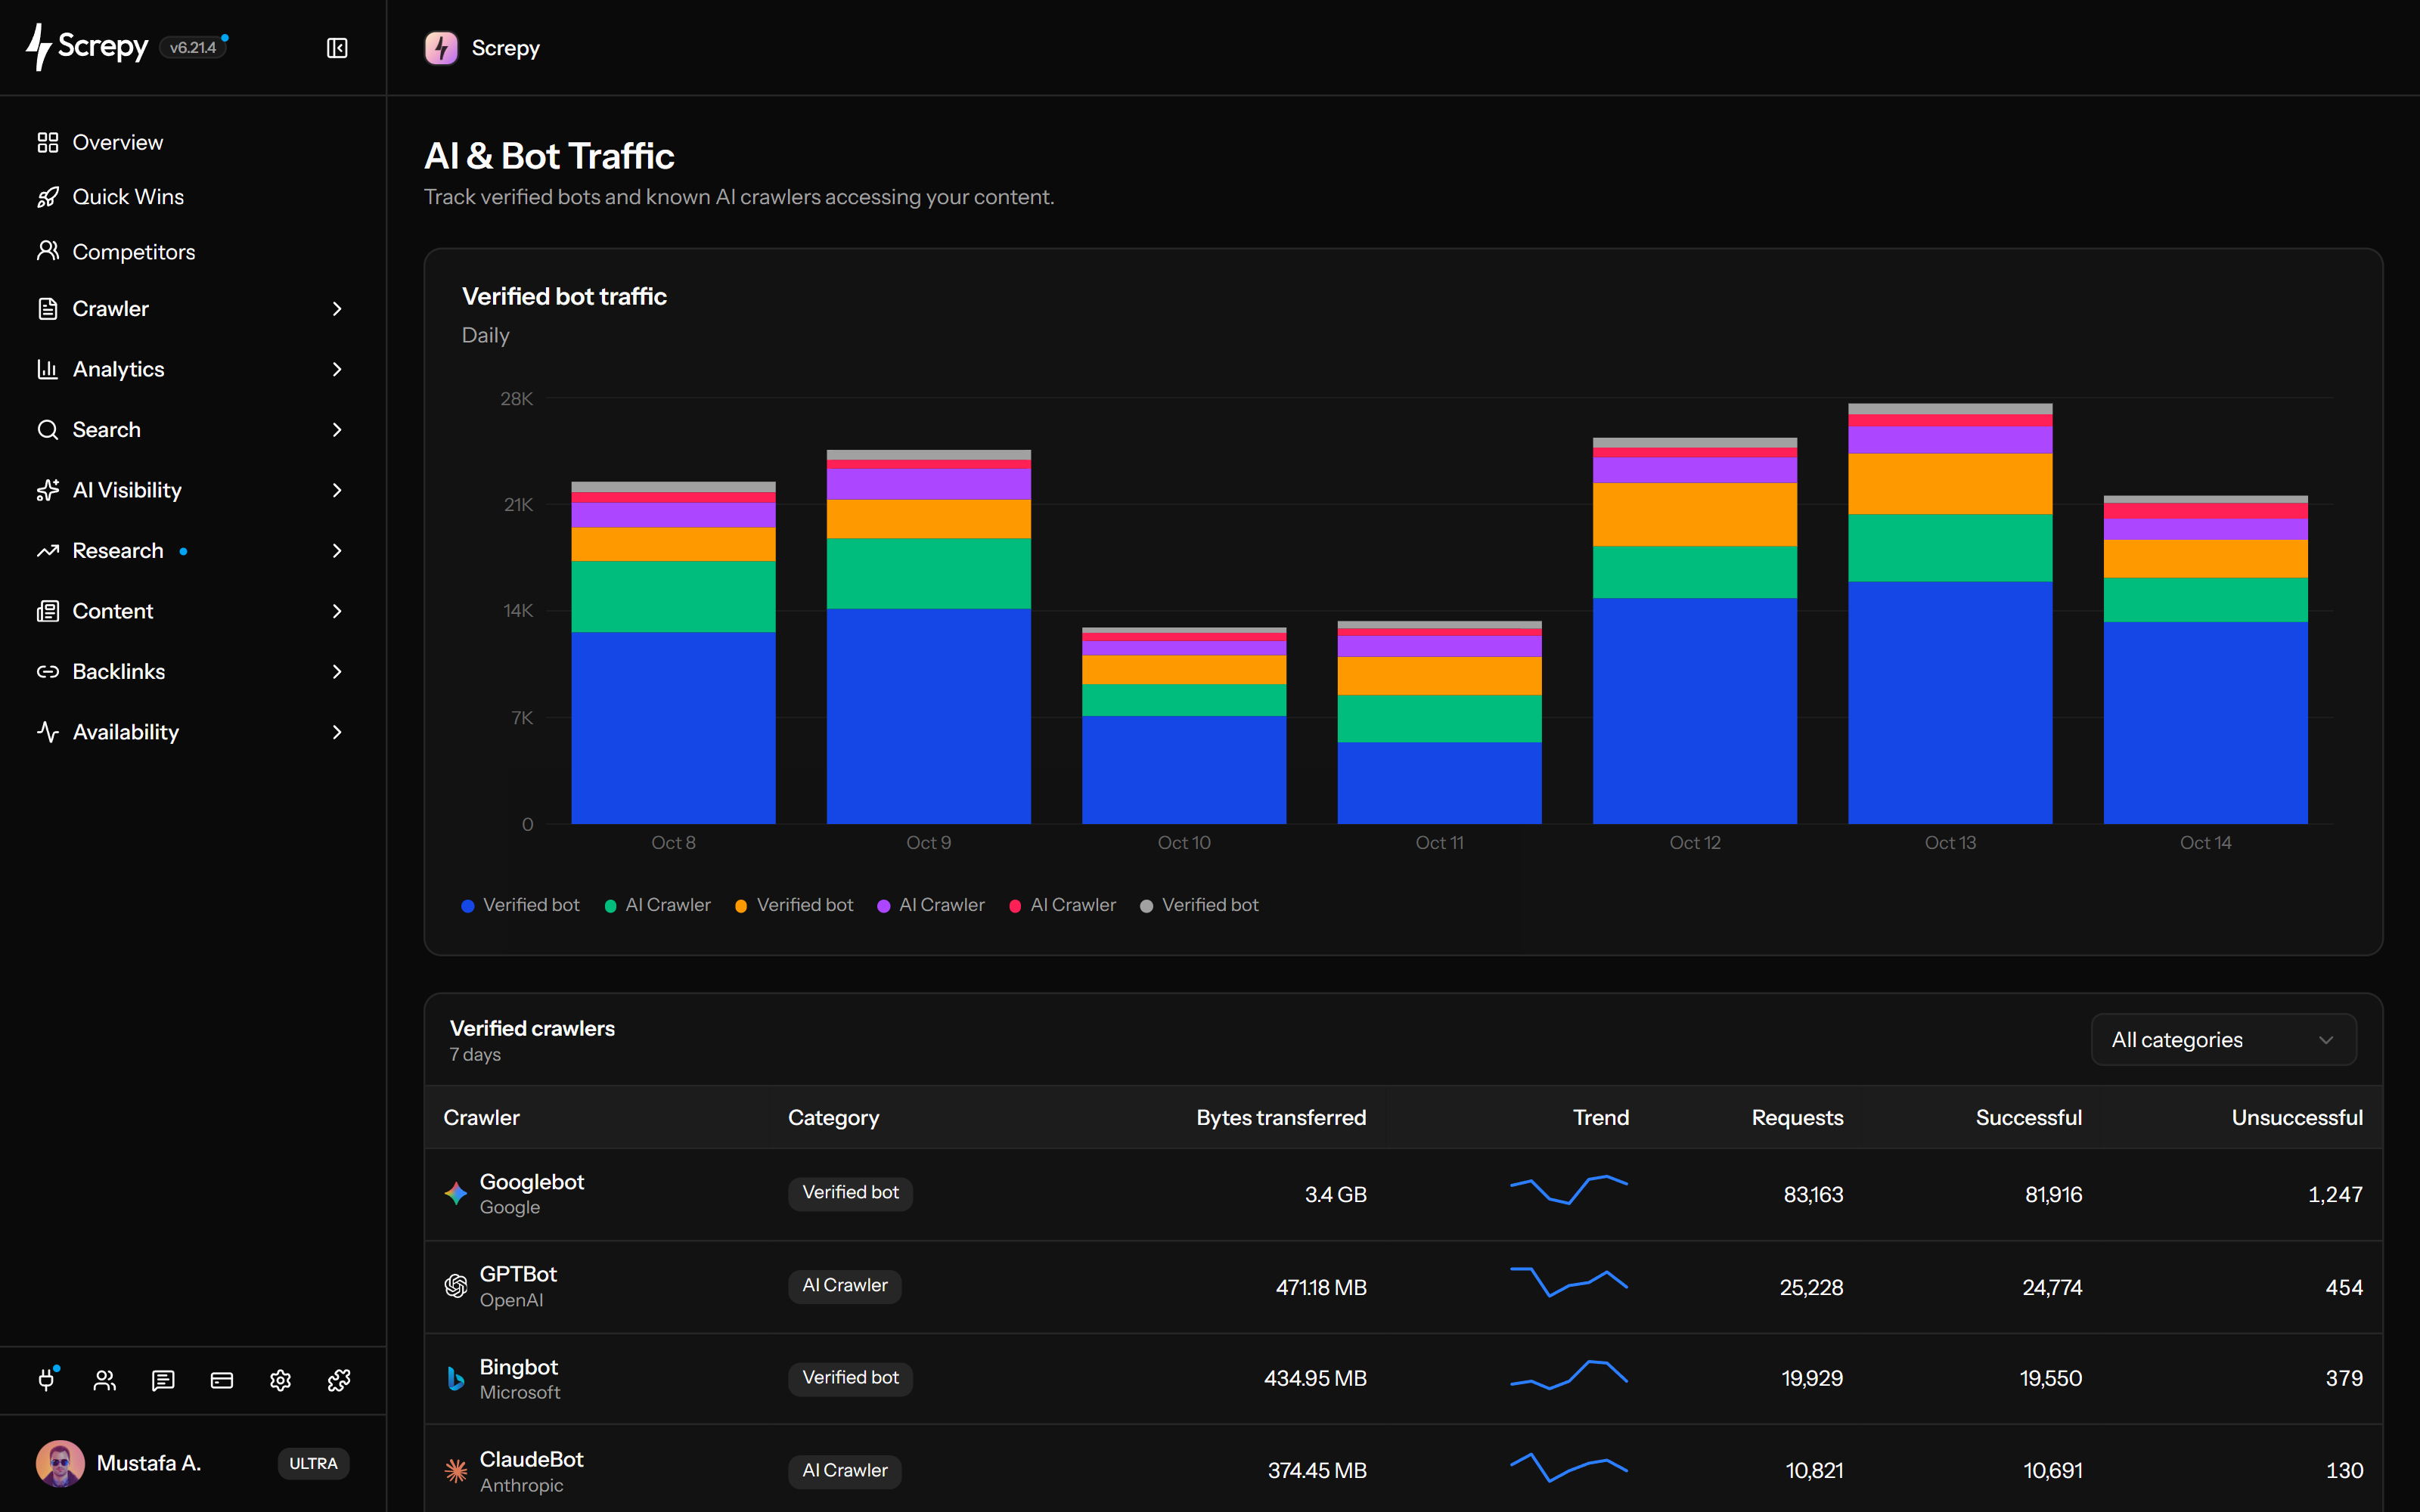
Screpy gebruikt analyses van de Cloudflare-zone die aan een project is gekoppeld om de laatste zeven dagen geverifieerde bottraffic te rapporteren. Het dashboard bevat een uurtrend per categorie en een crawltabel met publisher, categorie, overgedragen bytes, verzoektotalen, geslaagde en niet-2xx-verzoeken en een trend per crawler.
Open het niet-2xx-aantal van de getroffen crawler, bekijk elk pad en HTTP-status en bepaal of de reactie opzettelijk is. Vergelijk onverwachte omleidingen, 4xx- of 5xx-antwoorden met de live route, interne links, canonieke bestemming, crawlconfiguratie en een bredere Website Audit voordat je iets wijzigt.
Nee. Screpy leest beschikbare geaggregeerde analyses voor de gekoppelde Cloudflare-zone; het verwerkt geen ruwe serverlogs en toont niet elk verzoek. Categorieën, crawlertotalen en paddetails gebruiken verschillende groeperingen en bronlimieten. Ze zijn geen volledig verzoeklogboek en hoeven niet exact dezelfde totalen te geven. Ontbrekende brongegevens worden als niet beschikbaar getoond.
Nee. Deze functie is bedoeld voor analyse en onderzoek. Toegangscontroles, firewallregels, robots-directieven, crawlerwaarschuwingen, referralanalyse en CSV-export worden niet vanaf deze Screpy-pagina beheerd.
De tabel begint met verkeer dat door de verbonden bron als geverifieerde bots is gecategoriseerd. Screpy voegt leesbare identiteiten toe voor bekende families zoals Googlebot, Bingbot, OpenAI, Anthropic, Perplexity, Apple, Meta en andere herkende diensten wanneer hun verzoeken aanwezig zijn. De rijen hangen af van echt zoneverkeer.
Koppel een actieve Cloudflare-API-token die de relevante zone kan weergeven en analyses kan lezen. Screpy koppelt projectdomeinen aan toegankelijke zones. Bij ontbrekende rechten, geen overeenkomst of een ontbrekende dataset toont het dashboard niet beschikbaar in plaats van vervangende data.
Screpy telt HTTP 2xx-antwoorden als geslaagd. Antwoorden buiten 2xx gelden in deze weergave als mislukt; de detailweergave kan dus omleidingen en client- of serverfouten bevatten. Controleer de exacte status voordat je beslist of een oplossing nodig is.
Nee. De analyses registreren het verzoek en antwoord van een geverifieerde crawler in de rapportperiode. Geblokkeerde verzoeken kunnen meetellen, dus dit bewijst niet eens dat de crawler inhoud downloadde. Het toont geen indexering, modeltraining, merkvermelding, citaat of opname in een antwoord aan. Gebruik AI-zichtbaarheid voor gemonitorde prompts en opgeslagen antwoorden.