


Migraties en URL-wijzigingen
Leg belangrijke URL's, redirects, canonicals en interne paden vast vóór de lancering.
Crawl je website in de cloud en ontdek pagina's via interne links, in plaats van URL's één voor één te controleren. Stel capaciteit, diepte, JavaScript-rendering, concurrency en request-delay in en onderzoek de Pages-, Links- en Images-records achter elk technisch patroon.
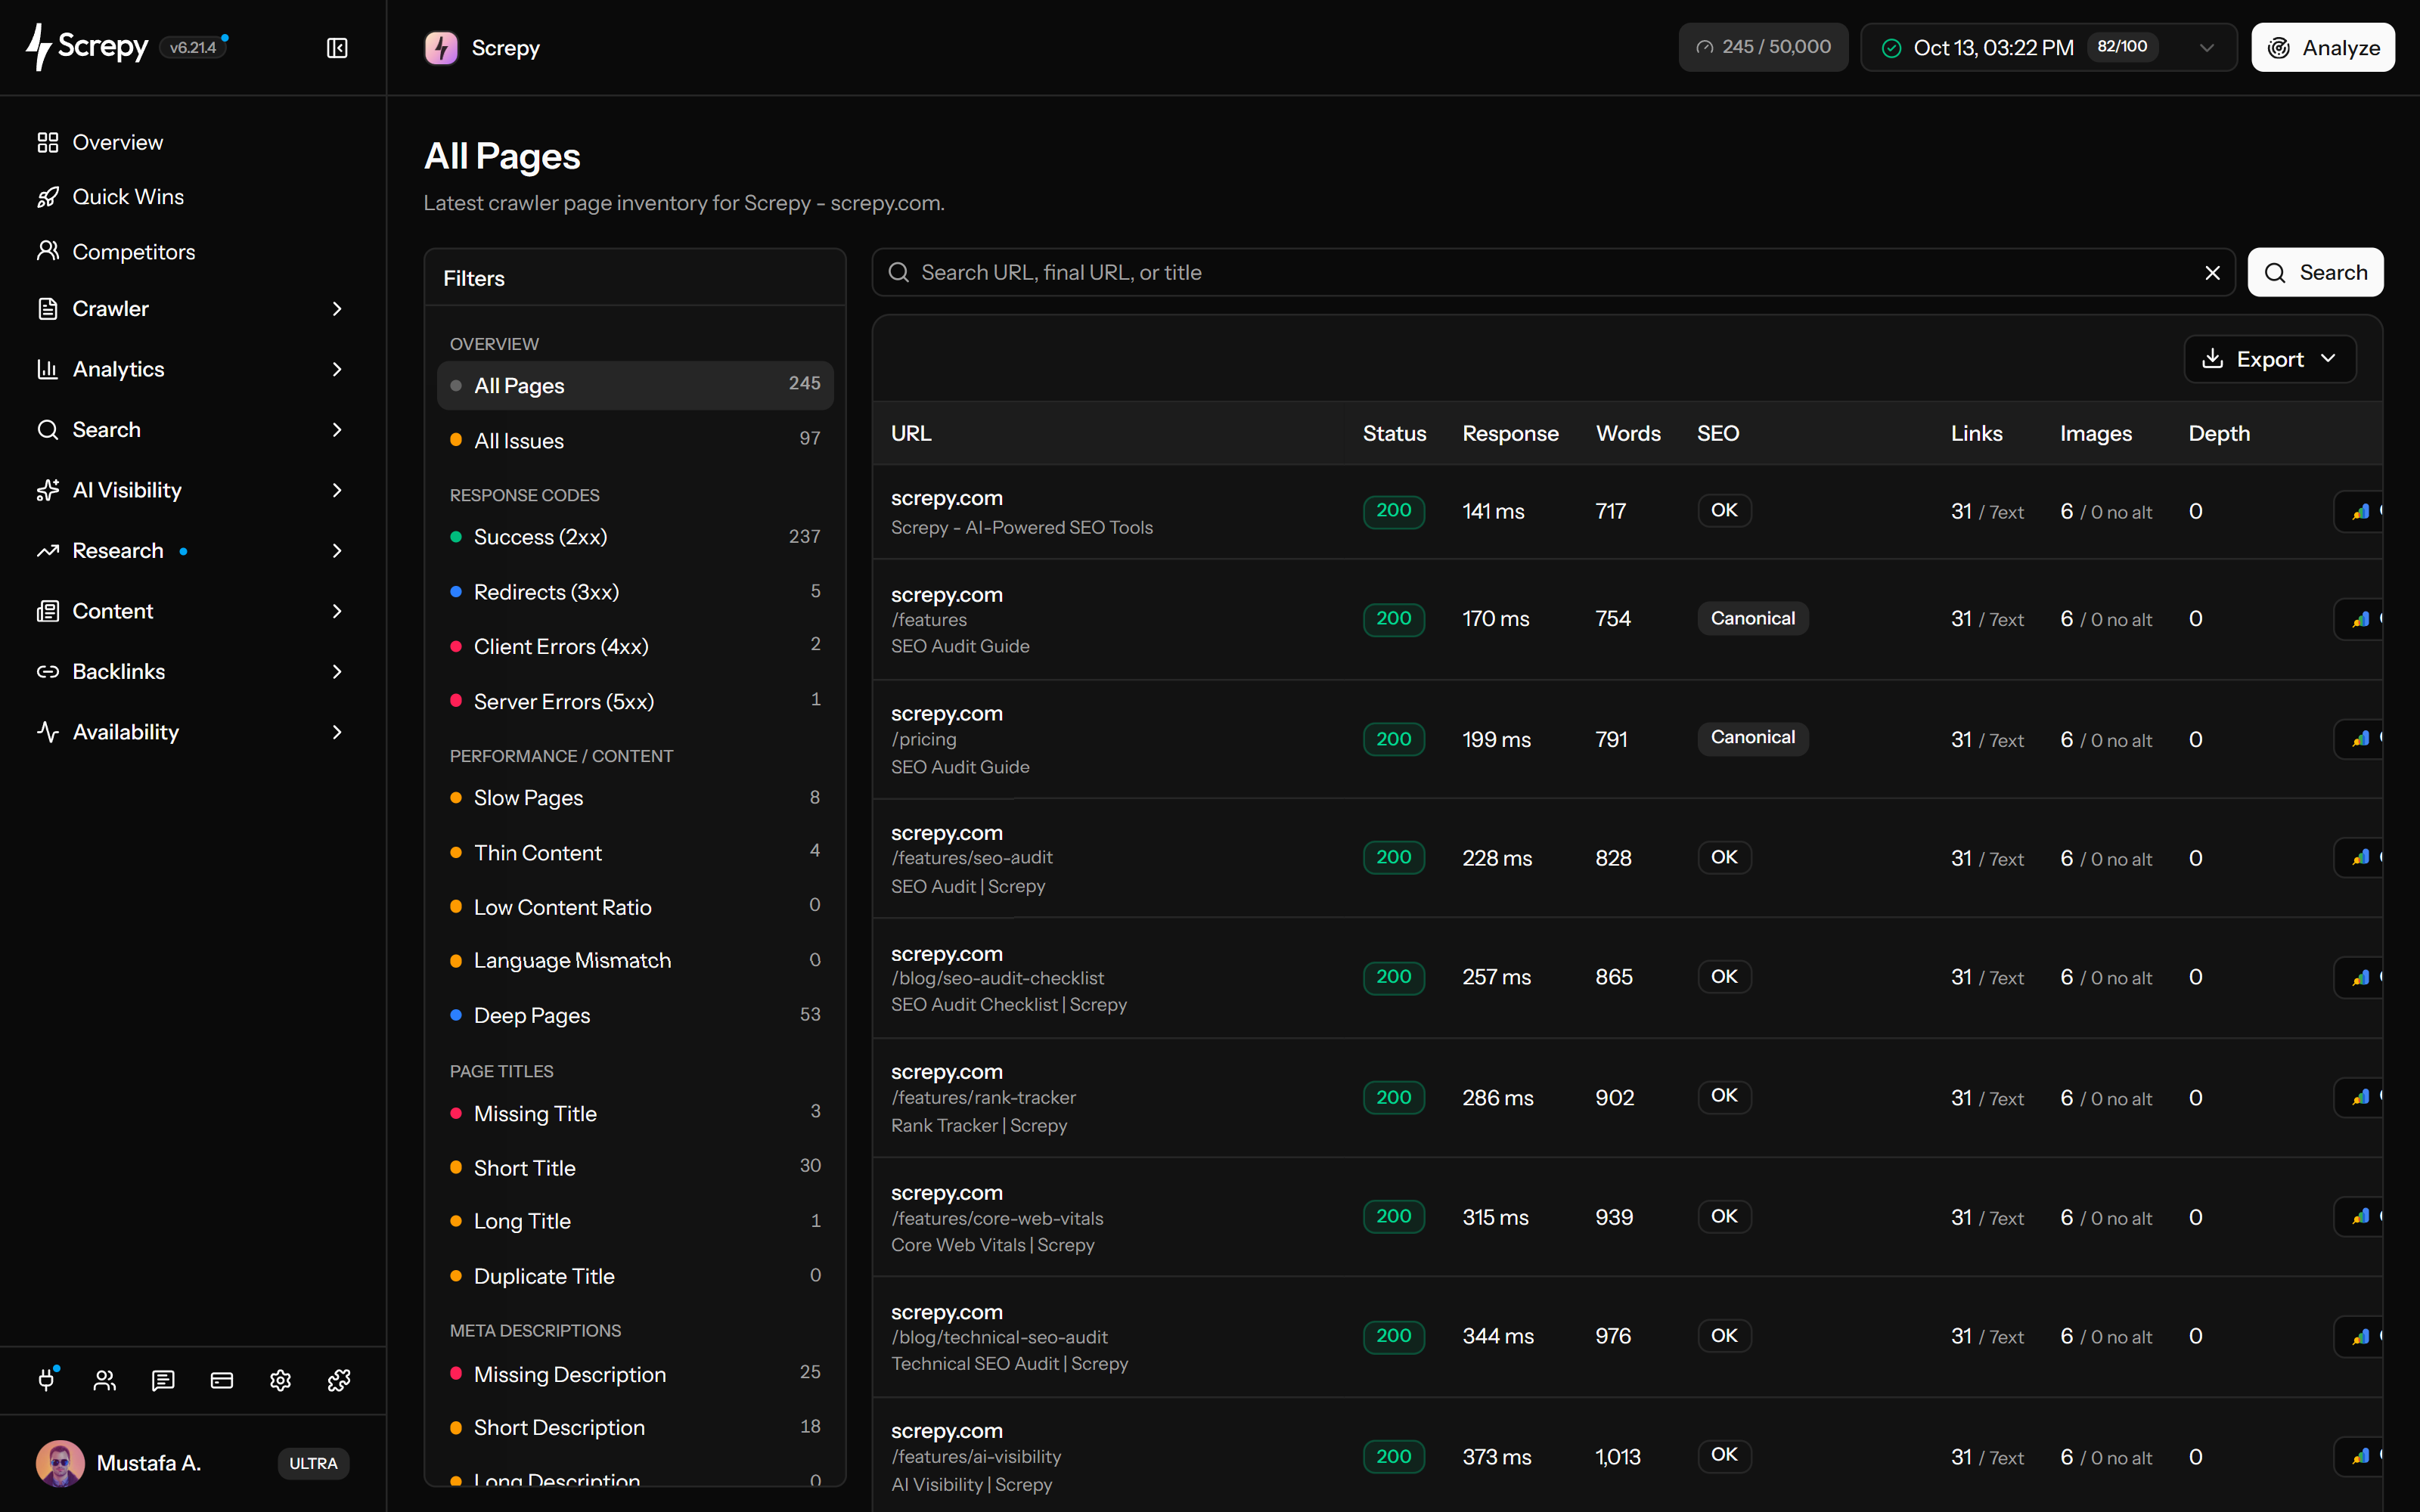


Screpy begint bij je projectwebsite en volgt bereikbare interne links in de cloud. De eerste crawl start tijdens het instellen; gebruik later Analyseren in Pagina’s, Links of Afbeeldingen om een nieuwe inventaris te maken.
Navigatie aan de clientzijde kan belangrijke links voor een crawl van de oorspronkelijke HTML verbergen. Schakel JavaScript in wanneer scripts betekenisvolle inhoud of navigatie maken; laat het uit wanneer de server de benodigde HTML al teruggeeft.
<main id="app">
  <script />
</main>Ontdekkingsbereik en verzoektempo lossen verschillende problemen op. Diepte bepaalt het aantal gevolgde interne linkniveaus; gelijktijdigheid en vertraging regelen de serverbelasting. Meer diepte maakt een pagina zonder links niet vindbaar.
example.com3
//shop//shop/linen/Begrijp via vastgelegde URL’s en links hoe een categorie, product of artikel verbonden is met je site. Gebruik bronpagina-relaties om diepe inhoud, verouderde navigatie en paden via redirects te onderzoeken.
Maak een werkbestand van de records die je team nodig heeft. Filter de gekozen crawl vóór export in plaats van de hele site te delen wanneer de taak één sjabloon, antwoordstatus of bestandspatroon betreft.
Een voltooide crawl legt de website vast zoals die toen bereikbaar was. Crawl opnieuw na een navigatiewijziging of migratie om ontdekking en bestemmingen te controleren; oude records wijzigen niet automatisch met de live website.
Verbind je AI-assistent met de SEO MCP-server van Screpy. Vraag naar je laatste voltooide crawl, bekijk betrokken pagina’s en bepaal een duidelijke volgorde voor technische SEO-taken.
Houd bereik zichtbaar, inspecteer records, herstel de implementatie en bevestig het resultaat met de volgende crawl.
Controleer start-URL, maximumaantal URL's, linkdiepte, JavaScript-modus, gelijktijdige verzoeken, wachttijd tussen verzoeken, robotsregels en crawlertoegang. Deze instellingen bepalen wat de momentopname kan vertegenwoordigen.
Screpy volgt toegankelijke interne routes en legt elke ontdekte URL, reactie, diepte, bestemming, linkrelatie en bijbehorende pagina- of afbeeldingsgegevens vast binnen de ingestelde reikwijdte.
Gebruik de rapporten Pages, Links en Images om van een totaalcijfer naar representatieve URL's, bronpagina's, redirectgedrag, metadata, canonieke URL's of afbeeldingsgebruik te gaan voordat je een verbetering kiest.
Crawl opnieuw na de wijziging met hetzelfde bereik en controleer of het bedoelde patroon veranderde.
Maak een baseline vóór risicovol werk en een vergelijkbare snapshot nadat de wijziging live staat.
Leg belangrijke URL's, redirects, canonicals en interne paden vast vóór de lancering.
Gebruik JavaScript-rendering wanneer navigatie of betekenisvolle paginacontent in de browser ontstaat en controleer daarna of die URL's in de crawlinventaris voorkomen.
Bekijk crawldiepte, bronpagina's, ankerteksten, kenmerken en herhaalde navigatieroutes om belangrijke content te vinden die zwak verbonden of moeilijk te ontdekken is.
Crawl opnieuw na wijzigingen in routing, navigatie, CMS, templates en componenten om terugkerende technische problemen te vinden terwijl de implementatiecontext nog vers is.
Vergelijk Screpy met Screaming Frog wanneer uitvoeringsmodel, crawlinstellingen, aangepaste extractie, terugkerende monitoring, teamtoegang en rapportage meewegen.
Gebruik SEO Crawler om ontdekkingsroutes in kaart te brengen en gegevens over pagina's, links en afbeeldingen te bekijken. Gebruik Website Audit wanneer het team gegroepeerde bevindingen, prioritering van problemen en een bredere workflow voor technische gezondheid nodig heeft.
Stel een cloudcrawl in, breng bereikbare URL's in kaart en bekijk de ruwe gegevens in Pages, Links en Images achter technische patronen.
Zet een crawl om in bevindingen, prioriteiten en een verificatieflow.
SaaS-sites en ecommercecatalogi hebben verschillende risico's in gedeelde templates en veranderende URL-sets.
Bekijk landingspagina's, documentatie, templates en release-regressies als één acquisitie-oppervlak.
Controleer categorie- en productpaginatypen, kapotte winkelroutes en structurele wijzigingen in de catalogus.
Screpy-documentatie
Gebruik de Screpy-handleidingen om het crawlbereik in te stellen, crawlertoegang toe te staan, de rapporten Pages, Links en Images te interpreteren en onvolledige resultaten te onderzoeken.
Lees hoe pagina's worden ontdekt, hoe je het crawlbereik en de snelheid instelt, wat de rapporten bevatten en hoe je resultaten vergelijkt.
Een SEO-crawler begint bij een website-URL, volgt toegankelijke interne links binnen het ingestelde bereik en registreert technische gegevens over de gevonden pagina's en bronnen. Met die inventaris kunnen teams onder meer bereikbaarheid, statuscodes, redirects, canonicals, interne links, metadata, afbeeldingen en terugkerende patronen onderzoeken.
Screpy biedt optionele JavaScript-rendering voor websites waarvan belangrijke links of content in de browser worden opgebouwd. Rendering kan de ontdekking verbeteren, maar omzeilt geen robots-regels, authenticatie, firewalls, botcontroles, time-outs of het ingestelde crawlbereik.
Ja. Gelijktijdigheid bepaalt hoeveel verzoeken tegelijk lopen. Verzoekvertraging is beschikbaar wanneer gelijktijdigheid op 1 staat; bij hogere waarden wordt de vertraging als nul opgeslagen. Verlaag de verzoekdruk als je server automatisch verkeer begrenst en controleer of de volgende crawl echte pagina-antwoorden ontvangt.
Het maximumaantal URL's beperkt hoeveel gevonden URL's de crawl kan opslaan. De crawl-diepte beperkt hoeveel niveaus van interne links Screpy vanaf de startpagina volgt. Hogere limieten verhelpen geen blokkades, ontbrekende links, redirects, snelheidslimieten of onbruikbare responses.
De crawler moet de echte pagina kunnen ontvangen zonder login, CAPTCHA, browsercontrole, firewallblokkade of afwijzing door een snelheidslimiet. Sta ScrepyBot en het gedocumenteerde crawler-IP toe in elke beveiligingslaag, controleer de toegang via robots.txt en verifieer dat een succesvolle response de echte HTML bevat.
Nee. Crawldata helpt technische omstandigheden te ontdekken en verbeteringen te verifiëren, maar posities hangen ook af van relevantie, contentkwaliteit, autoriteit, concurrentie, vraag, indexering en hoe zoekmachines elke pagina interpreteren. Gebruik crawlerfilters als aanleiding voor onderzoek, niet als automatische instructies voor hogere posities.
Screpy begint bij de projectwebsite en volgt toegankelijke interne links binnen de ingestelde URL-limiet en crawl-diepte. Een pagina kan ontbreken als er geen link naartoe is, deze buiten de gekozen diepte valt, is geblokkeerd, naar een andere host verwijst, JavaScript-rendering vereist of geen bruikbare content teruggeeft.
Pages registreert gecrawlde URL's met onder meer response, diepte, metadata, koppen, canonical, indexeerbaarheid, content, gestructureerde gegevens en sociale signalen. Links koppelt bestemmingen aan status, ankertekst, attributen, gebruik en bronpagina's. Images groepeert afbeeldingsbronnen met response, alt-tekst, afmetingen, laadkenmerken en paginagebruik.
Ja. Het Links-rapport helpt mislukte of doorgestuurde bestemmingen te vinden en terug te leiden naar de gecrawlde bronpagina's die ernaar verwijzen. Zo krijgen ontwikkelaars en redacteuren een concrete pagina, gedeelde component of template om te herstellen in plaats van alleen een bestemmings-URL.
Ja. Elke voltooide crawl is een gedateerde momentopname. Voer na een release of herstel een nieuwe crawl uit en vergelijk momentopnamen met hetzelfde bereik en dezelfde instellingen. Zo verwar je wijzigingen in dekking of aantallen problemen niet met een andere crawlconfiguratie.
De crawler legt de technische inventaris vast, waaronder gevonden URL's, responses, paden, paginagegevens, links, afbeeldingen en crawlcontext. Website Audit groepeert die gegevens tot bevindingen, getroffen patronen en prioriteiten voor herstel en verificatie. Gebruik de crawler voor ruwe gegevens en ontdekking; gebruik de audit voor een bredere gezondheidscontrole.
Ze beantwoorden verschillende vragen. Search Console rapporteert over prestaties in Google Zoeken en geselecteerde indexeringsinformatie. Een SEO-crawler volgt proactief je interne links en maakt een technische inventaris die je kunt onderzoeken voordat Google een probleem meldt of het verkeer verandert.
Begrijp Super Intelligence en verbind audits, zoekonderzoek, posities en AI-zichtbaarheid in een praktische Screpy-werkwijze.