


Migrações e mudanças de URL
Registre URLs importantes, redirecionamentos, destinos finais, canonicals e caminhos internos antes do lançamento e rastreie a nova estrutura com o mesmo escopo.
Execute um rastreamento na nuvem e mapeie o site pelos links internos, sem verificar URLs uma a uma. Configure capacidade, profundidade, renderização JavaScript, concorrência e atraso das solicitações; depois analise os registros exatos de Pages, Links e Images por trás de cada padrão técnico.
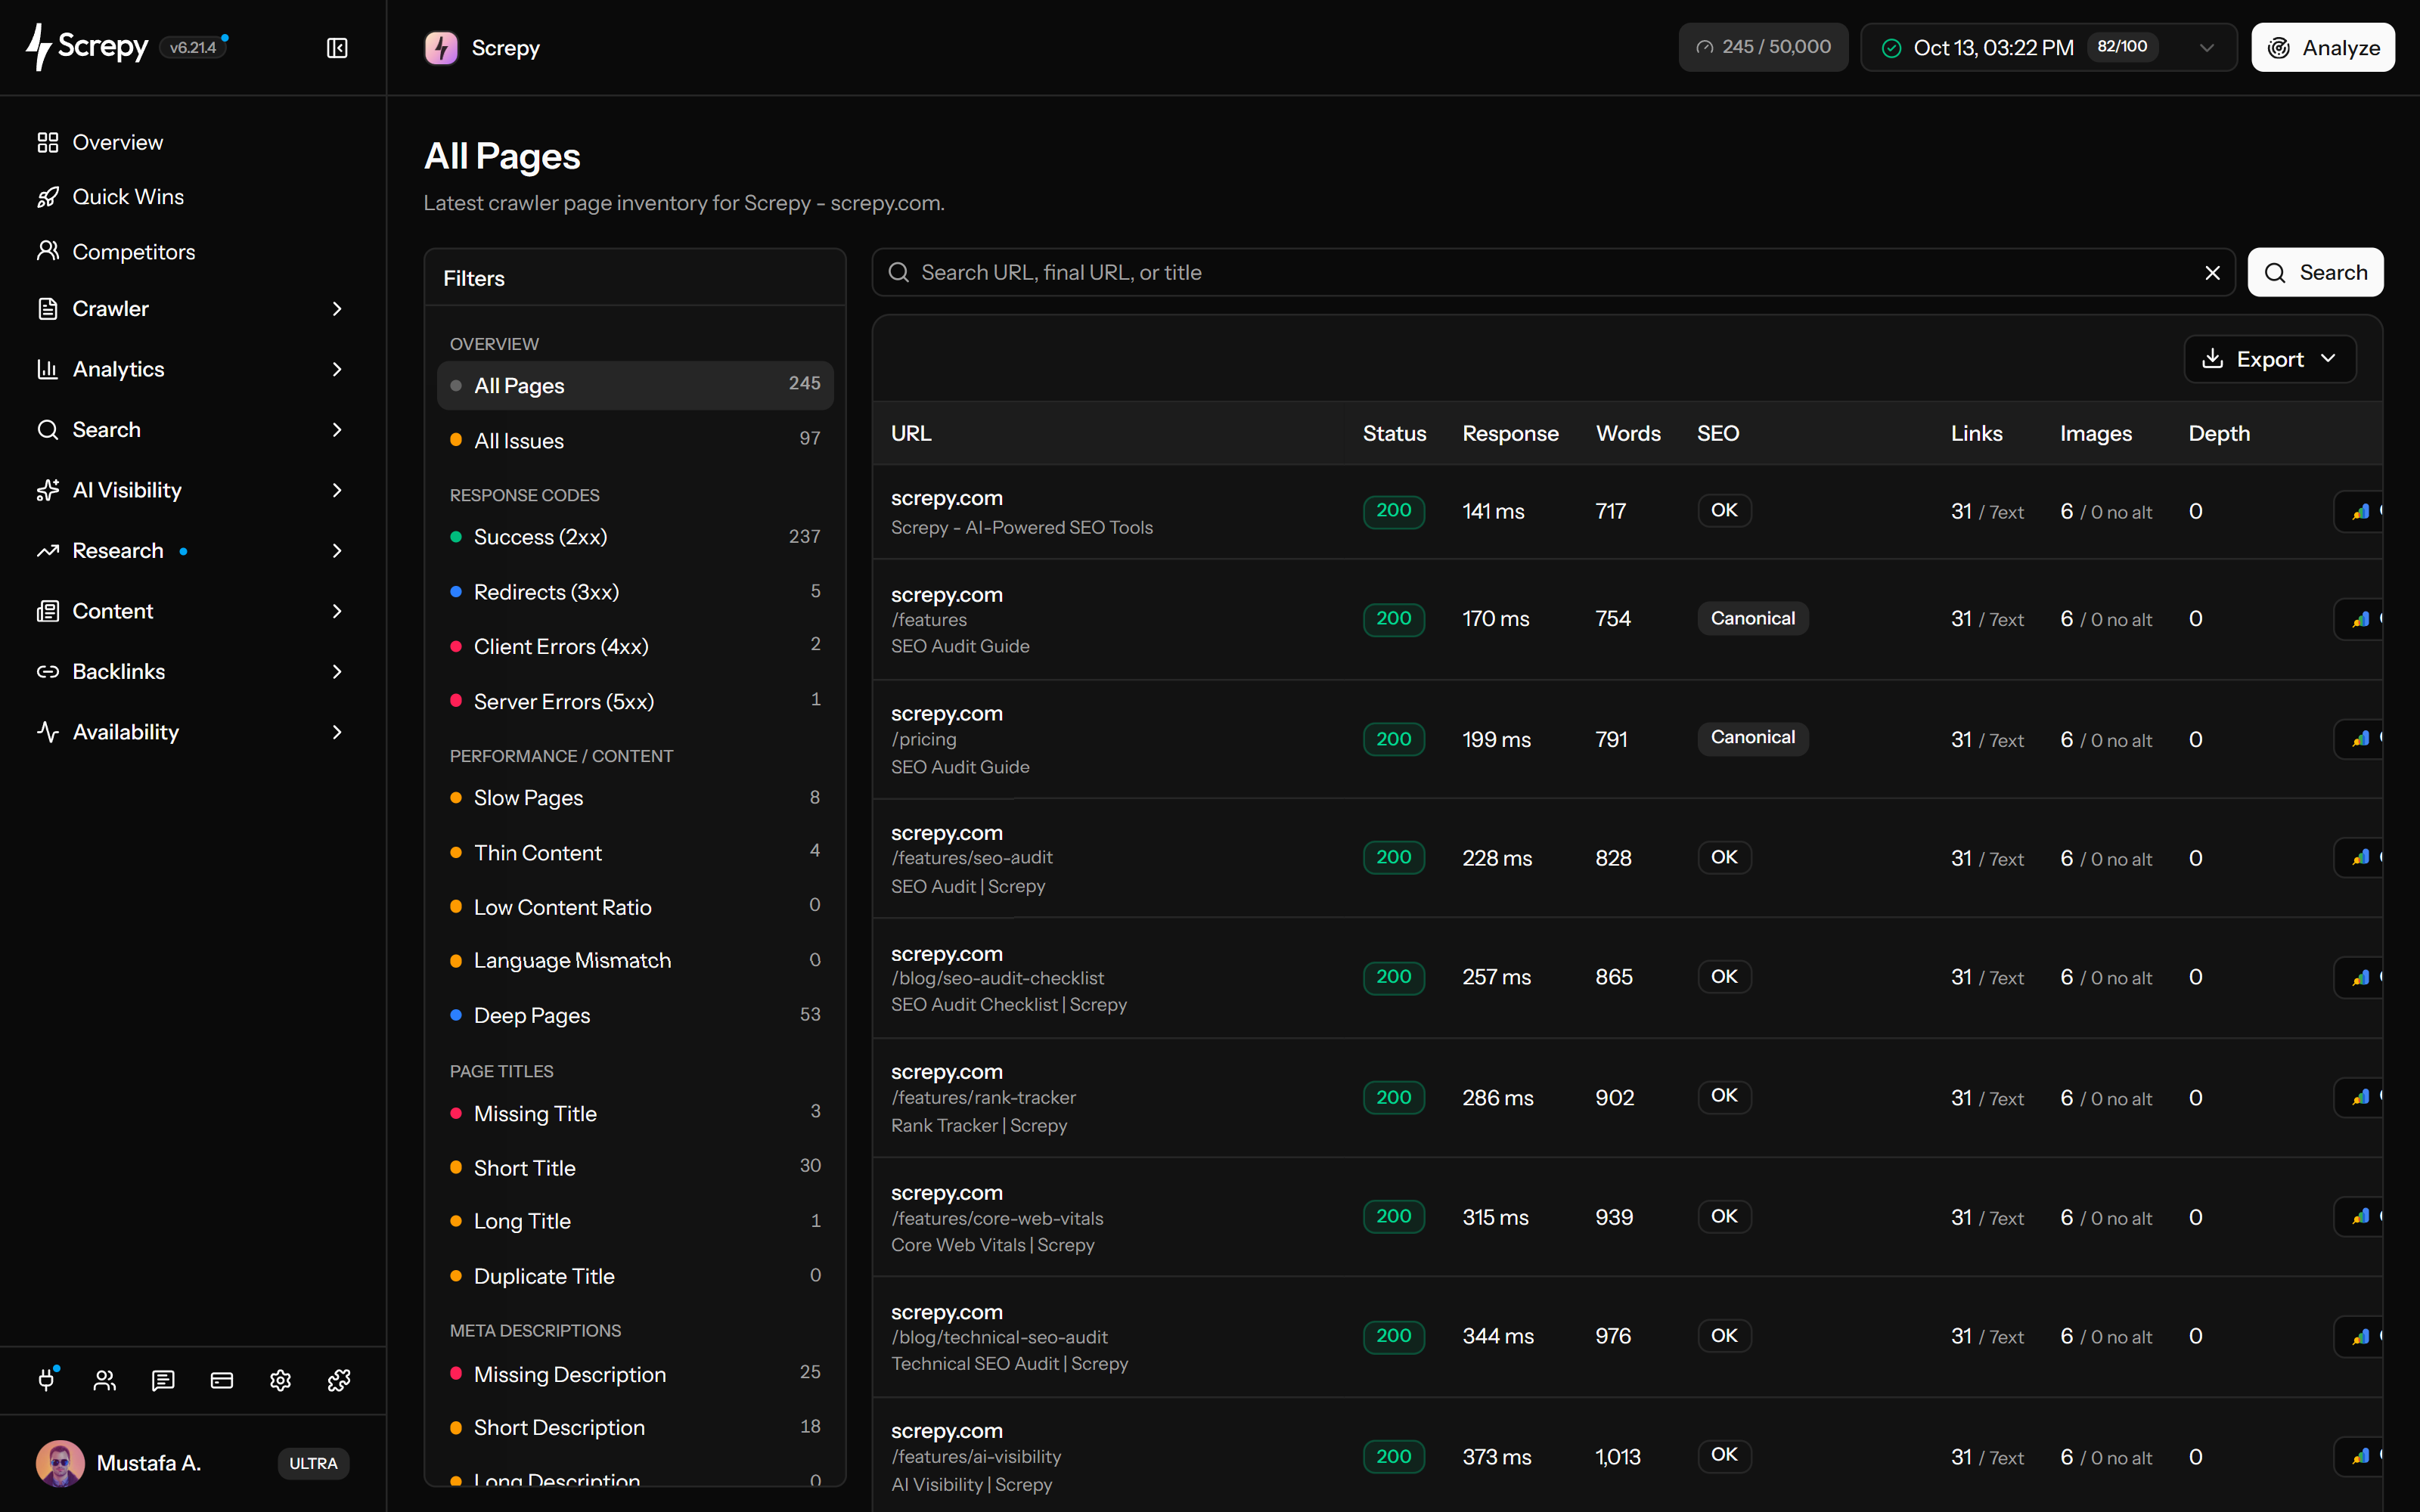


O Screpy começa no site do projeto e segue links internos acessíveis na nuvem. O primeiro rastreamento inicia durante a configuração; depois, use Analisar em Páginas, Links ou Imagens para criar um novo inventário.
A navegação do lado do cliente pode esconder links importantes do rastreamento do HTML inicial. Ative JavaScript quando scripts gerarem conteúdo significativo ou navegação; deixe desativado se o servidor já retornar o HTML necessário.
<main id="app">
  <script />
</main>O escopo de descoberta e o ritmo de solicitações resolvem problemas diferentes. A profundidade determina os níveis de links internos seguidos; concorrência e atraso controlam a pressão sobre o servidor. Aumentar a profundidade não descobre uma página sem links.
example.com3
//shop//shop/linen/Entenda como uma categoria, produto ou artigo se conecta ao site por URLs e links registrados. Use relações com páginas de origem para investigar conteúdo profundo, navegação desatualizada e caminhos que passam por redirecionamentos.
Crie um arquivo de implementação com os registros necessários à equipe. Filtre o rastreamento escolhido antes de exportar, em vez de entregar o site inteiro quando a tarefa trata de um modelo, status de resposta ou padrão de arquivos.
Um rastreamento concluído registra o site como foi alcançado naquele momento. Após mudar a navegação ou migrar, execute outro para conferir descoberta e destinos; registros antigos não se atualizam automaticamente quando o site ativo muda.
Conecte seu assistente de IA ao servidor SEO MCP do Screpy. Pergunte sobre o último rastreamento concluído, examine as páginas afetadas e priorize os resultados de SEO técnico.
Mantenha o escopo visível, inspecione os registros por trás de cada padrão, corrija a implementação e use o próximo rastreamento para confirmar o resultado.
Confirme URL inicial, capacidade, profundidade, modo JavaScript, concorrência, atraso, regras robots e acesso do crawler. Essas configurações determinam o que o snapshot pode representar.
O Screpy segue caminhos internos acessíveis e registra cada URL, resposta, profundidade, destino, relação do link e dados de página ou imagem dentro do escopo.
Use os relatórios Pages, Links e Images para passar do total a URLs representativas, páginas de origem, redirecionamentos, metadados, canonicals ou uso de imagens antes de escolher uma correção.
Execute outro rastreamento depois das mudanças. Mantenha escopo e configurações comparáveis e verifique se as URLs pretendidas mudaram pelo motivo correto.
Os dados de rastreamento são mais úteis quando a equipe sabe o que mudou. Crie uma base antes de um trabalho de risco e um snapshot comparável depois do lançamento.
Registre URLs importantes, redirecionamentos, destinos finais, canonicals e caminhos internos antes do lançamento e rastreie a nova estrutura com o mesmo escopo.
Use a renderização JavaScript quando a navegação ou o conteúdo relevante é criado no navegador e confirme que as URLs aparecem no inventário.
Revise profundidade, páginas de origem, anchors, atributos e caminhos repetidos para encontrar conteúdo importante com conexão fraca.
Rastreie novamente após mudanças de rotas, navegação, CMS, templates e componentes para encontrar regressões técnicas repetidas.
Compare Screpy com Screaming Frog quando modelo de deploy, controles, extração, monitoramento, acesso da equipe e relatórios influenciam a decisão.
Use o SEO Crawler para mapear caminhos e inspecionar registros de páginas, links e imagens. Use o Website Audit quando precisar de achados agrupados, prioridades e um fluxo técnico mais amplo.
Configure um rastreamento na nuvem, mapeie URLs alcançáveis e analise os registros brutos de Pages, Links e Images.
Transforme um rastreamento em achados agrupados, padrões de URLs, prioridades, exportações e um fluxo repetível de correção e verificação.
Templates compartilhados e conjuntos de URLs que mudam criam riscos diferentes para sites SaaS e catálogos de ecommerce.
Analise landing pages, documentação, templates compartilhados e regressões de release como uma única superfície de aquisição.
Audite categorias e produtos, caminhos de compra quebrados e mudanças estruturais do catálogo.
Documentação do Screpy
Use os guias do Screpy para configurar o escopo, permitir o acesso do crawler, interpretar os relatórios Pages, Links e Images e diagnosticar resultados incompletos.
Entenda descoberta, escopo, renderização JavaScript, acesso, ritmo, relatórios, snapshots e a diferença entre dados de rastreamento e auditoria.
Um SEO crawler começa em uma URL, segue links internos acessíveis dentro de um escopo definido e registra informações técnicas das páginas e recursos alcançados. O inventário ajuda a investigar descoberta, códigos de resposta, redirecionamentos, canonicals, links internos, metadados, imagens e padrões repetidos.
Sim. Há uma configuração opcional de JavaScript para sites cujo conteúdo ou links importantes são criados no navegador. A renderização não ignora regras robots, autenticação, firewalls, desafios de bot, timeouts ou o escopo definido.
Sim. A concorrência controla quantas solicitações são executadas ao mesmo tempo. O atraso está disponível com concorrência 1; com valores maiores, o atraso salvo é zero. Reduza a pressão das solicitações se seu servidor limitar o tráfego automatizado e verifique se o próximo rastreamento recebe respostas das páginas reais.
Pages registra respostas, profundidade, metadados, headings, canonical, indexabilidade, conteúdo, dados estruturados e sinais sociais. Links relaciona destinos, status, anchors, atributos, uso e páginas de origem. Images agrupa fontes com status, alt text, dimensões, atributos de entrega e uso nas páginas.
O crawler precisa receber a página real sem login, CAPTCHA, desafio do navegador, bloqueio de firewall ou rejeição por limite de taxa. Permita o ScrepyBot e os IPs documentados do crawler em cada camada de segurança, confirme o acesso ao robots.txt e verifique se uma resposta bem-sucedida contém o HTML real da página.
Eles respondem perguntas diferentes. O Search Console mostra desempenho e alguns dados de indexação; o crawler segue proativamente os links internos e cria um inventário técnico para investigação.
O Screpy começa no site do projeto e segue links internos acessíveis dentro da capacidade e profundidade configuradas. Uma página pode faltar se não tiver links, estiver além da profundidade, for bloqueada, redirecionar para fora do host, depender de JavaScript ou retornar conteúdo inutilizável.
Sim. Cada rastreamento concluído é um snapshot datado. Execute outro após um deploy ou correção e compare snapshots com escopo e configurações equivalentes.
O máximo de URLs limita quantas URLs descobertas o rastreamento pode armazenar. A profundidade limita quantos níveis de links internos são seguidos a partir da página inicial. Aumentar esses valores não corrige acesso bloqueado, links ausentes, redirecionamentos, limites de taxa ou respostas inutilizáveis.
Não. Os dados ajudam a descobrir e verificar condições técnicas, mas posições também dependem de relevância, qualidade, autoridade, concorrência, demanda e indexação.
Sim. O relatório Links identifica destinos com falha ou redirecionados e mostra as páginas rastreadas que os referenciam, oferecendo uma origem específica para corrigir.
O SEO crawler cria o inventário técnico de URLs, respostas, caminhos, dados, links, imagens e contexto. O Website Audit interpreta esse rastreamento em achados agrupados, padrões afetados, prioridades e um fluxo de correção. Use o crawler para descoberta e registros brutos; use a auditoria para uma revisão de saúde priorizada.
Entenda Super Intelligence e conecte auditorias, pesquisa, posições e visibilidade em IA em um fluxo prático do Screpy.