


Migracje witryny i zmiany URL-i
Zapisz ważne URL-e, przekierowania, końcowe cele, canonicale i ścieżki wewnętrzne przed uruchomieniem, a potem przecrawluj nową strukturę w tym samym zakresie.
Uruchom crawl w chmurze i odwzoruj witrynę na podstawie jej linków wewnętrznych zamiast sprawdzać adresy URL pojedynczo. Skonfiguruj limit crawlu, głębokość, renderowanie JavaScript, współbieżność i opóźnienie żądań, a następnie analizuj dokładne rekordy stron, linków i obrazów stojące za każdym wzorcem technicznym.
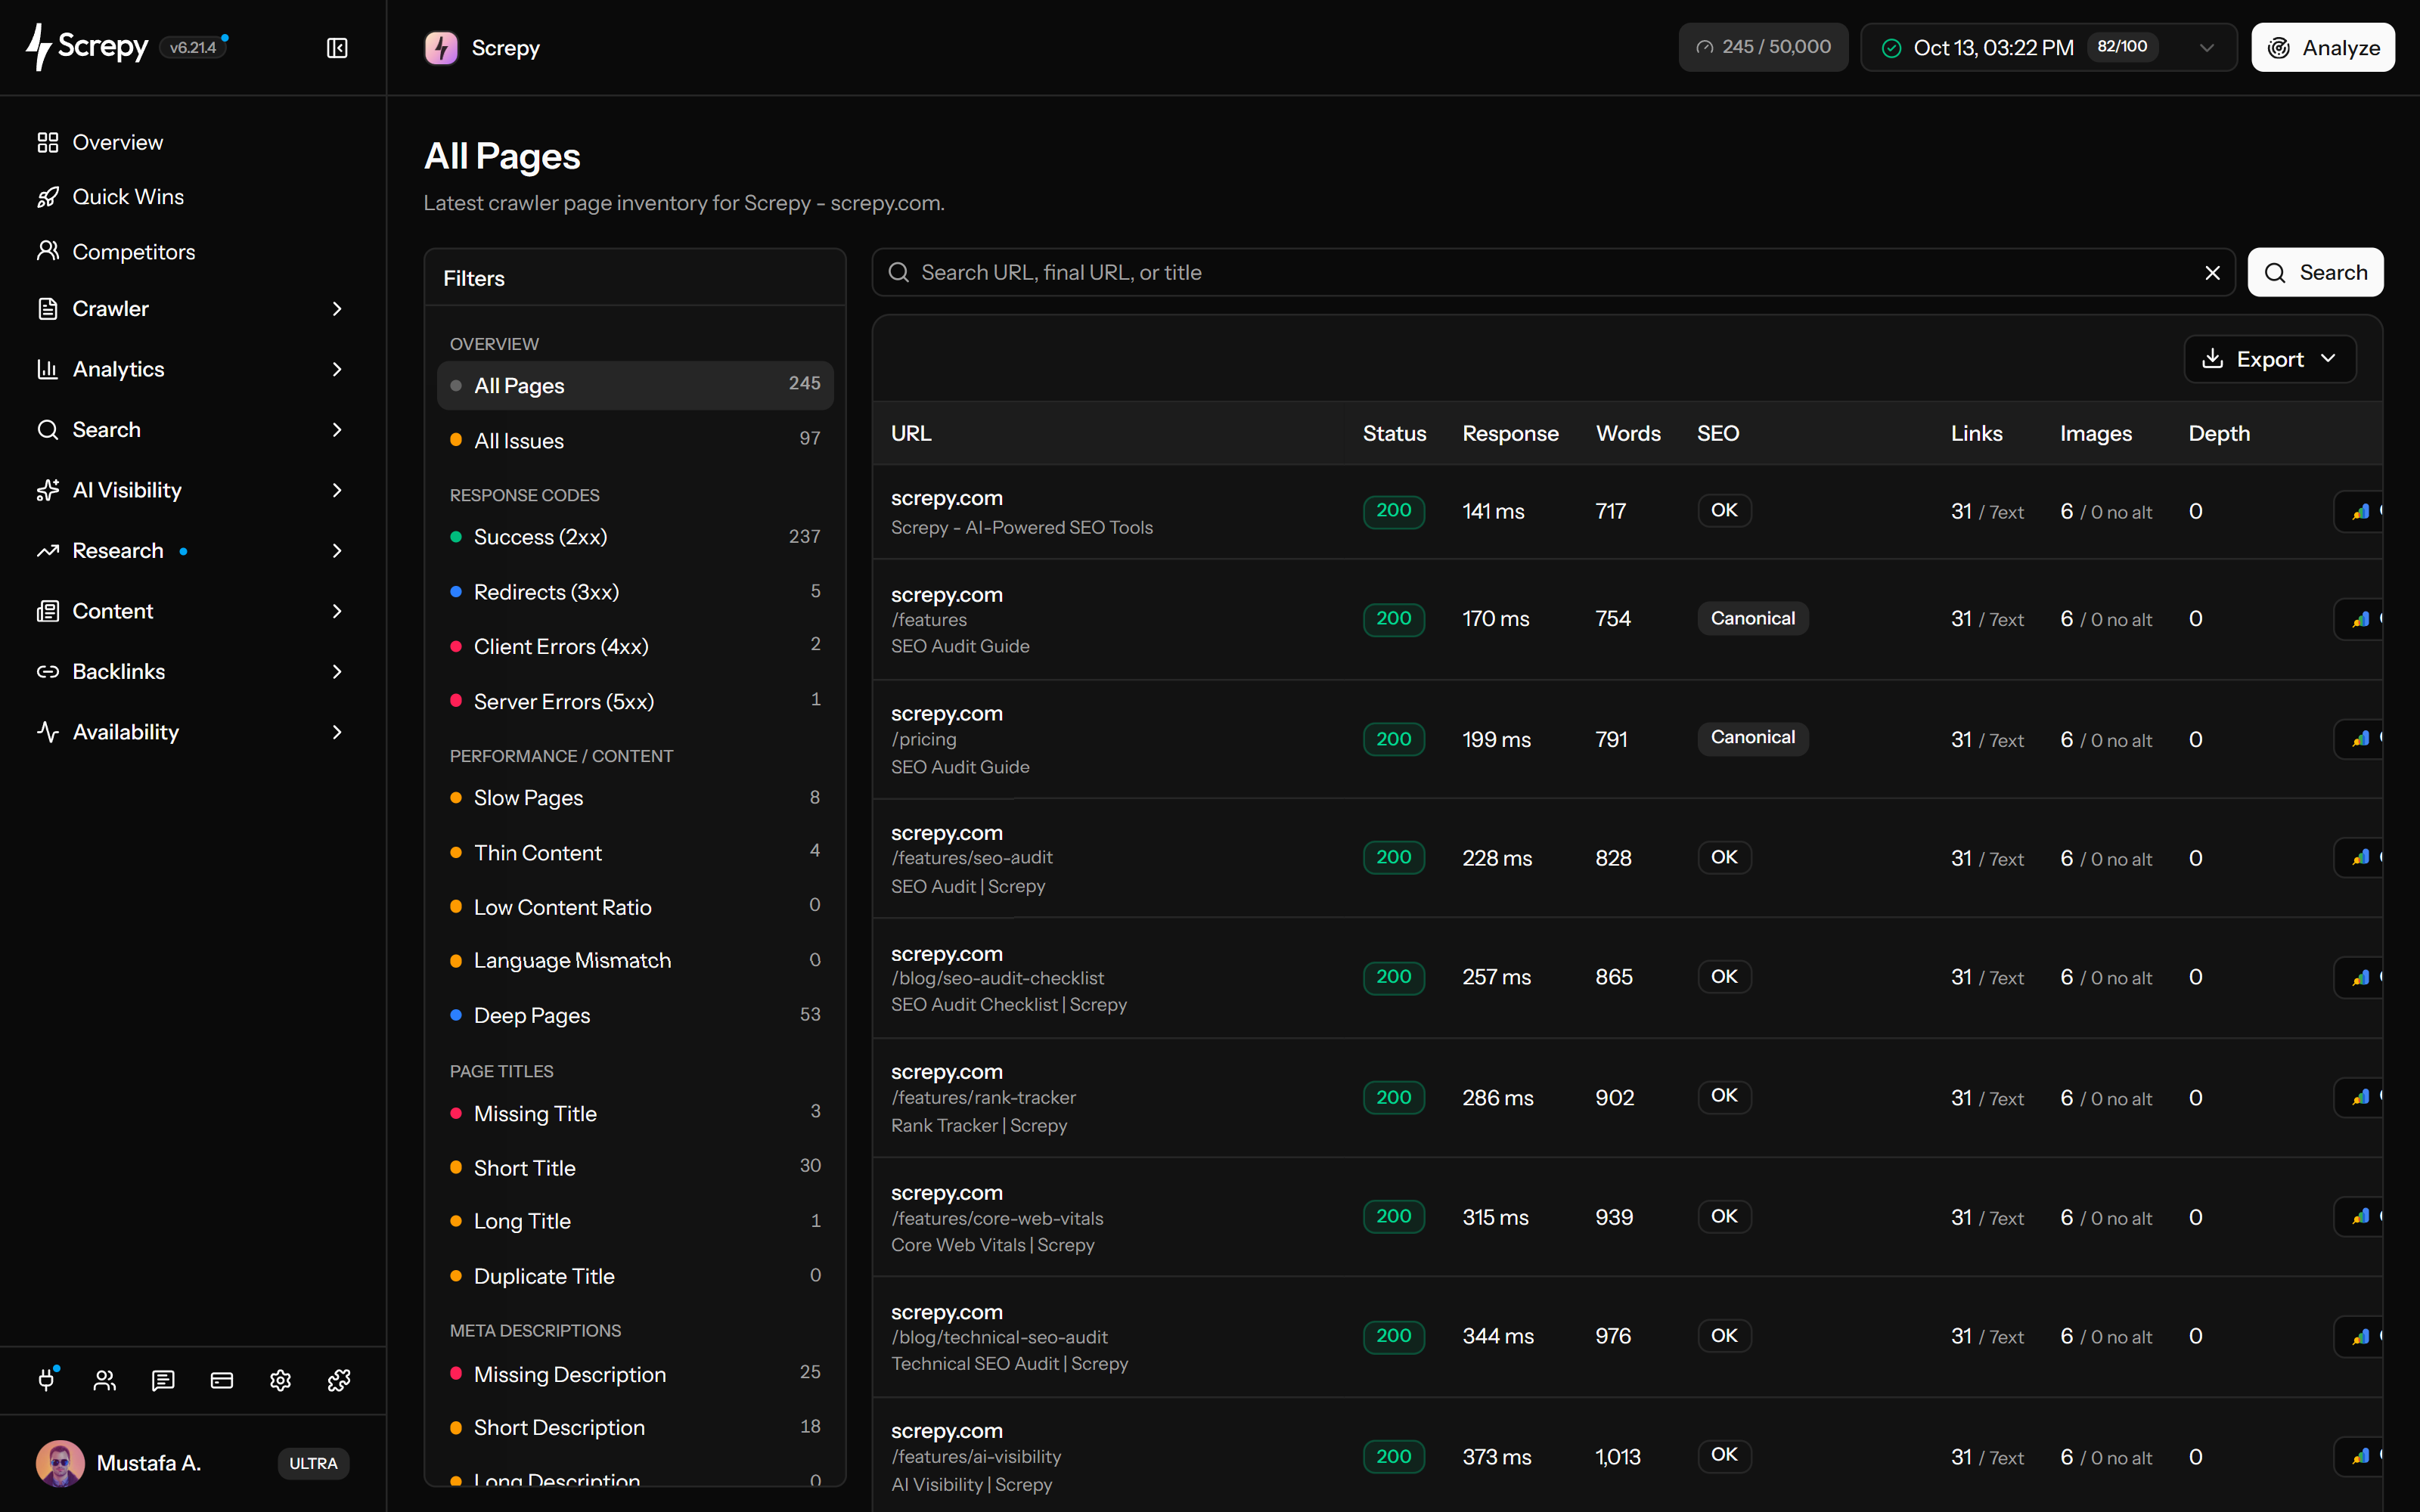


Screpy zaczyna od witryny projektu i podąża dostępnymi linkami wewnętrznymi w chmurze. Pierwsze skanowanie rusza podczas konfiguracji; później użyj Analizuj w raporcie Strony, Linki lub Obrazy, aby utworzyć nowy spis.
Nawigacja po stronie klienta może ukrywać ważne linki w początkowym HTML. Włącz JavaScript, gdy skrypty tworzą istotną treść lub nawigację; pozostaw go wyłączonym, jeśli serwer już zwraca potrzebny HTML.
<main id="app">
  <script />
</main>Zakres odkrywania i tempo żądań rozwiązują różne problemy. Głębokość określa śledzone poziomy linków wewnętrznych, a współbieżność i opóźnienie regulują obciążenie serwera. Większa głębokość nie odkryje strony bez linków.
example.com3
//shop//shop/linen/Zrozum, jak kategoria, produkt lub artykuł łączy się z witryną przez zapisane URL i linki. Używaj relacji stron źródłowych do badania głębokiej treści, starej nawigacji i ścieżek prowadzących przez przekierowania.
Utwórz plik roboczy z rekordów potrzebnych zespołowi. Filtruj wybrane skanowanie przed eksportem zamiast przekazywać całą witrynę, gdy zadanie dotyczy jednego szablonu, statusu odpowiedzi lub wzorca plików.
Zakończone skanowanie zapisuje witrynę tak, jak była osiągalna w danym momencie. Po zmianie nawigacji lub migracji uruchom nowe, aby sprawdzić odkrywanie i cele; stare rekordy nie aktualizują się automatycznie ze zmianami witryny.
Połącz asystenta AI z serwerem SEO MCP Screpy. Zapytaj o ostatni ukończony crawl, sprawdź dotknięte problemem strony i ustal kolejność prac nad technicznym SEO.
Zachowaj widoczny zakres, sprawdź rekordy stojące za wzorcem, napraw implementację i użyj kolejnego crawlu do potwierdzenia wyniku.
Potwierdź początkowy URL, limit adresów, głębokość linków, tryb JavaScript, współbieżność, opóźnienie żądań, reguły robots i dostęp crawlera. Te ustawienia określają zakres migawki.
Screpy podąża dostępnymi ścieżkami wewnętrznymi i zapisuje każdy odkryty URL, odpowiedź, głębokość, cel, relację linku oraz dane stron i obrazów w zakresie.
Użyj raportów Pages, Links i Images, aby przejść od sumy do reprezentatywnych URL-i, stron źródłowych, przekierowań, metadanych, canonicali lub użycia obrazów przed wyborem poprawki.
Uruchom kolejny crawl po zmianach witryny. Zachowaj porównywalny zakres i ustawienia, a następnie sprawdź, czy właściwe URL-e i wzorzec zmieniły się z właściwej przyczyny.
Dane crawlu są najbardziej użyteczne, gdy zespół wie, co się zmieniło. Utwórz bazę przed ryzykowną pracą i porównywalną migawkę po wdrożeniu.
Zapisz ważne URL-e, przekierowania, końcowe cele, canonicale i ścieżki wewnętrzne przed uruchomieniem, a potem przecrawluj nową strukturę w tym samym zakresie.
Używaj renderowania JavaScript, gdy nawigacja lub istotna treść strony powstaje w przeglądarce, a następnie potwierdź obecność tych URL-i w inwentarzu crawlu.
Sprawdzaj głębokość crawlu, strony źródłowe, anchory, atrybuty i powtarzające się ścieżki nawigacji, aby znaleźć ważną treść słabo połączoną lub trudną do odkrycia.
Wykonuj crawl ponownie po zmianach routingu, nawigacji, CMS, szablonu i komponentu, aby wykryć powtarzające się regresje techniczne.
Porównaj Screpy z Screaming Frog, gdy model wdrożenia, kontrola crawlu, własna ekstrakcja, cykliczny monitoring, dostęp zespołu i raportowanie wpływają na decyzję.
Użyj SEO Crawler do mapowania ścieżek odkrywania i sprawdzania rekordów stron, linków oraz obrazów. Użyj Website Audit, gdy zespół potrzebuje grup ustaleń, priorytetów problemów i szerszego workflow zdrowia technicznego.
Skonfiguruj crawl w chmurze, zmapuj osiągalne URL-e i sprawdzaj surowe rekordy Pages, Links i Images stojące za wzorcami technicznymi.
Zamień zakończony crawl w zgrupowane ustalenia, wzorce dotkniętych URL-i, priorytety, eksporty i powtarzalny workflow weryfikacji poprawek.
Wspólne szablony i zmienne zestawy URL-i tworzą inne ryzyka dla witryn SaaS i katalogów e-commerce.
Sprawdzaj landing pages, dokumentację, wspólne szablony i regresje wydań jako jedną powierzchnię pozyskiwania.
Audytuj typy stron kategorii i produktów, uszkodzone ścieżki zakupowe oraz strukturalne zmiany katalogu.
Dokumentacja Screpy
Skorzystaj z poradników Screpy, aby konfigurować zakres crawlu, zezwalać na dostęp crawlera, interpretować raporty Pages, Links i Images oraz diagnozować niepełne wyniki.
Poznaj odkrywanie crawlu, zakres, renderowanie JavaScript, dostęp, tempo żądań, raporty, migawki i różnicę między danymi crawlu a audytem witryny.
SEO crawler zaczyna od URL-a witryny, podąża dostępnymi linkami wewnętrznymi w określonym zakresie i zapisuje informacje techniczne o osiągniętych stronach oraz zasobach. Inwentarz pomaga badać ścieżki odkrywania, kody odpowiedzi, przekierowania, canonicale, linki wewnętrzne, metadane, obrazy i powtarzalne wzorce.
Pages zapisuje crawlowane URL-e oraz ich odpowiedź, głębokość, metadane, nagłówki, canonical, indeksowalność, treść, dane strukturalne, sygnały społecznościowe i powiązane dane. Links łączy cele ze statusem, anchorami, atrybutami, użyciem i stronami źródłowymi. Images grupuje źródła obrazów z odpowiedzią, tekstem alt, wymiarami, atrybutami dostarczania i użyciem na stronie.
Tak. Współbieżność kontroluje liczbę jednoczesnych żądań. Opóźnienie jest dostępne przy współbieżności 1; przy większej wartości zapisane opóźnienie wynosi zero. Zmniejsz nacisk żądań, jeśli serwer ogranicza ruch automatyczny, a następnie sprawdź, czy kolejny crawl otrzymuje odpowiedzi prawdziwych stron.
Maksymalna liczba URL-i ogranicza liczbę odkrytych adresów zapisywanych przez crawl. Głębokość określa liczbę poziomów linków wewnętrznych śledzonych od strony startowej. Zwiększenie ustawień nie naprawi zablokowanego dostępu, brakujących linków, przekierowań, limitów ani nieużytecznych odpowiedzi.
Tak. Raport Links pomaga znaleźć nieudane lub przekierowane cele i prześledzić każdy do crawlowanych stron, które się do niego odwołują. Daje to deweloperom i redaktorom konkretną stronę źródłową, wspólny komponent lub szablon do naprawy.
Odpowiadają na różne pytania. Search Console raportuje wydajność wyszukiwania Google i wybrane informacje indeksowania. SEO crawler aktywnie podąża linkami wewnętrznymi i tworzy inwentarz techniczny do sprawdzenia, zanim Google zgłosi problem lub zmieni się ruch.
Screpy zaczyna od witryny projektu i podąża dostępnymi linkami wewnętrznymi w skonfigurowanym limicie URL-i i głębokości crawlu. Strony może brakować, gdy nie ma do niej linku, leży poza głębokością, jest zablokowana, przekierowuje poza host projektu, zależy od renderowania JavaScript lub zwraca nieużyteczną treść.
Tak. Każdy zakończony crawl to datowana migawka. Po wydaniu lub poprawce wykonaj nowy crawl i porównaj migawki przy równoważnym zakresie i ustawieniach, aby nie pomylić zmiany pokrycia lub liczby problemów z inną konfiguracją.
Screpy oferuje opcjonalne ustawienie JavaScript dla witryn, których ważne linki lub treści powstają w przeglądarce. Renderowanie może poprawić odkrywanie, ale nie omija reguł robots, uwierzytelniania, firewalli, wyzwań botów, limitów czasu ani skonfigurowanego zakresu crawlu.
SEO crawler tworzy inwentarz techniczny: odkryte URL-e, odpowiedzi, ścieżki, dane stron, linki, obrazy i kontekst crawlu. Website Audit interpretuje crawl jako grupy ustaleń, dotknięte wzorce, priorytety i workflow weryfikacji poprawek. Crawler służy do odkrywania i surowych rekordów, a audyt do szerszego przeglądu zdrowia i priorytetowych działań.
Crawler musi otrzymać prawdziwą stronę bez logowania, CAPTCHA, wyzwania przeglądarki, blokady firewalla lub odrzucenia limitu. Zezwól ScrepyBot i udokumentowanemu IP crawlera w każdej warstwie, potwierdź dostęp do robots.txt i sprawdź, że poprawna odpowiedź zawiera prawdziwy HTML strony.
Nie. Dane crawlu pomagają odkrywać i weryfikować warunki techniczne, ale pozycje zależą także od trafności, jakości treści, autorytetu, konkurencji, popytu, indeksowania i interpretacji strony przez wyszukiwarki. Traktuj filtry crawlera jako dowody do analizy, nie automatyczne instrukcje rankingu.
Zrozum Super Intelligence i połącz audyty, badania, pozycje oraz widoczność AI w praktycznym procesie Screpy.