

Wydawcy i biblioteki treści
Sprawdź, czy zweryfikowane rodziny crawlerów wyszukiwarek i AI żądają witryny oraz czy ważne ścieżki treści zwracają odpowiedzi inne niż 2xx.
Połącz strefę Cloudflare przypisaną do projektu Screpy i przeanalizuj aktywność zweryfikowanych botów z ostatnich siedmiu dni. Porównuj kategorie crawlerów, wydawców, transfer danych, trendy żądań, udane odpowiedzi i adresy URL inne niż 2xx, nie myląc wizyty crawlera z cytowaniem przez AI.
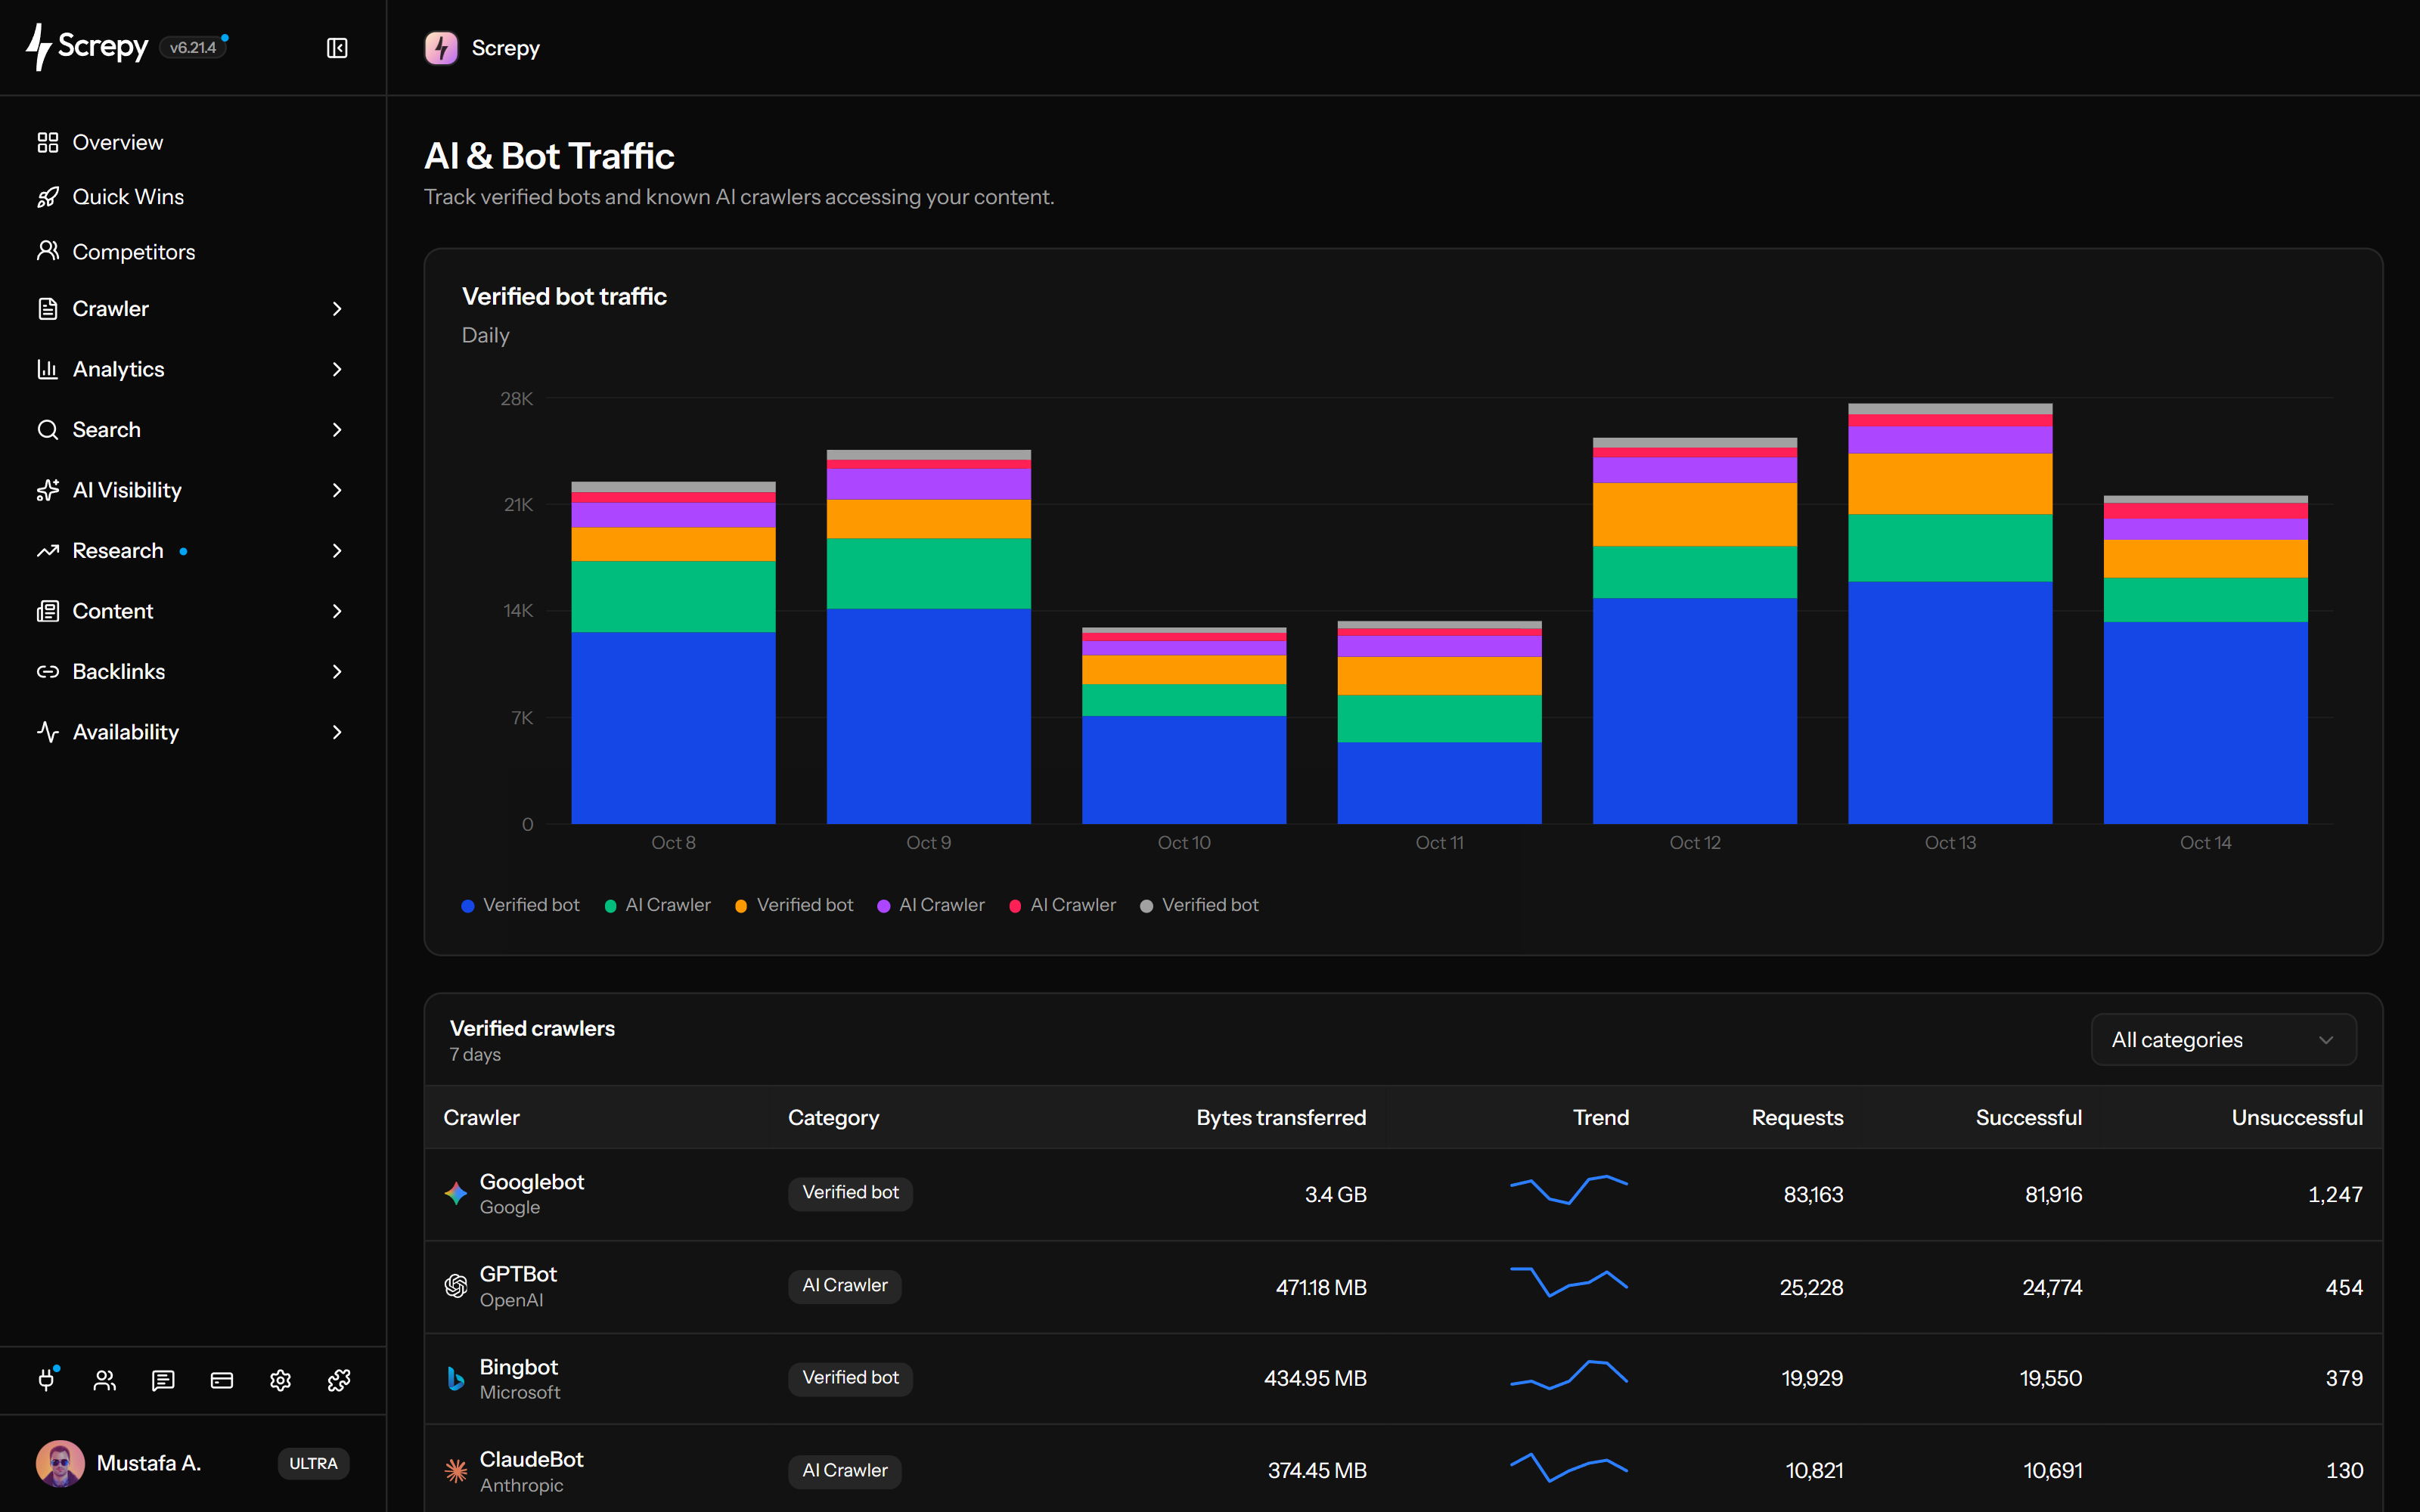


Połącz Cloudflare, aby odczytać żądania zweryfikowanych botów w strefie przypisanej do projektu Screpy. Zanim zinterpretujesz pustą tabelę, sprawdź połączenie i zakres raportu.
 Screpy
Znajdź rodziny crawlerów wyszukiwarek i AI obecne w połączonych danych. Nazwa i wydawca pomagają ustalić nadawcę żądań przed analizą ich liczby lub odpowiedzi.
Żądania
42Znajdź skupiska żądań na wykresie kategorii, a potem sprawdź miniwykresy crawlerów z tych samych siedmiu dni. Obecny widok używa stałego okresu bez dowolnego wyboru dat.
Żądania
1860Odczytuj liczbę żądań razem z przesłanymi bajtami. Opisują wielkość ruchu i rozmiar odpowiedzi, nie unikalne osoby, popularność odpowiedzi AI ani wartość treści.
Oddziel klasyfikację odpowiedzi od diagnozy. Kolumna nieudanych żądań obejmuje wszystkie odpowiedzi inne niż 2xx; wysoka liczba sama w sobie nie oznacza awarii witryny.
Status HTTP
200GET /HTTP/2 200Otwórz liczbę odpowiedzi innych niż 2xx dla crawlera, aby zobaczyć ich ścieżki. Ścieżka, status i częstotliwość dają zespołom SEO lub technicznym konkretny punkt do analizy.
WybranoGPTBot
| Ścieżka URL | Status HTTP | Żądania |
|---|---|---|
/guides/seo | 404 | 128 |
/guides/seo | 301 | 36 |
/setup | 503 | 12 |
Pytaj przez SEO MCP o Quick Wins z dostępnych danych wyszukiwania, crawla i ruchu połączonego Cloudflare. Dostęp obejmuje te możliwości, nie cały panel analityki ani ruchu botów.
Zacznij od najbardziej aktywnych kategorii, wybierz crawler i sprawdź powtarzające się ścieżki z odpowiedziami innymi niż 2xx. Zweryfikuj zamierzoną odpowiedź, zanim przekażesz konkretny problem ścieżki lub dostępu odpowiedzialnemu zespołowi.
Użyj aktywnego tokena API mogącego wyświetlać strefę witryny i odczytywać analitykę, a następnie potwierdź dopasowanie domeny projektu do połączonej strefy.
Przed otwarciem wierszy crawlerów szukaj stałej aktywności, nagłych skoków, brakujących oczekiwanych kategorii lub dużego segmentu Inne.
Użyj żądań, przesłanych bajtów, trendu godzinowego, udanych odpowiedzi 2xx i liczby innych niż 2xx, aby wybrać crawler wymagający uwagi.
Przejrzyj każdą powtarzaną ścieżkę i status, potwierdź jej celowość, zbadaj nieoczekiwane odpowiedzi i użyj późniejszych danych ruchu, aby potwierdzić zmianę zachowania.
Widok jest najbardziej przydatny, gdy zespół ma wystarczający kontekst witryny, aby ocenić, czy wzorzec ruchu lub odpowiedź HTTP jest oczekiwana.
Sprawdź, czy zweryfikowane rodziny crawlerów wyszukiwarek i AI żądają witryny oraz czy ważne ścieżki treści zwracają odpowiedzi inne niż 2xx.
Dodaj dane o rzeczywistych żądaniach do rozmów o crawlowności, nie przedstawiając aktywności crawlera jako dowodu indeksowania, cytowań ani widoczności odpowiedzi.
Przekaż konkretny crawler, ścieżkę, status HTTP i liczbę żądań, gdy trasa aplikacji lub wdrożenie wymaga analizy technicznej.
Połącz każdą strefę klienta lub witryny z właściwym projektem Screpy i stosuj tę samą metodę przeglądu dla osobnych usług.
Jasne ograniczenia sprawiają, że dane są bezpieczniejsze w rozmowach o SEO, treściach, inżynierii i wyszukiwaniu AI.
Żądanie zweryfikowanego crawlera rejestruje próbę dostępu i odpowiedź. Mogą wystąpić również żądania zablokowane; zapis nie dowodzi pobrania treści, indeksowania, trenowania, cytowania ani uwzględnienia w odpowiedzi AI.
Bieżący widok Screpy używa stałego okresu siedmiu dni z trendem godzinowym. Nie zapewnia dowolnych zakresów ani długoterminowej historii botów.
Widok bazuje na zweryfikowanych kategoriach botów dostępnych dla połączonej strefy. Nie jest eksploratorem surowych logów ani pełnym inwentarzem scraperów.
Screpy raportuje aktywność i wyniki odpowiedzi. Widok nie blokuje crawlerów, nie zmienia zasad dostępu, nie wysyła alertów ani nie eksportuje pełnego logu.
Użyj analityki crawlerów dla żądań witryny, AI Visibility dla monitorowanych odpowiedzi lub Website Audit przy powtarzającym się problemie odpowiedzi.
Przeglądaj siedem dni zweryfikowanych kategorii crawlerów, trendy żądań, transfer, wyniki odpowiedzi i ścieżki inne niż 2xx.
Monitoruj wybrane prompty pod kątem wzmianek marki, cytowań, domen źródłowych, pozycji odpowiedzi, sentymentu, konkurentów i udziału głosu.
Wykonaj crawl witryny, gdy żądania botów z odpowiedziami innymi niż 2xx wskazują na przekierowania, niedziałające adresy docelowe, problemy z linkami wewnętrznymi lub powtarzające się błędy szablonu.
Poznaj połączone źródło danych, stały okres raportowania, zakres zweryfikowanych crawlerów, logikę odpowiedzi, szczegóły URL-i i różnicę między dostępem crawlera a widocznością odpowiedzi AI.
Screpy wykorzystuje analitykę ze strefy Cloudflare dopasowanej do projektu, aby raportować zweryfikowany ruch botów z ostatnich siedmiu dni. Dashboard zawiera godzinowy trend kategorii i tabelę crawlerów z wydawcą, kategorią, przesłanymi bajtami, liczbą żądań, udanymi żądaniami, żądaniami non-2xx oraz trendem każdego crawlera.
Tabela zaczyna od ruchu sklasyfikowanego przez połączone źródło jako zweryfikowane boty. Screpy dodaje czytelne tożsamości znanych rodzin crawlerów, takich jak Googlebot, Bingbot, OpenAI, Anthropic, Perplexity, Apple, Meta i inne rozpoznane usługi, gdy ich żądania są obecne. Wiersze zależą od rzeczywistego ruchu strefy.
Nie. Screpy odczytuje dostępne zagregowane dane analityczne dopasowanej strefy Cloudflare; nie importuje surowych logów serwera ani nie pokazuje każdego zdarzenia żądania. Kategorie, sumy crawlerów i szczegóły ścieżek używają różnych grupowań i limitów źródła. Nie są pełnym rejestrem żądań i nie muszą dawać identycznych sum. Brakujące dane źródłowe są oznaczane jako niedostępne.
Nie. Analityka rejestruje żądanie i odpowiedź zweryfikowanego crawlera w okresie raportowania. Może obejmować żądania zablokowane, więc nie dowodzi nawet pobrania treści przez crawler. Nie potwierdza indeksowania, trenowania modelu, wzmianki marki, cytowania ani uwzględnienia w odpowiedzi. Użyj Widoczności w AI do analizy monitorowanych promptów i zapisanych odpowiedzi.
Otwórz liczbę non-2xx dla danego crawlera, sprawdź każdą ścieżkę i status HTTP, a następnie ustal, czy odpowiedź jest zamierzona. Nieoczekiwane przekierowania oraz odpowiedzi 4xx lub 5xx porównaj z aktywną route, linkami wewnętrznymi, celem canonical, konfiguracją crawlu i szerszym Website Audit przed zmianą.
Screpy uznaje odpowiedzi HTTP 2xx za udane. Odpowiedzi spoza zakresu 2xx są w tym widoku nieudane, więc szczegóły mogą obejmować przekierowania oraz błędy klienta i serwera. Przed poprawką sprawdź dokładny status.
Połącz aktywny token API Cloudflare, który może wyświetlać odpowiednią strefę i odczytywać jej analitykę. Screpy dopasuje domeny projektów do dostępnych stref. Jeśli token nie ma uprawnień analitycznych, domena projektu nie pasuje do strefy lub zbiór danych jest niedostępny, dashboard pokaże stan niedostępności.
Nie. To widok analityki i analizy. Kontrole dostępu, reguły firewalla, dyrektywy robots, alerty crawlerów, analityka odsyłaczy i eksporty CSV nie są zarządzane z tej strony Screpy.