

Herausgeber und Inhaltsbibliotheken
Sehen Sie, ob verifizierte Such- und KI-Crawlerfamilien die Website anfordern und ob wichtige Inhaltspfade Nicht-2xx-Antworten liefern.
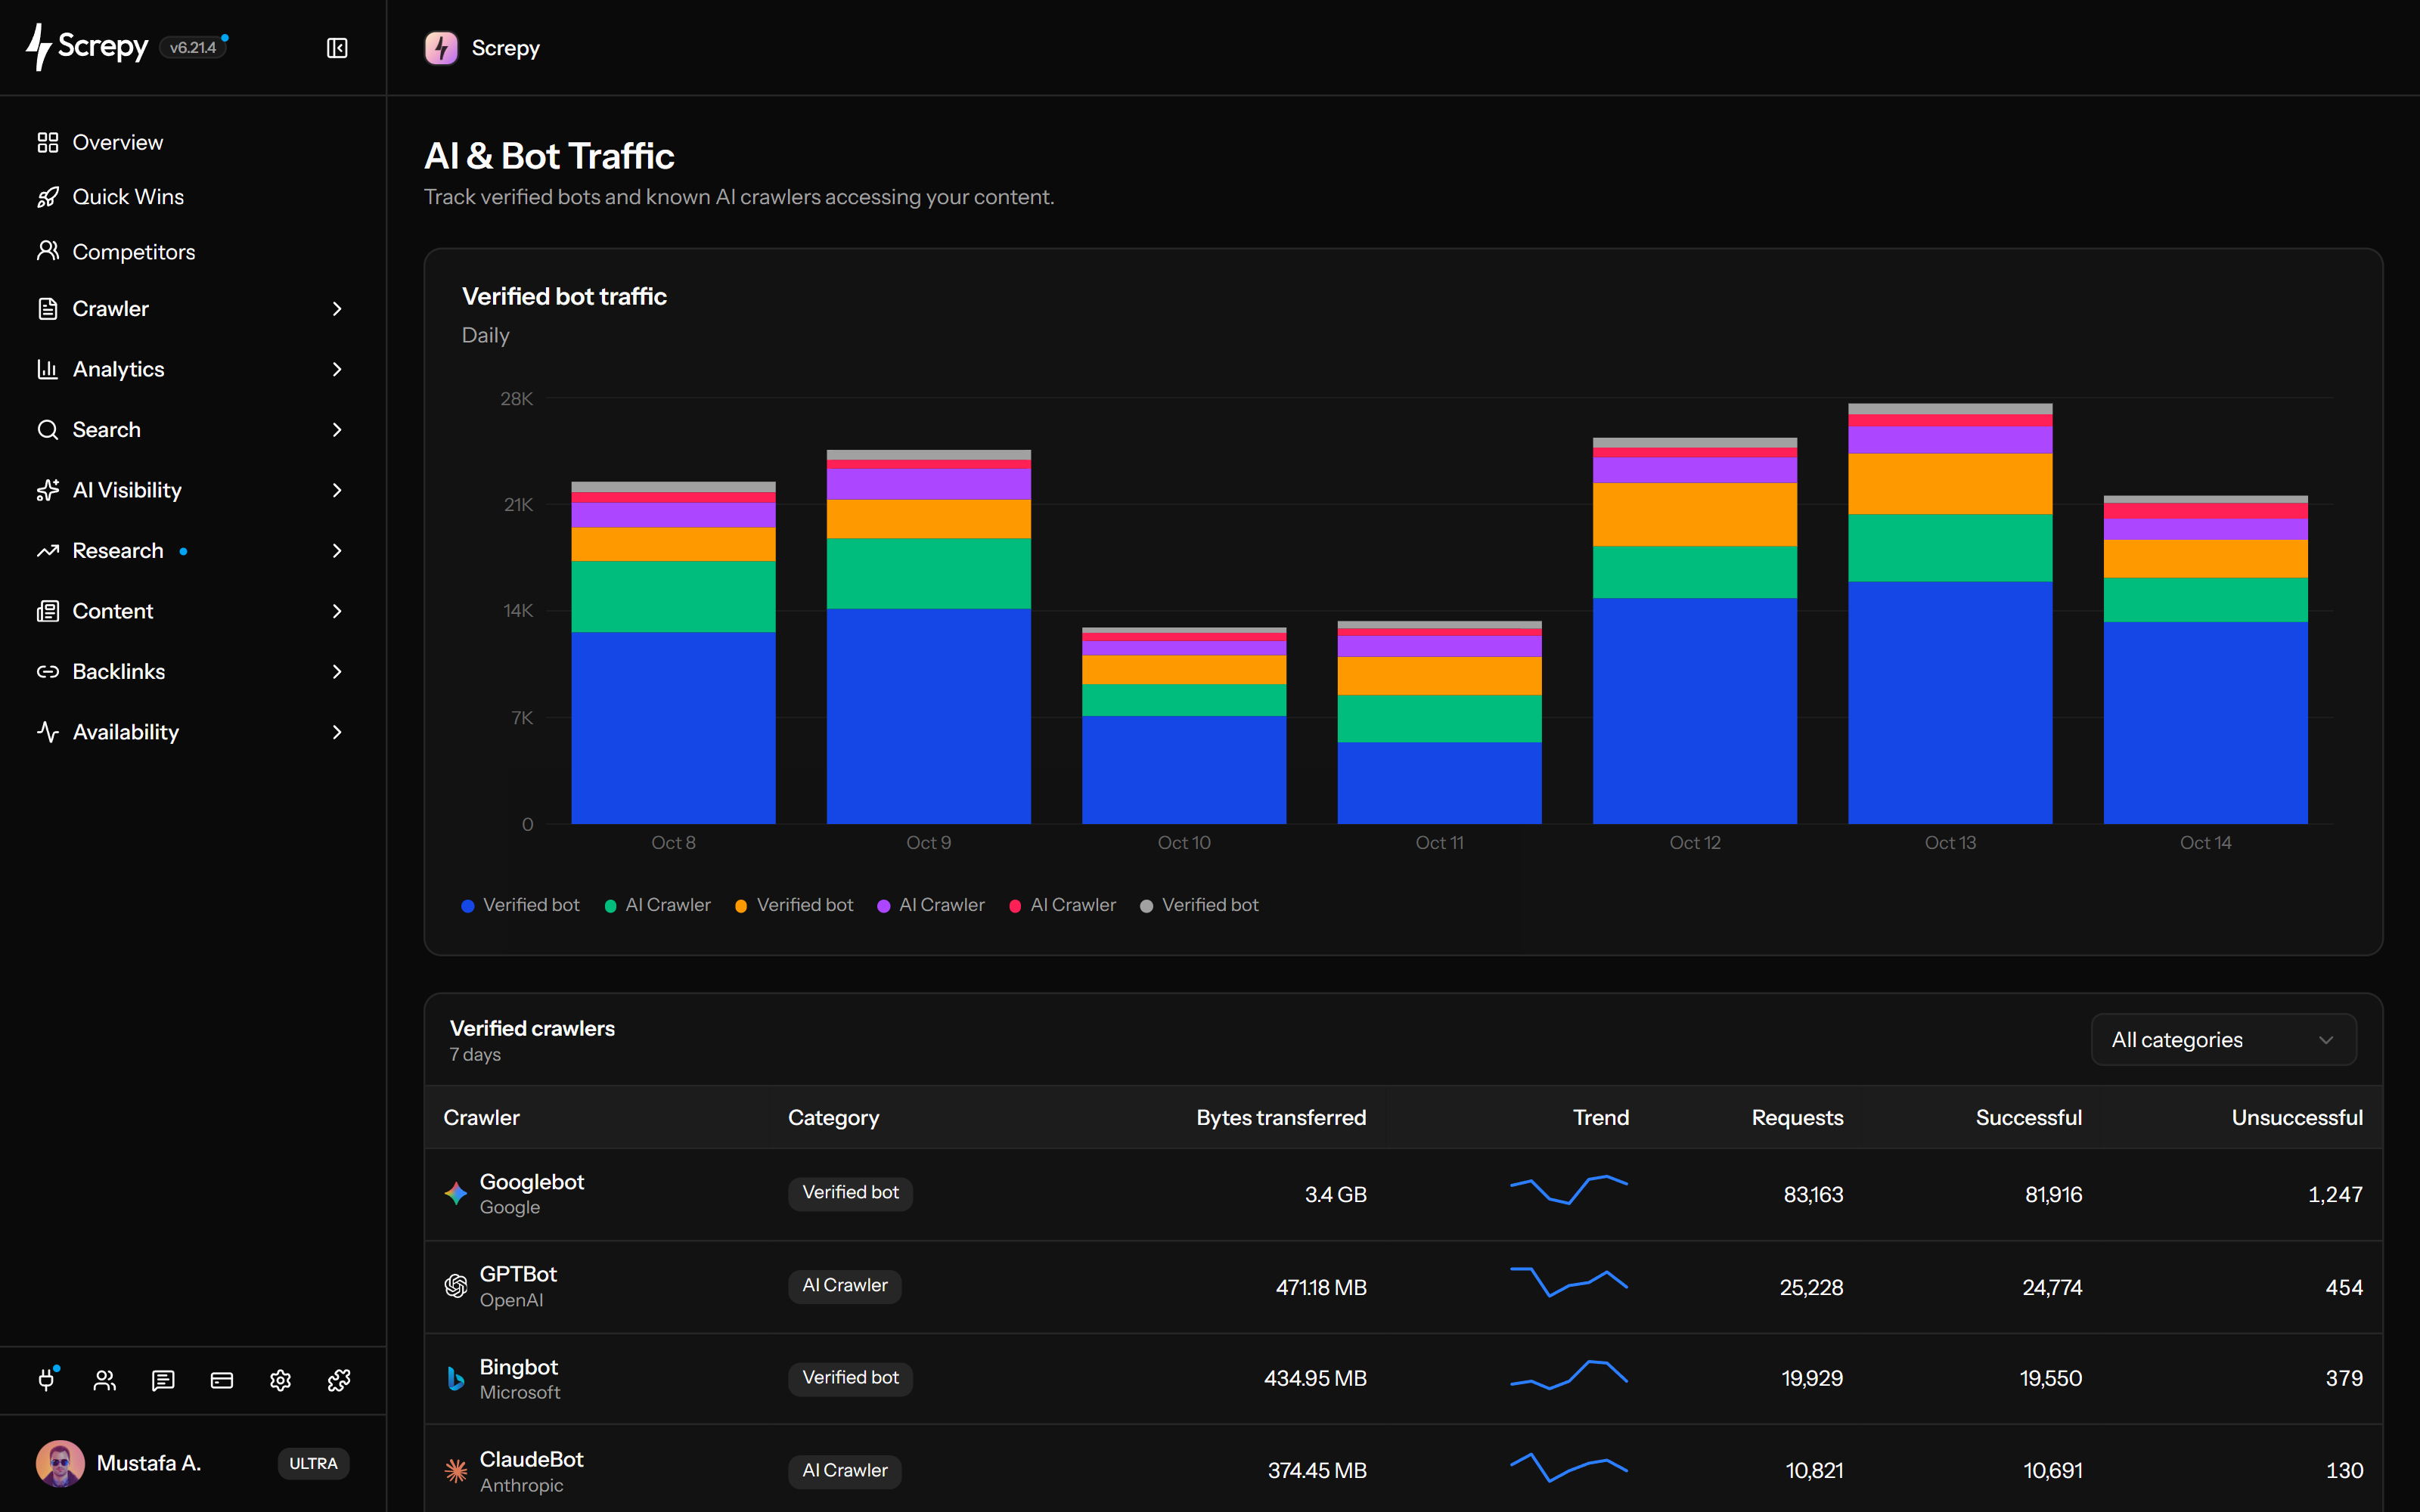
Verbinden Sie die zur Screpy-Projektwebsite passende Cloudflare-Zone und prüfen Sie die letzten sieben Tage verifizierter Bot-Aktivität. Vergleichen Sie Crawler-Kategorien, Herausgeber, Datenübertragung, Anfrageverläufe, erfolgreiche Antworten und Nicht-2xx-URLs, ohne einen Crawler-Besuch mit einem KI-Zitat zu verwechseln.


Verbinden Sie Cloudflare, um verifizierte Bot-Anfragen für die Zone Ihres Screpy-Projekts auszuwerten. Prüfen Sie Verbindung und Datenumfang, bevor Sie eine leere Tabelle interpretieren.
 Screpy
Erkennen Sie Suchmaschinen- und KI-Crawler, die in den verbundenen Daten vorkommen. Namen und Herausgeber helfen zu klären, wer Anfragen gesendet hat, bevor Sie Umfang oder Antworten untersuchen.
Anfragen
42Erkennen Sie gebündelte Anfragen im Kategoriediagramm und prüfen Sie dann die Crawler-Sparklines für denselben Sieben-Tage-Zeitraum. Die aktuelle Ansicht verwendet ein festes Fenster statt einer freien Datumsauswahl.
Anfragen
1.860Lesen Sie Anfragezahlen und übertragene Bytes gemeinsam. Sie beschreiben Traffic-Volumen und Antwortgröße, nicht eindeutige Personen, die Beliebtheit von KI-Antworten oder den Wert Ihrer Inhalte.
Trennen Sie Antwortklassifizierung und Diagnose. Die Spalte für erfolglose Anfragen enthält alle Nicht-2xx-Antworten; eine hohe Zahl beweist daher keinen Website-Defekt.
HTTP-Status
200GET /HTTP/2 200Öffnen Sie die Nicht-2xx-Zahl eines Crawlers, um die betroffenen angefragten Pfade zu sehen. Pfad, Status und Häufigkeit geben SEO- oder Entwicklungsteams einen konkreten Ausgangspunkt.
AusgewähltGPTBot
| URL-Pfad | HTTP-Status | Anfragen |
|---|---|---|
/guides/seo | 404 | 128 |
/guides/seo | 301 | 36 |
/setup | 503 | 12 |
Fragen Sie über SEO MCP nach Quick Wins aus vorhandenen Such-, Crawl- und verbundenen Cloudflare-Trafficsignalen. Der Cloudflare-Zugriff umfasst diese Chancen, nicht das gesamte Analytics- oder Bot-Traffic-Dashboard.
Beginnen Sie bei den aktivsten Kategorien, wählen Sie einen Crawler und prüfen Sie wiederkehrende Nicht-2xx-Pfade. Kontrollieren Sie die beabsichtigte Antwort, bevor Sie ein konkretes Routen- oder Zugriffsproblem an das zuständige Team weitergeben.
Verwenden Sie ein aktives API-Token, das Website-Zone auflisten und Analysen lesen kann, und bestätigen Sie die passende Zone für die Projektdomain.
Achten Sie auf anhaltende Aktivität, plötzliche Spitzen, fehlende erwartete Kategorien oder einen großen Sonstige-Anteil, bevor Sie einzelne Crawlerzeilen öffnen.
Nutzen Sie Anfragen, übertragene Bytes, Stundenverlauf, erfolgreiche 2xx-Antworten und Nicht-2xx-Zahlen, um den wichtigsten Crawler auszuwählen.
Prüfen Sie wiederholte Pfade und Status, bestätigen Sie die Absicht, untersuchen Sie unerwartete Antworten und nutzen Sie spätere Trafficdaten zur Bestätigung.
Die Ansicht ist besonders nützlich, wenn ein Team genügend Websitekontext besitzt, um ein Trafficmuster oder eine HTTP-Antwort als erwartet zu beurteilen.
Sehen Sie, ob verifizierte Such- und KI-Crawlerfamilien die Website anfordern und ob wichtige Inhaltspfade Nicht-2xx-Antworten liefern.
Ergänzen Sie Crawlability-Diskussionen um echte Anfragebelege, ohne Crawler-Aktivität als Beweis für Indexierung, Zitate oder Antwortsichtbarkeit darzustellen.
Übergeben Sie Crawler, Pfad, HTTP-Status und Anfragezahl, wenn eine Anwendungsroute oder ein Deployment technische Untersuchung braucht.
Verbinden Sie jede Kunden- oder Website-Zone mit dem passenden Screpy-Projekt und verwenden Sie dieselbe Prüfmethode für getrennte Properties.
Klare Grenzen machen den Nachweis in SEO-, Content-, Engineering- und KI-Suche-Gesprächen sicherer nutzbar.
Eine verifizierte Crawler-Anfrage erfasst einen Zugriffsversuch und seine Antwort. Auch blockierte Anfragen können enthalten sein; der Eintrag beweist weder Inhaltsdownload, Indexierung, Training, Zitation noch Aufnahme in eine KI-Antwort.
Die aktuelle Screpy-Ansicht nutzt einen festen Sieben-Tage-Zeitraum mit Stundenverlauf. Beliebige Zeiträume oder langfristige Bot-Historie werden nicht versprochen.
Die Ansicht basiert auf verifizierten Bot-Kategorien der verbundenen Zone. Sie ist kein Explorer für rohe Serverlogs und kein vollständiges Verzeichnis aller Scraper.
Screpy berichtet Aktivität und Antwortstatus. Die aktuelle Ansicht blockiert keine Crawler, ändert keine Zugriffsregeln, sendet keine Bot-Warnungen und exportiert kein vollständiges Anfrageprotokoll.
Nutzen Sie Crawler-Analysen für Website-Anfragen, AI Visibility für überwachte Antworten oder Website-Audit, wenn ein wiederkehrendes Antwortproblem eine breitere technische Prüfung benötigt.
Prüfen Sie sieben Tage verifizierte Crawler-Kategorien, Anfrageverläufe, Übertragungsvolumen, Antwortstatus und Nicht-2xx-Pfade.
Überwachen Sie ausgewählte Prompts auf Markennennungen, Zitate, Quelldomains, Antwortposition, Stimmung, Wettbewerber und Share of Voice.
Crawlen Sie die gesamte Website, wenn Nicht-2xx-Bot-Anfragen auf Weiterleitungen, defekte Ziele, interne Linkprobleme oder wiederkehrende Templatefehler hinweisen.
Verstehen Sie Datenquelle, festen Berichtszeitraum, Umfang verifizierter Crawler, Antwortlogik, URL-Drilldown und den Unterschied zwischen Crawler-Zugriff und KI-Antwortsichtbarkeit.
Screpy nutzt Analysen der einem Projekt zugeordneten Cloudflare-Zone und berichtet die letzten sieben Tage verifizierten Bot-Traffic. Das Dashboard enthält einen stündlichen Kategorietrend und eine Crawler-Tabelle mit Herausgeber, Kategorie, übertragenen Bytes, Anfragezahlen, erfolgreichen und Nicht-2xx-Anfragen sowie eigenem Crawlerverlauf.
Öffnen Sie die Nicht-2xx-Zahl des betroffenen Crawlers, prüfen Sie jeden Pfad und HTTP-Status und entscheiden Sie, ob die Antwort beabsichtigt ist. Unerwartete Weiterleitungen, 4xx- oder 5xx-Antworten können Sie vor einer Änderung mit Live-Route, internen Links, kanonischem Ziel, Crawl-Konfiguration und einem Website-Audit abgleichen.
Nein. Screpy liest verfügbare aggregierte Analytics für die zugeordnete Cloudflare-Zone, verarbeitet aber keine Rohlogs und zeigt nicht jedes Anfrageereignis. Kategorien, Crawler-Summen und Pfaddetails verwenden unterschiedliche Gruppierungen und Quellenlimits. Sie sind daher kein vollständiges Anfrageprotokoll und müssen nicht exakt dieselben Summen ergeben. Fehlende Quelldaten werden als nicht verfügbar angezeigt.
Screpy zählt HTTP-2xx-Antworten als erfolgreich. Antworten außerhalb von 2xx gelten in dieser Ansicht als erfolglos; der Drilldown kann daher Weiterleitungen ebenso wie Client- und Serverfehler enthalten. Prüfen Sie den exakten Status, bevor Sie eine Korrektur einleiten.
Die Tabelle beginnt mit von der verbundenen Quelle als verifizierte Bots kategorisiertem Traffic. Screpy ergänzt bekannte Familien wie Googlebot, Bingbot, OpenAI, Anthropic, Perplexity, Apple, Meta und andere erkannte Dienste, wenn deren Anfragen vorhanden sind. Die Zeilen hängen vom tatsächlichen Zonen-Traffic ab.
Verbinden Sie ein aktives Cloudflare-API-Token, das die relevante Zone auflisten und Analysen lesen kann. Screpy ordnet Projektdomains zugänglichen Zonen zu. Fehlen Berechtigungen, passt keine Zone oder ist der Datensatz nicht verfügbar, zeigt das Dashboard den Status nicht verfügbar statt Ersatzdaten.
Nein. Dieses Feature dient der Analyse und Untersuchung. Zugriffskontrollen, Firewallregeln, Robots-Direktiven, Crawler-Warnungen, Referral-Analysen und CSV-Exporte werden auf dieser Screpy-Seite nicht verwaltet.
Nein. Die Analytics erfassen Anfrage und Antwort eines verifizierten Crawlers im Berichtszeitraum. Auch blockierte Anfragen können enthalten sein; der Eintrag beweist daher nicht einmal, dass Inhalte heruntergeladen wurden. Er belegt weder Indexierung, Modelltraining, Markenerwähnung, Zitation noch Aufnahme in eine Antwort. Nutzen Sie KI-Sichtbarkeit für überwachte Prompts und gespeicherte Antworten.