


Vor und nach einer Migration
Erfassen Sie Weiterleitungen, Canonicals, interne Pfade, wichtige Vorlagen und Crawl-Abdeckung vor dem Launch und vergleichen Sie die neue Website anschließend mit derselben Ausgangsbasis.
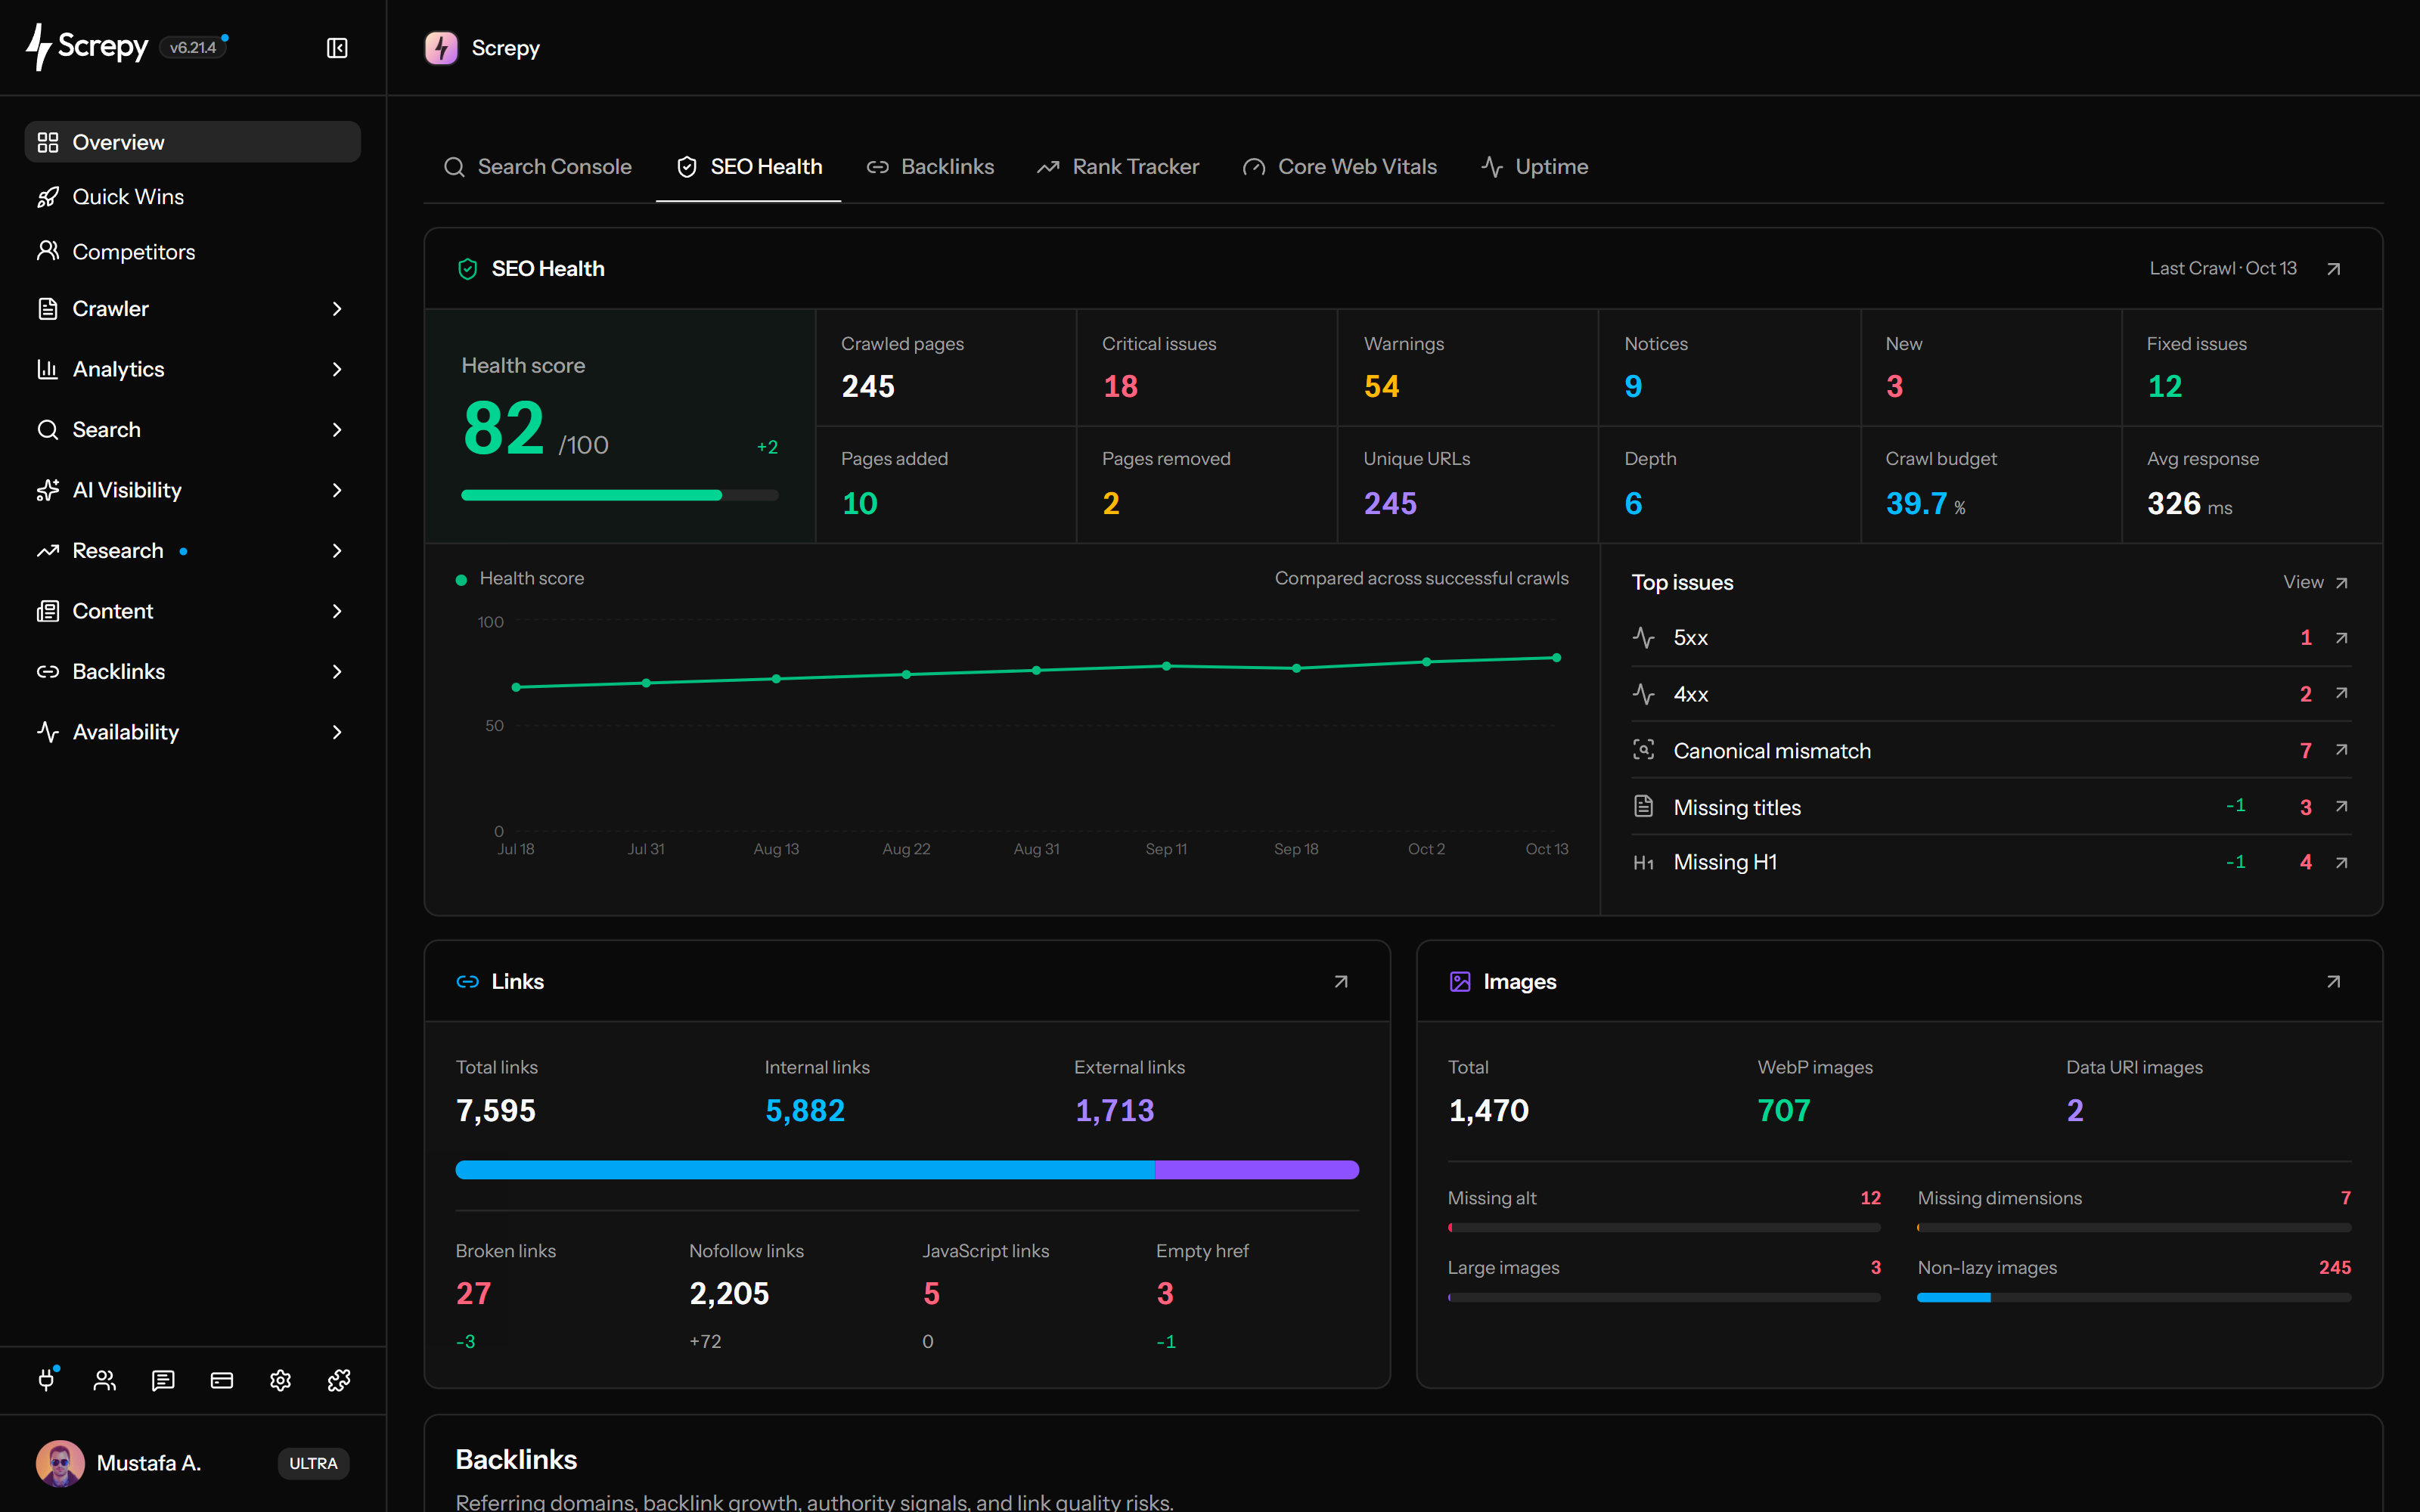
Verwandeln Sie einen vollständigen Crawl in ein Seiteninventar, gruppierte Ergebnisse und eine praktische Aufgabenliste. Prüfen Sie Crawlbarkeit, Statuscodes, Weiterleitungen, Canonicals, Metadaten, Überschriften, Links, Bilder, Antwortzeit, strukturierte Daten und Sicherheitssignale – und crawlen Sie anschließend erneut, um Änderungen zu bestätigen.


Beginnen Sie mit den URLs, die Suchmaschinen und Besucher erreichen müssen. Das Seiteninventar zeigt Antworten, Weiterleitungsziele und Crawltiefe für jede URL, damit sich eine defekte Produktadresse oder ein nicht erreichbarer Artikel gezielt untersuchen lässt.
/guides/seo200
Wiederholte Metadaten können auf eine gemeinsame Vorlage statt auf Hunderte einzelne Schreibfehler zurückgehen. Filtern Sie Titel und Beschreibungen, vergleichen Sie betroffene URLs und entscheiden Sie, ob die Korrektur die Vorlage oder den Seiteninhalt betrifft.
example.com › guides
SEO · TitelBeschreibungSehen Sie, wie jede gecrawlte Seite ihr Hauptthema darstellt. Überschriftenzahlen, Wortzahl und Inhaltsanteil helfen, einen unvollständigen Artikel von einer knappen Kontaktseite zu unterscheiden; verschiedene Seitenzwecke brauchen keine einheitliche Inhaltsvorgabe.
InhalteH1
Vergleichen Sie das Canonical-Ziel einer Seite mit der endgültigen URL des Crawls. Das ist besonders nach Migrationen hilfreich oder wenn Filter und Parameter mehrere Versionen desselben Inhalts erzeugen.
/shop?sort=new
/shop?filter=linen
/shop
Ein fehlerhaftes Ziel zeigt, was nicht funktioniert; die Quellseiten zeigen, wo die Korrektur nötig ist. Das Linkinventar verbindet jedes Ziel mit den verweisenden Seiten und Ankertexten, einschließlich wiederholter Navigations- und Footerlinks.
Quelle/guides
/old-pricing404/setup503Prüfen Sie Bild-URLs zusammen mit den Seiten, auf denen sie verwendet werden. Ein fehlendes Bild in einer gemeinsamen Produktvorlage kann viele URLs betreffen; Alt-Texte müssen dagegen nach der Bedeutung des Bildes auf jeder Seite beurteilt werden.
Finden Sie Seiten mit erkanntem JSON-LD oder Microdata und Seiten ohne erkanntes Schema. Prüfen Sie damit die Abdeckung nach Inhaltstyp; erkanntes Markup bestätigt weder Gültigkeit noch Eignung für ein Rich Result.
ArticleJSON-LD@contextschema.org
@typeArticle
headlinelinen shirt
Prüfen Sie, welche gecrawlten Seiten gängige schützende Antwortheader zurückgeben. Filter für fehlende Header machen Konfigurationsunterschiede sichtbar; die richtige Richtlinie hängt weiterhin davon ab, wie die Website ihre Inhalte lädt.
Content-Security-PolicyX-Content-Type-OptionsStrict-Transport-SecurityBewahren Sie einen abgeschlossenen Crawl als Ausgangsbasis für das nächste Release oder die nächste Migration auf. Vergleichen Sie spätere Momentaufnahmen auf Änderungen betroffener URLs und erstellen Sie aus gefilterten Befunden eine konkrete Übergabe an Entwicklung oder Redaktion.
Verbinden Sie Ihren KI-Assistenten mit Screpys SEO-MCP-Server. Fragen Sie nach dem letzten abgeschlossenen Crawl, prüfen Sie betroffene Seiten und priorisieren Sie technische SEO-Aufgaben.
Ein nützliches Audit endet nicht bei einer Problemzahl. Halten Sie den Crawl vergleichbar, prüfen Sie repräsentative URLs, finden Sie die gemeinsame Ursache und definieren Sie, was der nächste Crawl zeigen soll.
Bestätigen Sie Start-URL, maximale URLs, Crawltiefe, JavaScript-Modus, Zugriffsregeln und Site-Version. Der abgeschlossene Crawl ist eine datierte Momentaufnahme, keine laufend wechselnde Ansicht der Live-Site.
Öffnen Sie eine betroffene URL und prüfen Sie Antwort, gerenderte Ausgabe, Zweck, Indexierbarkeit, Vorlage und Geschäftswert, bevor Sie einen Filter als Fehler bewerten.
Trennen Sie ein redaktionelles Einzelproblem von einem CMS-Inhaltstyp, einer gemeinsamen Komponente, Navigationsregel, Route oder Website-Konfiguration. Beheben Sie das Muster statt jede Zeile einzeln zu bearbeiten.
Prüfen Sie die öffentliche Änderung, führen Sie einen weiteren Crawl mit vergleichbaren Einstellungen aus und bestätigen Sie, dass sich betroffener Anteil und URL-Muster aus dem richtigen Grund geändert haben.
Technische Rückschritte beginnen oft mit normalen Releases, Inhaltsänderungen, Migrationen und gemeinsamen Vorlagen. Ein Crawl vor und nach der Änderung liefert Belege, solange der Umsetzungskontext noch frisch ist.
Erfassen Sie Weiterleitungen, Canonicals, interne Pfade, wichtige Vorlagen und Crawl-Abdeckung vor dem Launch und vergleichen Sie die neue Website anschließend mit derselben Ausgangsbasis.
Prüfen Sie, ob gemeinsame Layouts, Routing, Metadaten, Bilder, Skripte oder Sicherheitsänderungen wiederkehrende Probleme auf wertvollen Seiten eingeführt haben.
Halten Sie neue Artikel, Landingpages, Kategorien und programmatische Vorlagen verbunden, crawlbar, intern verlinkt und technisch konsistent.
Nutzen Sie Crawl-Nachweise zusammen mit Search Console, Release-Historie, Serverprotokollen und gerenderten Seiten, um Änderungen zu untersuchen, ohne ein einzelnes Auditsignal als Ursache des Traffic-Wechsels anzunehmen.
Nutzen Sie den kostenlosen Prüfer für eine Live-URL. Verwenden Sie Website Audit, wenn Sie eine Crawl-Momentaufnahme, Musteranalyse, Quellseitenkontext, Exporte und eine Überprüfung über die gesamte Website benötigen.
Crawlen Sie viele URLs als ein Projekt, untersuchen Sie Seiten-, Link- und Bilderinventare und prüfen Sie websiteweite Korrekturen in einer späteren Momentaufnahme.
Prüfen Sie gerenderte Metadaten, Überschriften, Links, Bilder, strukturierte Daten, Barrierefreiheit und technische Signale einer öffentlichen URL.
Screpy-Dokumentation
Folgen Sie dem Screpy-Leitfaden, um Auditergebnisse zu prüfen, betroffene URLs zu untersuchen, Probleme zu priorisieren und Korrekturen nach einem neuen Crawl zu bestätigen.
Verstehen Sie Crawl-Umfang, JavaScript-Rendering, fehlende Seiten, Problemzahlen, Priorisierung, Vergleiche, Berichte und was ein technisches Audit beweisen kann – und was nicht.
Screpy prüft Crawl-Zugriff, HTTP-Statuscodes, Weiterleitungen, Crawltiefe, Antwortzeit, Metadaten, Überschriften, Canonicals, Inhaltssignale, strukturierte Daten, Social-Tags, Sicherheitsheader, interne und externe Links, Bilder und verwandte technische Ergebnisse auf gecrawlten Seiten.
Führen Sie nach größeren Änderungen, Migrationen, Redesigns und Inhaltsaktualisierungen ein vollständiges Audit durch. Bei aktiven Websites sind wiederkehrende Audits hilfreich, da nach normalen Releases und Bearbeitungen neue technische Probleme entstehen können.
Ein neuerer Crawl entdeckt möglicherweise mehr Seiten, erreicht eine zuvor blockierte Vorlage oder verwendet andere Umfangseinstellungen. Vergleichen Sie die Anzahl gecrawlter Seiten, den betroffenen Anteil, URL-Muster, Crawl-Konfiguration und Site-Version, bevor Sie eine Verbesserung oder Verschlechterung der Website-Gesundheit annehmen.
Ja. Screpy unterstützt Berichte und Exporte, damit Auditergebnisse, abgeschlossene Arbeiten und offene Probleme leichter mit Teammitgliedern, Kunden, Entwicklern und Stakeholdern geteilt werden können.
Nein. Ein Website-Audit hilft, den technischen Zustand zu untersuchen und Änderungen zu bestätigen, garantiert aber keine Rankings oder mehr Traffic. Suchergebnisse hängen auch von Relevanz, Inhaltsqualität, Autorität, Wettbewerb, Nachfrage, Indexierung und der Interpretation jeder Seite durch Suchmaschinen ab.
Eine Einzelprüfung bewertet eine URL zu einem bestimmten Zeitpunkt. Ein Website-Audit crawlt Seiten als eine Website, findet wiederkehrende Muster, vergleicht URLs und bietet einen websiteweiten Ablauf zum Priorisieren und Überwachen von Korrekturen.
Prüfen Sie zuerst, ob die URL brauchbares HTML zurückgibt, ScrepyBot zulässt, von einer gecrawlten Seite verlinkt ist, innerhalb der gewählten Tiefe und URL-Kapazität liegt und keine Weiterleitungsschleifen, Authentifizierung, Bot-Herausforderungen, Timeouts oder Serverfehler aufweist.
Beginnen Sie mit Problemen, die Crawling, Indexierung, Verfügbarkeit oder viele wichtige Seiten betreffen. Berücksichtigen Sie danach Seitenwert, betroffene Vorlagen, Suchtraffic, Conversion-Auswirkung und den Aufwand zur Behebung der Ursache.
Ja. Behandeln Sie abgeschlossene Crawls als datierte Momentaufnahmen und vergleichen Sie sie mit gleichwertigem Umfang und Einstellungen. Prüfen Sie behobene, verbleibende und neue Ergebnisse sowie, ob dieselben Seitentypen und wichtigen URLs enthalten sind.
Screpy bietet eine JavaScript-Crawl-Einstellung für Websites, deren wichtige Links oder Inhalte im Browser entstehen. JavaScript-Rendering umgeht keine Robots-Regeln, Authentifizierung, Bot-Schutz, Serverfehler oder den Crawl-Umfang des Projekts.
Ja. Ein websiteweiter Crawl zeigt leichter, wenn dasselbe Problem in Vorlagen, Kategorien oder URL-Gruppen auftritt. So können Teams das zugrunde liegende Muster beheben, statt jede Seite isoliert zu prüfen.
Verstehen Sie Super-Intelligence-Begriffe und verbinden Sie Website-Audits, Suchrecherche, Rankings und KI-Sichtbarkeit in einem praktischen Screpy-Ablauf.
Ein umfassendes SEO-Toolkit zu einem angenehm günstigen Preis.