


Voor en na een migratie
Leg redirects, canonicals, interne paden, belangrijke templates en crawlbereik vast voor de lancering en vergelijk daarna met dezelfde basis.
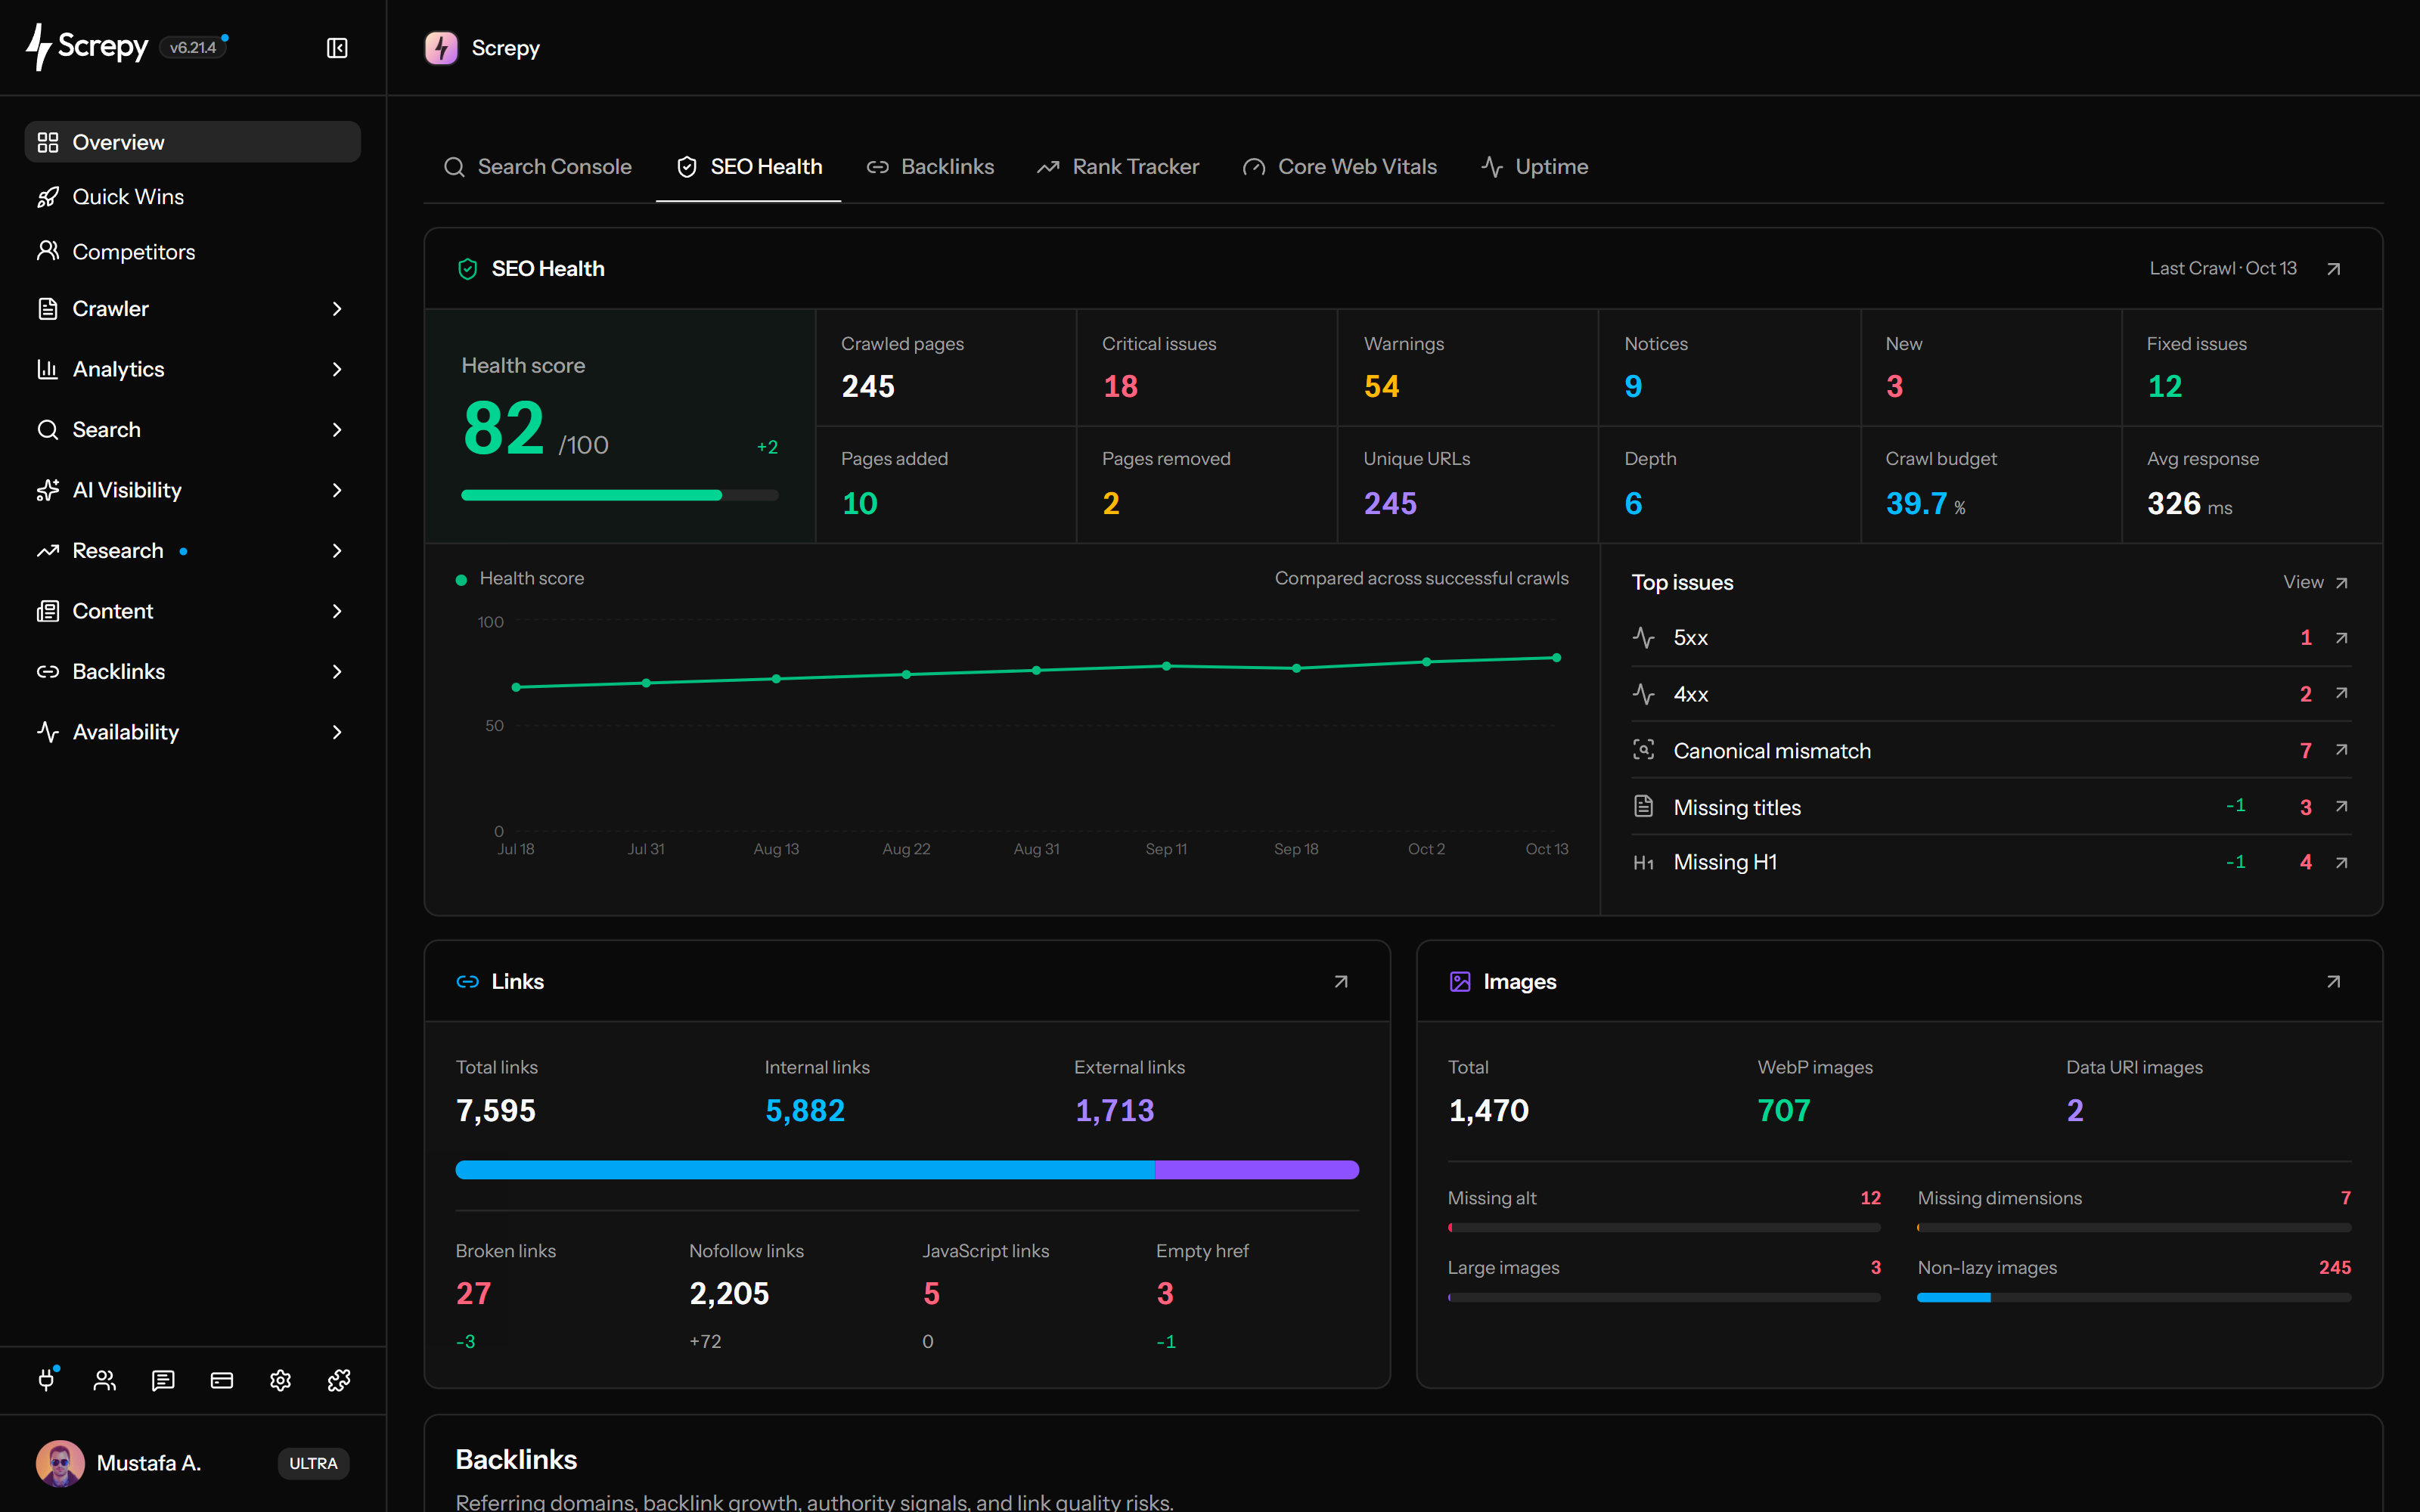
Zet een volledige crawl om in een pagina-inventaris, gegroepeerde bevindingen en een praktische fixqueue. Bekijk statuscodes, redirects, canonicals, metadata, headings, links, afbeeldingen, responstijd en structured data en crawl daarna opnieuw om wijzigingen te controleren.


Begin met de URL’s die zoekmachines en bezoekers moeten bereiken. De pagina-inventaris toont antwoorden, redirectdoelen en crawldiepte bij elke URL, zodat je een kapotte productroute of een onbereikbaar artikel gericht kunt onderzoeken.
/guides/seo200
Herhaalde metadata kan uit één gedeeld sjabloon komen in plaats van honderden losse schrijffouten. Filter titels en beschrijvingen, vergelijk getroffen URL’s en bepaal of je het sjabloon of de pagina-inhoud moet aanpassen.
example.com › guides
SEO · TitelBeschrijvingBekijk hoe elke gecrawlde pagina haar hoofdonderwerp presenteert. Kop- en woordaantallen en de inhoudsverhouding helpen een onvolledig artikel te onderscheiden van een beknopte contactpagina; verschillende paginadoelen vragen niet om dezelfde inhoudsnorm.
InhoudH1
Vergelijk het canonical-doel van een pagina met de uiteindelijke URL van de crawl. Dit is vooral nuttig na migraties of wanneer filters en parameters meerdere versies van dezelfde inhoud maken.
/shop?sort=new
/shop?filter=linen
/shop
Een falend doel laat zien wat kapot is; de bronpagina’s laten zien waar je het moet herstellen. De linkinventaris verbindt elk doel met de verwijzende pagina’s en ankerteksten, inclusief herhaalde navigatie- en footerlinks.
Bron/guides
/old-pricing404/setup503Bekijk afbeeldings-URL’s samen met de pagina’s die ze gebruiken. Een ontbrekende afbeelding in een gedeeld productsjabloon kan veel URL’s raken; alt-tekst beoordeel je op basis van wat de afbeelding op elke pagina communiceert.
Vind pagina’s met gedetecteerde JSON-LD of microdata en pagina’s zonder gedetecteerd schema. Gebruik deze inventaris om dekking per inhoudstype te bekijken; detectie bewijst geen geldigheid of geschiktheid voor een uitgebreid zoekresultaat.
ArticleJSON-LD@contextschema.org
@typeArticle
headlinelinen shirt
Bekijk welke gecrawlde pagina’s gangbare beschermende antwoordheaders teruggeven. Filters voor ontbrekende headers tonen configuratieverschillen; de juiste policy kiezen vereist nog steeds inzicht in hoe de website inhoud laadt.
Content-Security-PolicyX-Content-Type-OptionsStrict-Transport-SecurityBewaar een voltooide crawl als basis voor je volgende release of migratie. Vergelijk latere momentopnamen om te zien of getroffen URL’s veranderden en maak van gefilterde bevindingen een concrete overdracht aan ontwikkelaars of redacteuren.
Verbind je AI-assistent met de SEO MCP-server van Screpy. Vraag naar je laatste voltooide crawl, bekijk betrokken pagina’s en bepaal een duidelijke volgorde voor technische SEO-taken.
Een goede audit eindigt niet bij een probleemaantal. Houd de crawl vergelijkbaar, valideer representatieve URL's, vind de gedeelde oorzaak en bepaal wat de volgende crawl moet tonen.
Controleer start-URL, maximumaantal URL's, crawldiepte, JavaScript-modus, toegangsregels en siteversie. De voltooide crawl wordt een momentopname met datum, niet een voortdurend veranderende weergave van de live website.
Open één getroffen URL en controleer response, gerenderde output, doel, indexeerbaarheid, template en bedrijfswaarde voordat je een filter als defect behandelt.
Maak onderscheid tussen een afzonderlijk redactioneel probleem en een CMS-contenttype, gedeelde component, navigatieregel, route of sitebrede configuratiefout. Herstel het patroon in plaats van elke regel apart te bewerken.
Controleer de publieke wijziging, voer een vergelijkbare crawl uit en bevestig dat percentage en URL-patroon om de bedoelde reden veranderden.
Technische regressies beginnen vaak met gewone releases, contentwerk, migraties en gedeelde templates. Een crawl voor en na de wijziging geeft bewijs zolang de implementatiecontext vers is.
Leg redirects, canonicals, interne paden, belangrijke templates en crawlbereik vast voor de lancering en vergelijk daarna met dezelfde basis.
Controleer of gedeelde layouts, routing, metadata, afbeeldingen, scripts of beveiligingswijzigingen een herhaald probleem veroorzaakten.
Houd nieuwe artikelen, landingspagina’s, categorieën en programmatische templates verbonden, crawlbaar, intern gelinkt en technisch consistent.
Gebruik crawlbewijs naast Search Console, releasegeschiedenis, serverlogs en gerenderde pagina’s zonder aan te nemen dat één auditsignaal de verkeerswijziging veroorzaakte.
Gebruik de gratis checker voor één live URL. Gebruik Website Audit voor crawl-snapshots, patroonanalyse, broncontext, exports en sitebrede verificatie.
Crawl veel URL's als één project, onderzoek Pages, Links en Images en verifieer sitebrede fixes in een volgende snapshot.
Bekijk metadata, headings, links, afbeeldingen, structured data, toegankelijkheid en technische signalen van één publieke URL.
Screpy-documentatie
Volg de Screpy-gids om resultaten te bekijken, getroffen URL's te onderzoeken, problemen te prioriteren en fixes na een nieuwe crawl te controleren.
Begrijp crawlbereik, JavaScript-rendering, ontbrekende pagina's, probleemaantallen, prioritering, vergelijking en wat een technische audit wel en niet kan bewijzen.
Begin met problemen die crawling, indexering, beschikbaarheid of veel belangrijke pagina's raken. Weeg daarna paginawaarde, zoekverkeer, conversie-impact en benodigde inspanning.
Ja, Screpy heeft een JavaScript-crawlmodus voor sites waarvan belangrijke links of content in de browser ontstaan. Robotsregels, authenticatie, botbescherming en crawlbereik blijven gelden.
Voer een volledige audit uit na grote wijzigingen, migraties, redesigns en contentupdates. Voor actieve websites zijn terugkerende audits nuttig.
Een nieuwe crawl kan meer pagina's ontdekken, een eerder geblokkeerd template bereiken of andere instellingen gebruiken. Vergelijk paginatotalen, percentages, patronen en siteversie.
Nee. Een website-audit helpt de technische staat te onderzoeken en wijzigingen te verifiëren, maar garandeert geen posities of verkeer. Zoekresultaten hangen ook af van relevantie, contentkwaliteit, autoriteit, concurrentie, vraag, indexering en hoe zoekmachines elke pagina interpreteren.
Ja. Screpy ondersteunt rapporten en exports, zodat je auditbevindingen, afgerond werk en resterende problemen duidelijker kunt delen met teamleden, klanten, ontwikkelaars en andere betrokkenen.
Controleer eerst of de URL bruikbare HTML teruggeeft, ScrepyBot toestaat, vanaf een gecrawlde pagina is gelinkt, binnen de gekozen diepte en URL-capaciteit valt en geen redirectlussen, authenticatie, botcontroles, time-outs of serverfouten heeft.
Screpy controleert crawltoegang, HTTP-statuscodes, redirects, crawldiepte, responstijd, metadata, headings, canonicals, content, structured data, social tags, security headers, links en afbeeldingen.
Ja. Behandel voltooide crawls als momentopnamen met datum en vergelijk ze bij gelijkwaardige reikwijdte en instellingen. Bekijk welke bevindingen zijn verholpen, welke blijven, welke nieuw zijn en of dezelfde paginatypen en belangrijke URL's in beide crawls zijn opgenomen.
Ja. Een sitebrede crawl maakt zichtbaar wanneer hetzelfde probleem in templates, categorieën of URL-groepen verschijnt. Zo kan het team het patroon herstellen.
Een single-page check beoordeelt één URL op één moment. Een website-audit crawlt pagina's als één site, vindt patronen en biedt een sitebrede workflow voor fixes.
Begrijp Super Intelligence en verbind audits, zoekonderzoek, posities en AI-zichtbaarheid in een praktische Screpy-werkwijze.
Een uitgebreide SEO-toolkit voor een verrassend betaalbare prijs.