


Avant et après une migration
Enregistrez redirections, canonicals, chemins internes, modèles importants et couverture du crawl avant le lancement, puis comparez le nouveau site à la même référence.
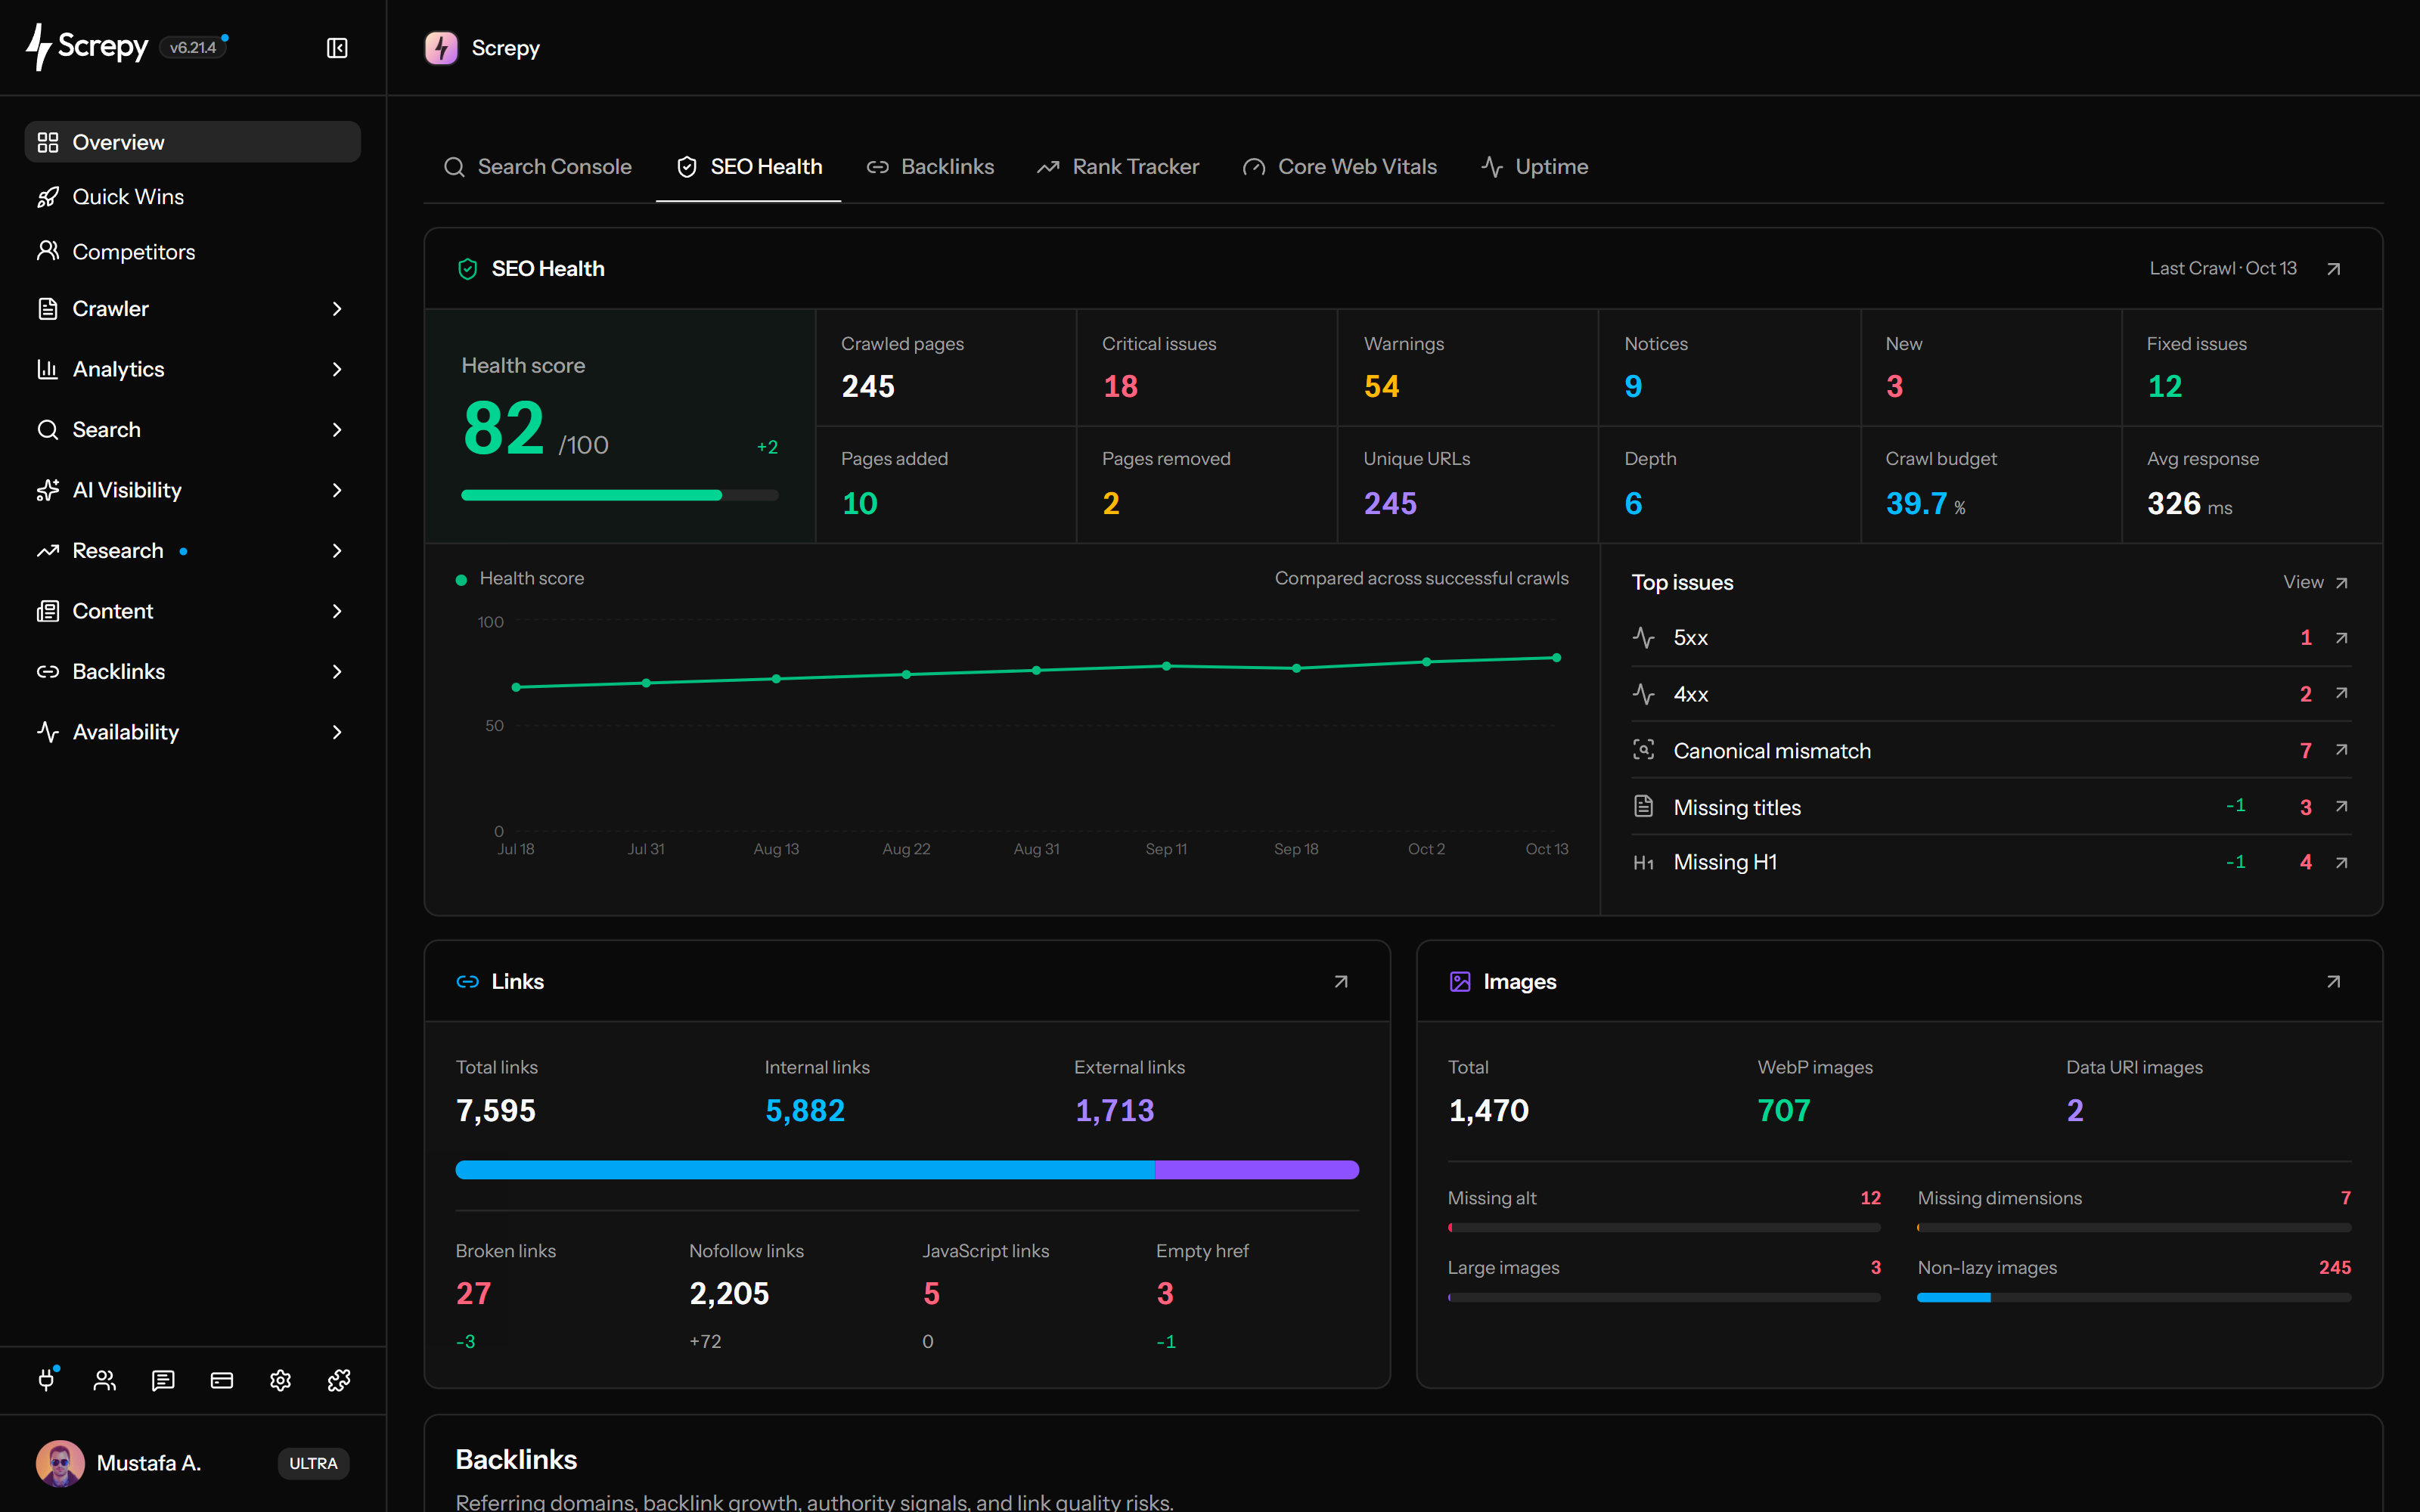
Transformez un crawl complet en inventaire de pages, résultats regroupés et file d’actions concrètes. Analysez l’explorabilité, les codes d’état, les redirections, les canonicals, les métadonnées, les titres, les liens, les images, le temps de réponse, les données structurées et les signaux de sécurité, puis relancez le crawl pour vérifier les changements.


Commencez par les URL que les moteurs et les visiteurs doivent pouvoir atteindre. L’inventaire des pages affiche les réponses, destinations des redirections et profondeurs de crawl pour chaque URL, afin d’examiner une adresse de produit cassée ou un article inaccessible.
/guides/seo200
Des métadonnées répétées peuvent venir d’un modèle partagé plutôt que de centaines d’erreurs de rédaction distinctes. Filtrez les titres et descriptions, comparez les URL concernées et décidez si la correction appartient au modèle ou au contenu de la page.
example.com › guides
SEO · TitreDescriptionObservez comment chaque page explorée présente son sujet principal. Les nombres de titres et de mots et la proportion de contenu distinguent un article incomplet d’une page de contact concise ; des objectifs différents n’imposent pas une cible de contenu uniforme.
ContenuH1
Comparez la cible canonique d’une page à l’URL finale atteinte par le crawl. C’est particulièrement utile après une migration ou lorsque des filtres et paramètres créent plusieurs versions d’un même contenu.
/shop?sort=new
/shop?filter=linen
/shop
Une destination en échec indique ce qui ne fonctionne plus ; les pages sources indiquent où intervenir. L’inventaire des liens relie chaque destination aux pages et ancres qui la citent, y compris les liens répétés de navigation et de pied de page.
Source/guides
/old-pricing404/setup503Examinez les URL d’images avec les pages qui les utilisent. Une image absente dans un modèle de produit partagé peut toucher de nombreuses URL ; le texte alternatif dépend de ce que l’image communique sur chaque page.
Trouvez les pages avec du JSON-LD ou des microdonnées détectés et celles sans schéma détecté. Examinez la couverture par type de contenu ; la détection d’un balisage n’établit ni sa validité ni son éligibilité à un résultat enrichi.
ArticleJSON-LD@contextschema.org
@typeArticle
headlinelinen shirt
Vérifiez quelles pages explorées renvoient des en-têtes de réponse protecteurs courants. Les filtres d’en-têtes absents révèlent des différences de configuration ; choisir la bonne politique exige toujours de comprendre comment le site charge ses contenus.
Content-Security-PolicyX-Content-Type-OptionsStrict-Transport-SecurityConservez un crawl terminé comme référence pour votre prochaine mise en ligne ou migration. Comparez les instantanés suivants pour voir si les URL concernées ont changé, puis transmettez des constats filtrés concrets aux développeurs ou rédacteurs.
Connectez votre assistant IA au serveur SEO MCP de Screpy. Interrogez le dernier crawl terminé, examinez les pages concernées et priorisez les constats de SEO technique.
Un audit utile ne s’arrête pas à un nombre de problèmes. Gardez le crawl comparable, validez des URL représentatives, trouvez la cause commune et définissez ce que le prochain crawl doit montrer.
Confirmez l’URL de départ, le nombre maximal d’URL, la profondeur, le mode JavaScript, les règles d’accès et la version du site. Le crawl terminé est un instantané daté, pas une vue qui évolue en permanence.
Ouvrez une URL concernée et vérifiez sa réponse, son rendu, son objectif, son indexation, son modèle et sa valeur métier avant de considérer un filtre comme un défaut.
Séparez un problème éditorial isolé d’un type de contenu CMS, d’un composant partagé, d’une règle de navigation, d’une route ou d’une configuration globale. Corrigez le motif plutôt que chaque ligne séparément.
Inspectez la modification publique, lancez un autre crawl avec des réglages comparables et confirmez que le pourcentage concerné et le motif d’URL ont changé pour la bonne raison.
Les régressions techniques commencent souvent avec des releases, des contenus, des migrations et des modifications de modèles partagés. Un crawl avant et après fournit des preuves tant que le contexte d’implémentation est encore clair.
Enregistrez redirections, canonicals, chemins internes, modèles importants et couverture du crawl avant le lancement, puis comparez le nouveau site à la même référence.
Vérifiez si des changements de layouts, de routage, de métadonnées, d’images, de scripts ou de sécurité ont introduit un problème répété sur des pages importantes.
Gardez les articles, landing pages, catégories et modèles programmatiques connectés, crawlables, liés en interne et techniquement cohérents.
Utilisez les preuves du crawl avec Search Console, l’historique des releases, les journaux serveur et les pages rendues pour comprendre ce qui a changé sans attribuer le mouvement du trafic à un seul signal.
Utilisez le vérificateur gratuit pour une URL en ligne. Utilisez Website Audit pour une capture de crawl, une analyse de motifs répétés, le contexte des pages sources, des exports et une vérification à l’échelle du site.
Crawlez de nombreuses URL dans un projet, examinez les inventaires de pages, liens et images et vérifiez les corrections globales lors d’un instantané ultérieur.
Examinez métadonnées rendues, titres, liens, images, données structurées, accessibilité et signaux techniques d’une URL publique.
Documentation Screpy
Suivez le guide Screpy pour consulter les résultats, examiner les URL concernées, prioriser les problèmes et vérifier les corrections après un nouveau crawl.
Comprenez le périmètre du crawl, le rendu JavaScript, les pages manquantes, le nombre de problèmes, la priorisation, les comparaisons, les rapports et ce qu’un audit technique peut ou ne peut pas prouver.
Screpy examine l’accès au crawl, les codes HTTP, les redirections, la profondeur, le temps de réponse, les métadonnées, les titres, les canonicals, les signaux de contenu, les données structurées, les balises sociales, les en-têtes de sécurité, les liens internes et externes, les images et les résultats techniques associés.
Lancez un audit complet après les changements importants, migrations, refontes et mises à jour de contenu. Pour un site actif, les audits récurrents sont utiles car de nouveaux problèmes techniques peuvent apparaître après des releases et modifications ordinaires.
Vérifiez d’abord que l’URL renvoie un HTML exploitable, autorise ScrepyBot, est liée depuis une page crawlée, respecte la profondeur et la capacité choisies et n’est pas concernée par une boucle de redirection, une authentification, un défi anti-bot, un délai d’attente ou une erreur serveur.
Oui. Screpy prend en charge les rapports et les exports afin de communiquer plus facilement les résultats, le travail terminé et les problèmes restants aux collègues, clients, développeurs et parties prenantes.
Oui. Un crawl de tout le site permet de voir si le même problème apparaît dans des modèles, catégories ou groupes d’URL. Les équipes peuvent corriger le motif sous-jacent au lieu d’examiner chaque page isolément.
Une vérification de page examine une URL à un instant donné. Un audit de site crawl les pages comme un ensemble, détecte les motifs répétés, compare les URL et fournit un flux global pour prioriser et suivre les corrections.
Commencez par les problèmes qui touchent le crawl, l’indexation, la disponibilité ou de nombreuses pages importantes. Tenez ensuite compte de la valeur de la page, des modèles touchés, du trafic de recherche, de l’impact conversion et de l’effort nécessaire pour corriger la cause.
Oui. Traitez les crawls terminés comme des instantanés datés et comparez-les avec un périmètre et des réglages équivalents. Vérifiez les résultats corrigés, persistants et nouveaux ainsi que la présence des mêmes types de pages et URL importantes.
Screpy propose un réglage de crawl JavaScript pour les sites dont les liens ou contenus importants sont créés dans le navigateur. Le rendu JavaScript ne contourne ni les règles robots, ni l’authentification, ni la protection anti-bot, ni les erreurs serveur, ni le périmètre du projet.
Non. Un audit aide à examiner l’état technique et à vérifier les changements, mais ne garantit ni classement ni trafic. Les résultats dépendent aussi de la pertinence, de la qualité du contenu, de l’autorité, de la concurrence, de la demande, de l’indexation et de l’interprétation de chaque page par les moteurs.
Un nouveau crawl peut découvrir davantage de pages, atteindre un modèle auparavant bloqué ou utiliser un autre périmètre. Comparez le total de pages crawlées, le pourcentage concerné, les motifs d’URL, la configuration et la version du site avant de conclure à une amélioration ou une baisse de santé.
Comprenez Super Intelligence et reliez audits, recherche, positions et visibilité IA dans un processus Screpy concret.
Une boîte à outils SEO complète à un prix vraiment abordable.