


Migrations de site et changements d’URL
Enregistrez les URL importantes, redirections, destinations finales, canonical et chemins internes avant la mise en production, puis explorez la nouvelle structure avec le même périmètre.
Lancez une exploration dans le cloud et cartographiez le site à partir de ses liens internes au lieu de vérifier les URL une par une. Configurez la capacité, la profondeur, le rendu JavaScript, la concurrence et le délai des requêtes, puis examinez les enregistrements Pages, Liens et Images derrière chaque tendance technique.
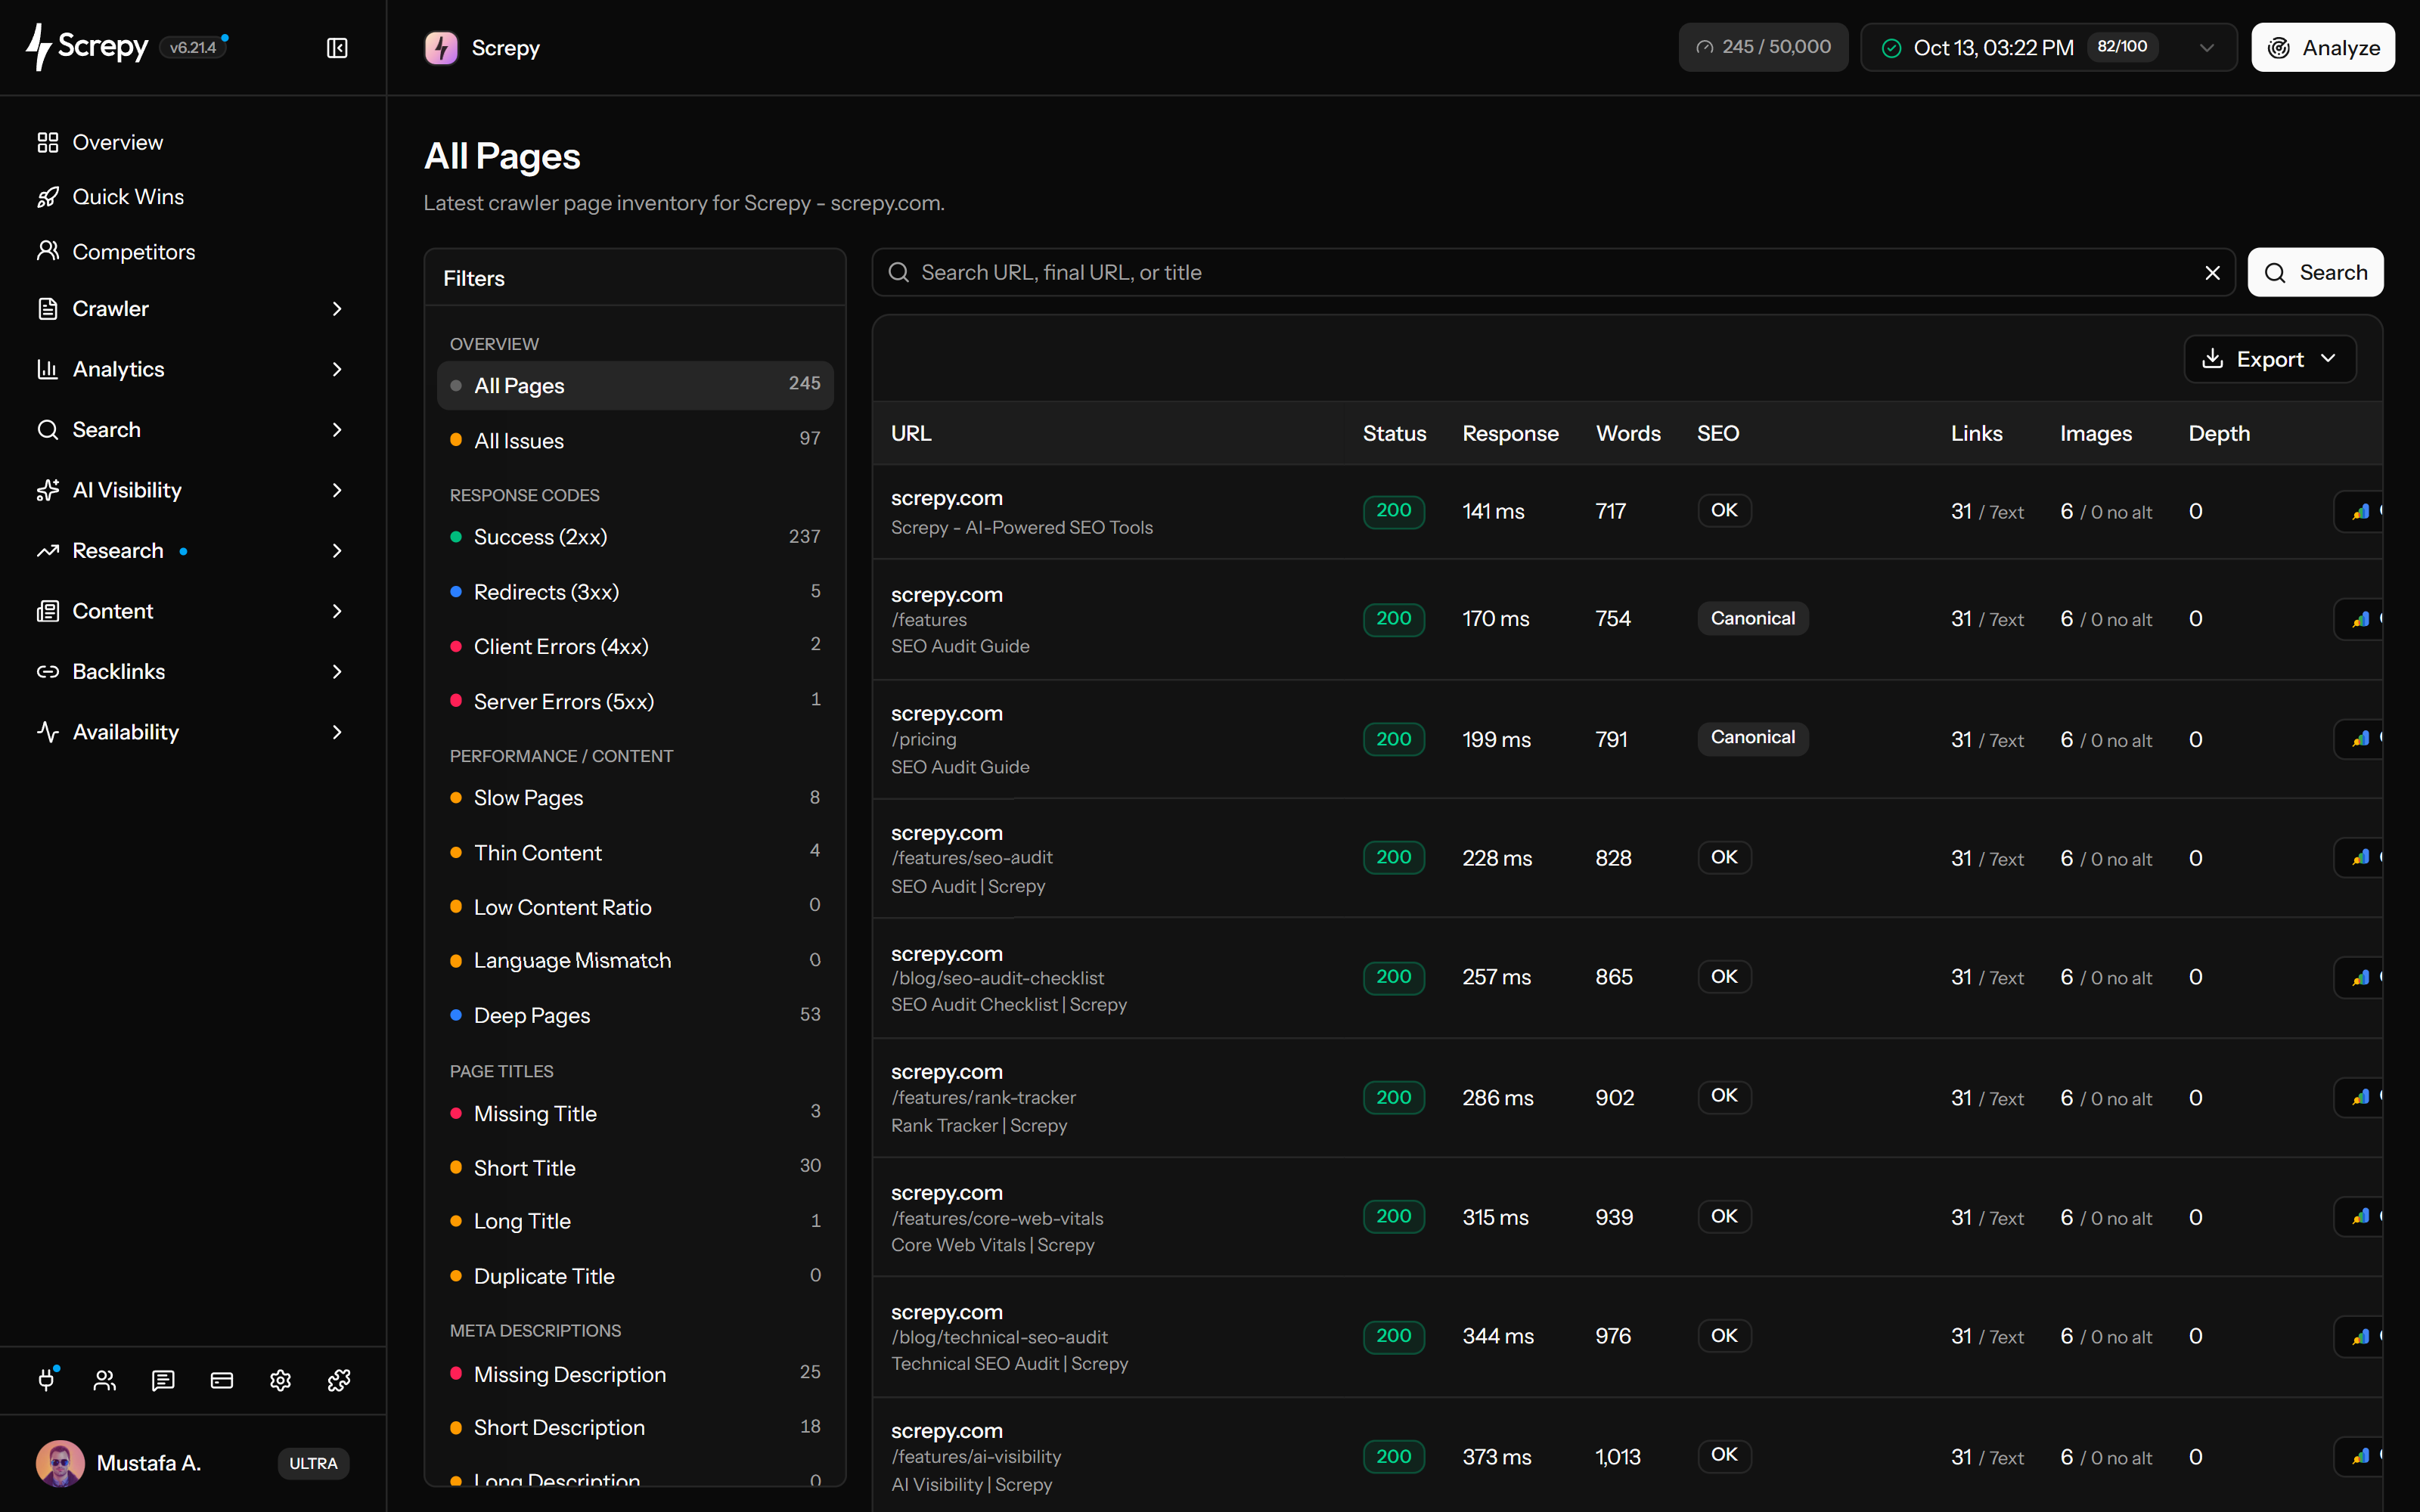


Screpy part du site de votre projet et suit les liens internes accessibles dans le cloud. La première exploration démarre pendant la configuration ; ensuite, utilisez Analyser dans Pages, Liens ou Images pour créer un nouvel inventaire.
La navigation côté client peut cacher des liens importants à l’exploration du HTML initial. Activez JavaScript lorsque des scripts génèrent un contenu significatif ou la navigation ; laissez-le désactivé si le serveur fournit déjà le HTML nécessaire.
<main id="app">
  <script />
</main>Le périmètre de découverte et le rythme des requêtes résolvent des problèmes différents. La profondeur fixe les niveaux de liens internes suivis ; la concurrence et le délai règlent la pression sur le serveur. Une profondeur accrue ne découvre pas une page sans lien.
example.com3
//shop//shop/linen/Comprenez comment une catégorie, un produit ou un article est relié au site grâce aux URL et liens enregistrés. Les relations avec les pages sources permettent d’examiner les contenus profonds, la navigation obsolète et les chemins passant par des redirections.
Créez un fichier de travail avec les enregistrements dont votre équipe a besoin. Filtrez l’exploration choisie avant l’export plutôt que de transmettre tout le site pour une tâche limitée à un modèle, un statut de réponse ou un motif de fichiers.
Une exploration terminée enregistre le site tel qu’il était accessible à cet instant. Après une modification de navigation ou une migration, relancez-la pour vérifier découverte et destinations ; les anciens enregistrements ne changent pas automatiquement avec le site en ligne.
Connectez votre assistant IA au serveur SEO MCP de Screpy. Interrogez le dernier crawl terminé, examinez les pages concernées et priorisez les constats de SEO technique.
Gardez le périmètre visible, examinez les enregistrements derrière un modèle, corrigez la cause réelle et utilisez l’exploration suivante pour vérifier le résultat.
Vérifiez l’URL de départ, la capacité, la profondeur, le mode JavaScript, la concurrence, le délai, les règles robots et l’accès du crawler. Ces réglages déterminent ce que l’instantané peut représenter.
Screpy suit les chemins internes accessibles et enregistre chaque URL découverte dans le périmètre, sa réponse, sa profondeur, sa destination, ses relations de liens et les données de page ou d’image associées.
Utilisez les rapports Pages, Liens et Images pour passer du total aux URL représentatives, aux pages sources, au comportement des redirections, aux métadonnées, aux canonical ou à l’utilisation des images avant de choisir une correction.
Lancez une nouvelle exploration après les changements du site. Gardez le périmètre et les réglages comparables, puis vérifiez que les URL ciblées et le modèle principal ont changé pour la bonne raison.
Les données d’exploration sont les plus utiles lorsque l’équipe sait encore ce qui a changé. Créez une référence avant un travail à risque et un instantané comparable après sa mise en production.
Enregistrez les URL importantes, redirections, destinations finales, canonical et chemins internes avant la mise en production, puis explorez la nouvelle structure avec le même périmètre.
Utilisez le rendu JavaScript lorsque la navigation ou le contenu important est créé dans le navigateur, puis vérifiez que ces URL apparaissent dans l’inventaire.
Examinez la profondeur, les pages sources, les liens, les attributs et les chemins répétés pour trouver le contenu important mal relié ou difficile à découvrir.
Explorez à nouveau après des changements de routage, de navigation, de CMS, de modèles ou de composants afin de repérer les régressions techniques répétées pendant que le contexte est encore récent.
Comparez Screpy et Screaming Frog lorsque le mode de déploiement, les contrôles d’exploration, l’extraction personnalisée, le suivi régulier, l’accès d’équipe et les rapports influencent la décision.
Utilisez l’explorateur SEO pour cartographier les chemins de découverte et examiner les enregistrements de pages, liens et images. Utilisez l’audit de site lorsque l’équipe a besoin de constats regroupés, de priorités et d’un flux de santé technique plus large.
Configurez l’exploration cloud, cartographiez les URL accessibles et examinez les enregistrements bruts Pages, Liens et Images derrière les modèles techniques.
Transformez l’exploration terminée en constats regroupés, modèles d’URL concernés, priorités, exports et flux reproductible de correction-vérification.
Les modèles partagés et les ensembles d’URL changeants créent des risques différents pour les sites SaaS d’acquisition et les catalogues e-commerce.
Examinez les pages d’acquisition, la documentation, les modèles partagés et les régressions de version comme une seule surface d’acquisition.
Auditez les types de pages de catégories et de produits, les parcours d’achat cassés et les changements structurels du catalogue.
Documentation Screpy
Utilisez les guides Screpy pour configurer le périmètre, autoriser l’accès du crawler, interpréter les rapports Pages, Liens et Images et diagnostiquer les résultats manquants.
Comprenez la découverte, le périmètre, le rendu JavaScript, l’accès, le rythme des requêtes, les rapports, les instantanés et la différence entre les données d’exploration et l’audit de site.
Un explorateur SEO commence par une URL de site, suit les liens internes accessibles dans un périmètre défini et enregistre des informations techniques sur les pages et ressources atteintes. L’inventaire obtenu aide les équipes à examiner les chemins de découverte, les codes de réponse, les redirections, les canonical, les liens internes, les métadonnées, les images et les modèles répétés du site.
Screpy commence par le site du projet et suit les liens internes accessibles dans la capacité d’URL et la profondeur configurées. Une page peut manquer si elle n’est pas liée, se trouve au-delà de la profondeur choisie, est bloquée, redirige hors de l’hôte du projet, nécessite le rendu JavaScript ou renvoie un contenu inutilisable.
Pages enregistre les URL explorées ainsi que la réponse, la profondeur, les métadonnées, les titres, la canonical, l’indexabilité, le contenu, les données structurées, les signaux sociaux et associés. Liens relie les destinations à leur état, texte, attributs, utilisation et pages sources. Images regroupe les ressources par réponse, texte alt, dimensions, présentation et utilisation dans les pages.
La capacité maximale limite le nombre d’URL découvertes que l’exploration peut conserver. La profondeur indique combien de niveaux de liens internes Screpy suit depuis la page de départ. Augmenter ces réglages ne corrige pas un accès bloqué, des liens internes manquants, des redirections, des limites de débit ou des réponses inutilisables.
L’explorateur SEO crée l’inventaire technique : URL découvertes, réponses, chemins, données de pages, liens, images et contexte d’exploration. L’audit de site interprète cette exploration sous forme de constats regroupés, modèles concernés, priorités et flux de correction-vérification. Utilisez l’explorateur pour la découverte et les enregistrements bruts, l’audit pour une vue de santé plus large et des actions prioritaires.
Non. Les données d’exploration aident à découvrir et vérifier les conditions techniques, mais les positions dépendent aussi de la pertinence, de la qualité du contenu, de l’autorité, de la concurrence, de la demande, de l’indexation et de l’interprétation de chaque page par les moteurs. Considérez les filtres comme des preuves à étudier, pas comme des instructions automatiques de classement.
Screpy propose un réglage JavaScript facultatif pour les sites dont les liens ou le contenu important sont créés dans le navigateur. Le rendu peut améliorer la découverte, mais il ne contourne ni les règles robots, ni l’authentification, ni les pare-feu, ni les vérifications anti-bot, ni les délais d’attente, ni le périmètre configuré.
Le crawler doit pouvoir obtenir la page réelle sans connexion, CAPTCHA, vérification du navigateur, blocage du pare-feu ou rejet de limite de débit. Autorisez ScrepyBot et l’IP du crawler documentée à chaque couche de sécurité, vérifiez l’accès à robots.txt et assurez-vous que la réponse réussie contient le véritable HTML de la page.
Oui. La concurrence contrôle le nombre de requêtes simultanées. Le délai est disponible lorsque la concurrence vaut 1 ; avec une concurrence supérieure, le délai enregistré est nul. Réduisez la pression des requêtes si votre serveur limite le trafic automatisé, puis vérifiez que l’exploration suivante reçoit les réponses des pages réelles.
Oui. Chaque exploration terminée est un instantané daté. Lancez-en une nouvelle après une version ou une correction et gardez le périmètre et les réglages équivalents afin de ne pas confondre les changements de couverture ou de totaux avec une configuration différente.
Les deux outils répondent à des questions différentes. Search Console rapporte les performances dans Google et certains signaux d’indexation. L’explorateur SEO suit de façon proactive les liens internes et crée un inventaire technique à examiner avant qu’un problème ou une variation de trafic soit signalé.
Oui. Le rapport Liens aide à identifier les destinations en échec ou redirigées et à suivre chacune jusqu’aux pages explorées qui la citent. Les développeurs et éditeurs voient ainsi la page source, le composant partagé ou le modèle précis à corriger, pas seulement l’URL cible.
Comprenez Super Intelligence et reliez audits, recherche, positions et visibilité IA dans un processus Screpy concret.