


Migrazioni del sito e modifiche URL
Registra URL importanti, redirect, destinazioni finali, canonical e percorsi interni prima del lancio, poi scansiona la nuova struttura nello stesso ambito.
Esegui un crawl cloud e mappa il sito dai suoi link interni invece di controllare gli URL uno alla volta. Configura capacità, profondità, rendering JavaScript, concorrenza e ritardo delle richieste; poi esamina i record esatti di Pages, Links e Images dietro ogni pattern tecnico.
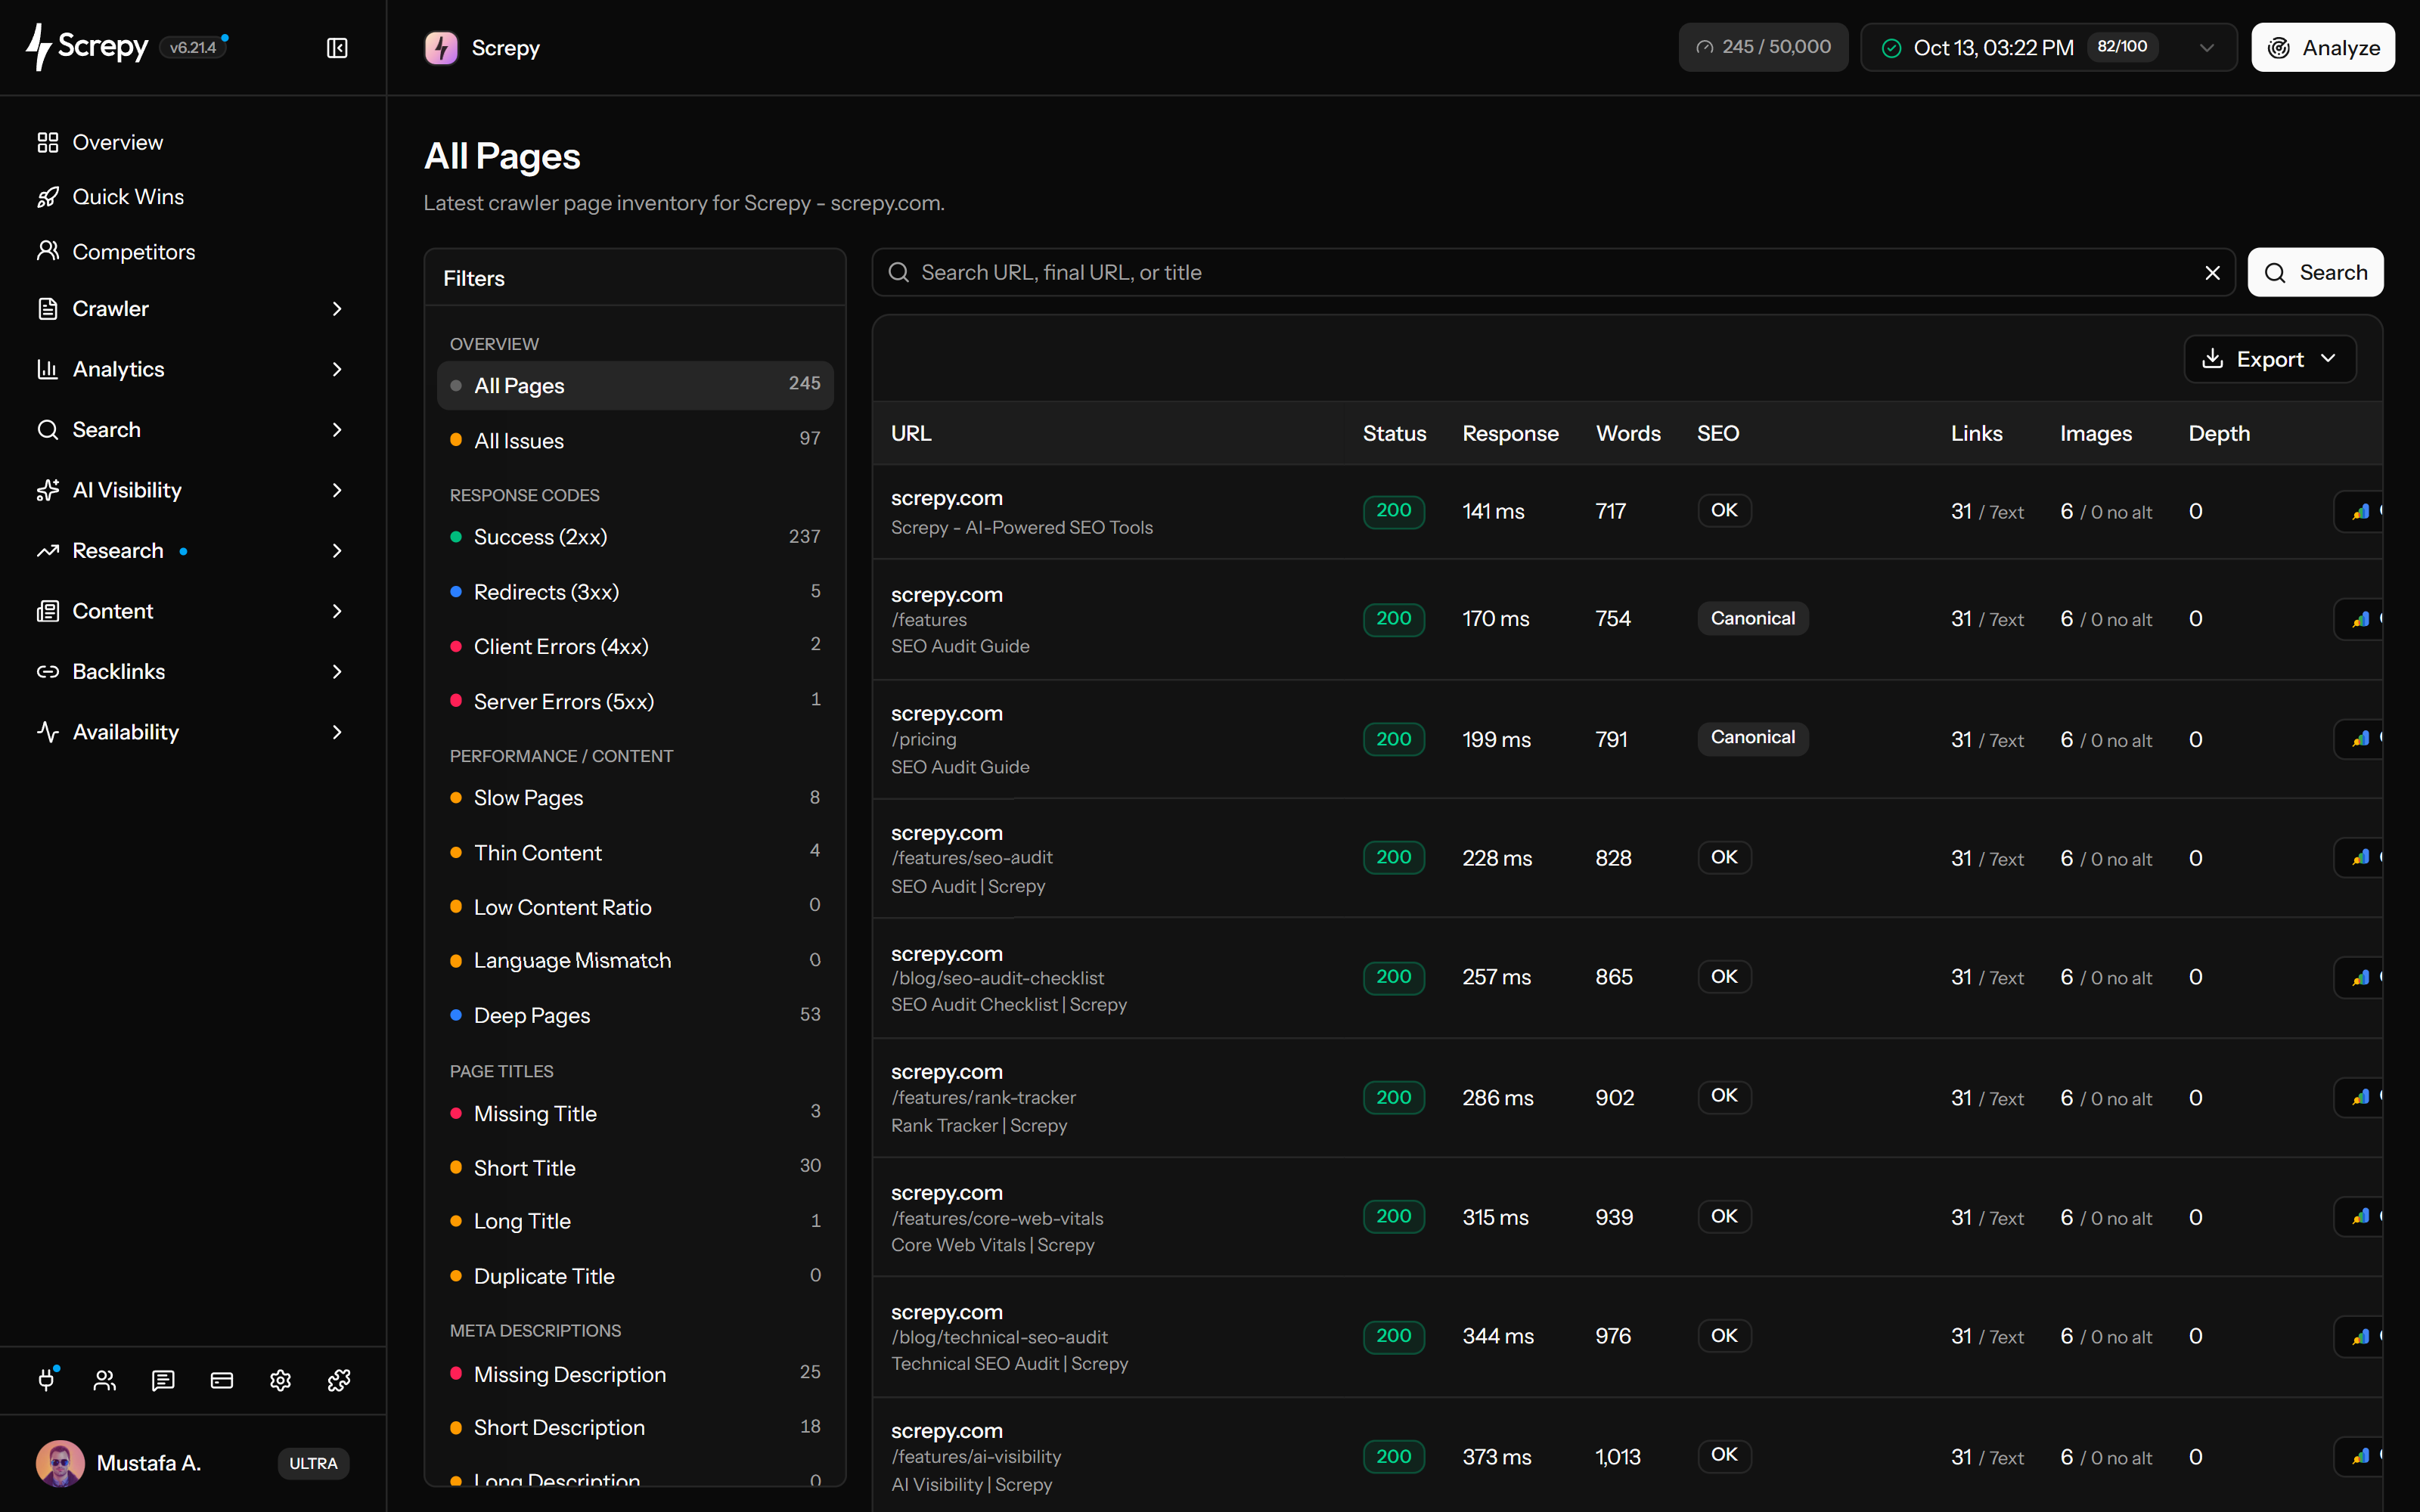


Screpy parte dal sito del progetto e segue i link interni accessibili nel cloud. La prima scansione inizia durante la configurazione; in seguito usa Analizza nei report Pagine, Link o Immagini per creare un nuovo inventario.
La navigazione lato client può nascondere link importanti alla scansione dell’HTML iniziale. Attiva JavaScript quando gli script generano contenuti significativi o navigazione; lascialo disattivato se il server restituisce già l’HTML necessario.
<main id="app">
  <script />
</main>Ambito di scoperta e ritmo delle richieste risolvono problemi diversi. La profondità determina i livelli di link interni seguiti; concorrenza e ritardo regolano la pressione sul server. Una maggiore profondità non rende scopribile una pagina senza link.
example.com3
//shop//shop/linen/Comprendi come una categoria, prodotto o articolo si collega al sito tramite URL e link registrati. Usa le relazioni con le pagine di origine per esaminare contenuti profondi, navigazione obsoleta e percorsi che passano da reindirizzamenti.
Crea un file di lavoro con i record necessari al team. Filtra la scansione selezionata prima di esportare, invece di consegnare tutto il sito quando l’intervento riguarda un modello, stato di risposta o schema di file.
Una scansione completata registra il sito come raggiunto in quel momento. Dopo modifiche alla navigazione o una migrazione, ripetila per controllare scoperta e destinazioni; i vecchi record non si aggiornano automaticamente con il sito live.
Collega il tuo assistente IA al server SEO MCP di Screpy. Chiedi dell’ultima scansione completata, esamina le pagine interessate e ordina le attività di SEO tecnico.
Mantieni visibile l'ambito, esamina i record dietro un pattern, correggi l'implementazione sottostante e usa il crawl successivo per confermare il risultato.
Conferma URL iniziale, capacità, profondità, modalità JavaScript, concorrenza, ritardo, regole robots e accesso del crawler. Queste impostazioni determinano cosa può rappresentare lo snapshot.
Screpy segue i percorsi interni accessibili e registra ogni URL, risposta, profondità, destinazione, relazione del link e dati di pagina o immagine nel limite configurato.
Usa i report Pages, Links e Images per passare dal totale agli URL rappresentativi, alle pagine sorgente, ai redirect, ai metadati, ai canonical o all'utilizzo delle immagini prima di scegliere una correzione.
Esegui un altro crawl dopo le modifiche. Mantieni ambito e impostazioni confrontabili, poi verifica che gli URL e il pattern sottostante siano cambiati per la ragione corretta.
I dati del crawl sono più utili quando il team sa ancora cosa è cambiato. Crea una baseline prima dei lavori rischiosi e uno snapshot confrontabile dopo il rilascio.
Registra URL importanti, redirect, destinazioni finali, canonical e percorsi interni prima del lancio, poi scansiona la nuova struttura nello stesso ambito.
Usa il rendering JavaScript quando navigazione o contenuti importanti vengono creati nel browser, poi verifica che gli URL compaiano nell'inventario.
Esamina profondità, pagine sorgente, anchor, attributi e percorsi ripetuti per trovare contenuti importanti poco collegati o difficili da scoprire.
Ripeti il crawl dopo modifiche a routing, navigazione, CMS, template e componenti per intercettare regressioni tecniche ripetute mentre il contesto è ancora chiaro.
Confronta Screpy con Screaming Frog quando modello di deploy, controlli del crawl, estrazione personalizzata, monitoraggio ricorrente, accesso del team e report influenzano la decisione.
Usa SEO Crawler per mappare i percorsi di scoperta e controllare i record di pagine, link e immagini. Usa Website Audit quando servono risultati raggruppati, priorità e un flusso tecnico più ampio.
Configura un crawl cloud, mappa gli URL raggiungibili e controlla i record Pages, Links e Images dietro i pattern tecnici.
Trasforma un crawl completato in risultati raggruppati, pattern URL interessati, priorità, esportazioni e un flusso ripetibile di correzione e verifica.
Template condivisi e insiemi di URL variabili creano rischi diversi per siti SaaS e cataloghi ecommerce.
Esamina landing page, documentazione, template condivisi e regressioni di rilascio come un'unica superficie di acquisizione.
Controlla tipi di pagine categoria e prodotto, percorsi di acquisto non funzionanti e modifiche strutturali al catalogo.
Documentazione di Screpy
Usa le guide Screpy per configurare l'ambito, consentire l'accesso del crawler, interpretare i report Pages, Links e Images e diagnosticare risultati incompleti.
Comprendi scoperta, ambito, rendering JavaScript, accesso, ritmo delle richieste, report, snapshot e differenza tra dati del crawl e Website Audit.
Un SEO crawler parte da un URL del sito, segue i link interni accessibili entro un ambito definito e registra informazioni tecniche sulle pagine e risorse raggiunte. L'inventario aiuta i team a indagare percorsi di scoperta, codici di risposta, redirect, canonical, link interni, metadati, immagini e pattern ripetuti.
Screpy offre un'impostazione JavaScript opzionale per i siti in cui link o contenuti importanti vengono creati nel browser. Il rendering può migliorare la scoperta, ma non aggira regole robots, autenticazione, firewall, challenge bot, timeout o ambito configurato.
Sì. La concorrenza controlla quante richieste vengono eseguite insieme. Il ritardo è disponibile quando la concorrenza è 1; con valori superiori il ritardo salvato è zero. Riduci la pressione delle richieste se il server limita il traffico automatico e verifica che la scansione successiva riceva le risposte delle pagine reali.
Il crawler deve ricevere la pagina reale senza login, CAPTCHA, challenge del browser, blocco firewall o rifiuto per limite di frequenza. Consenti ScrepyBot e gli IP documentati del crawler in ogni livello di sicurezza, verifica l'accesso a robots.txt e che una risposta riuscita contenga l'HTML reale.
Il SEO crawler crea l'inventario tecnico: URL scoperti, risposte, percorsi, dati di pagina, link, immagini e contesto del crawl. Website Audit interpreta il crawl come risultati raggruppati, pattern interessati, priorità e flusso di verifica. Usa il crawler per scoperta e record grezzi; usa l'audit per una revisione più ampia e azioni prioritarie.
Sì. Il report Links identifica destinazioni fallite o reindirizzate e le ricondduce alle pagine scansionate che le citano. Così sviluppatori ed editor possono correggere una pagina sorgente, un componente condiviso o un template preciso.
Sì. Ogni crawl completato è uno snapshot datato. Esegui un nuovo crawl dopo un rilascio o una correzione e confronta snapshot con ambito e impostazioni equivalenti.
Screpy parte dal sito del progetto e segue i link interni accessibili entro capacità URL e profondità configurate. Una pagina può mancare se non è collegata, supera la profondità scelta, è bloccata, reindirizza fuori dall'host, dipende dal rendering JavaScript o restituisce contenuti inutilizzabili.
Pages registra URL, risposta, profondità, metadati, heading, canonical, indicizzabilità, contenuto, dati strutturati, social e segnali correlati. Links collega destinazioni a stato, anchor, attributi, utilizzo e pagine sorgente. Images raggruppa sorgenti con risposta, alt text, dimensioni, attributi di distribuzione e utilizzo.
Il numero massimo di URL limita quanti URL scoperti il crawl può memorizzare. La profondità limita quanti livelli di link interni Screpy segue dalla pagina iniziale. Aumentare uno dei due non risolve accesso bloccato, link mancanti, redirect, limiti di frequenza o risposte inutilizzabili.
Rispondono a domande diverse. Search Console mostra rendimento nella ricerca Google e alcune informazioni sull'indicizzazione. Un SEO crawler segue proattivamente i link interni e crea un inventario tecnico da controllare prima che Google segnali un problema o cambi il traffico.
No. I dati del crawl aiutano a scoprire e verificare condizioni tecniche, ma le posizioni dipendono anche da pertinenza, qualità dei contenuti, autorevolezza, concorrenza, domanda, indicizzazione e interpretazione dei motori di ricerca. Considera i filtri come prove da analizzare, non come istruzioni automatiche di ranking.
Comprendi Super Intelligence e collega audit, ricerca, posizionamenti e visibilità AI in un flusso Screpy pratico.