


Migrationen und URL-Änderungen
Wichtige URLs, Redirects, Ziele, Canonicals und interne Pfade vor dem Launch speichern und neue Struktur gleich crawlen.
Cloud-Crawl ausführen und Website über interne Links abbilden, statt URLs einzeln zu prüfen. Kapazität, Tiefe, JavaScript-Rendering, Parallelität und Anfrageverzögerung konfigurieren und anschließend Pages-, Links- und Images-Datensätze hinter jedem Muster prüfen.
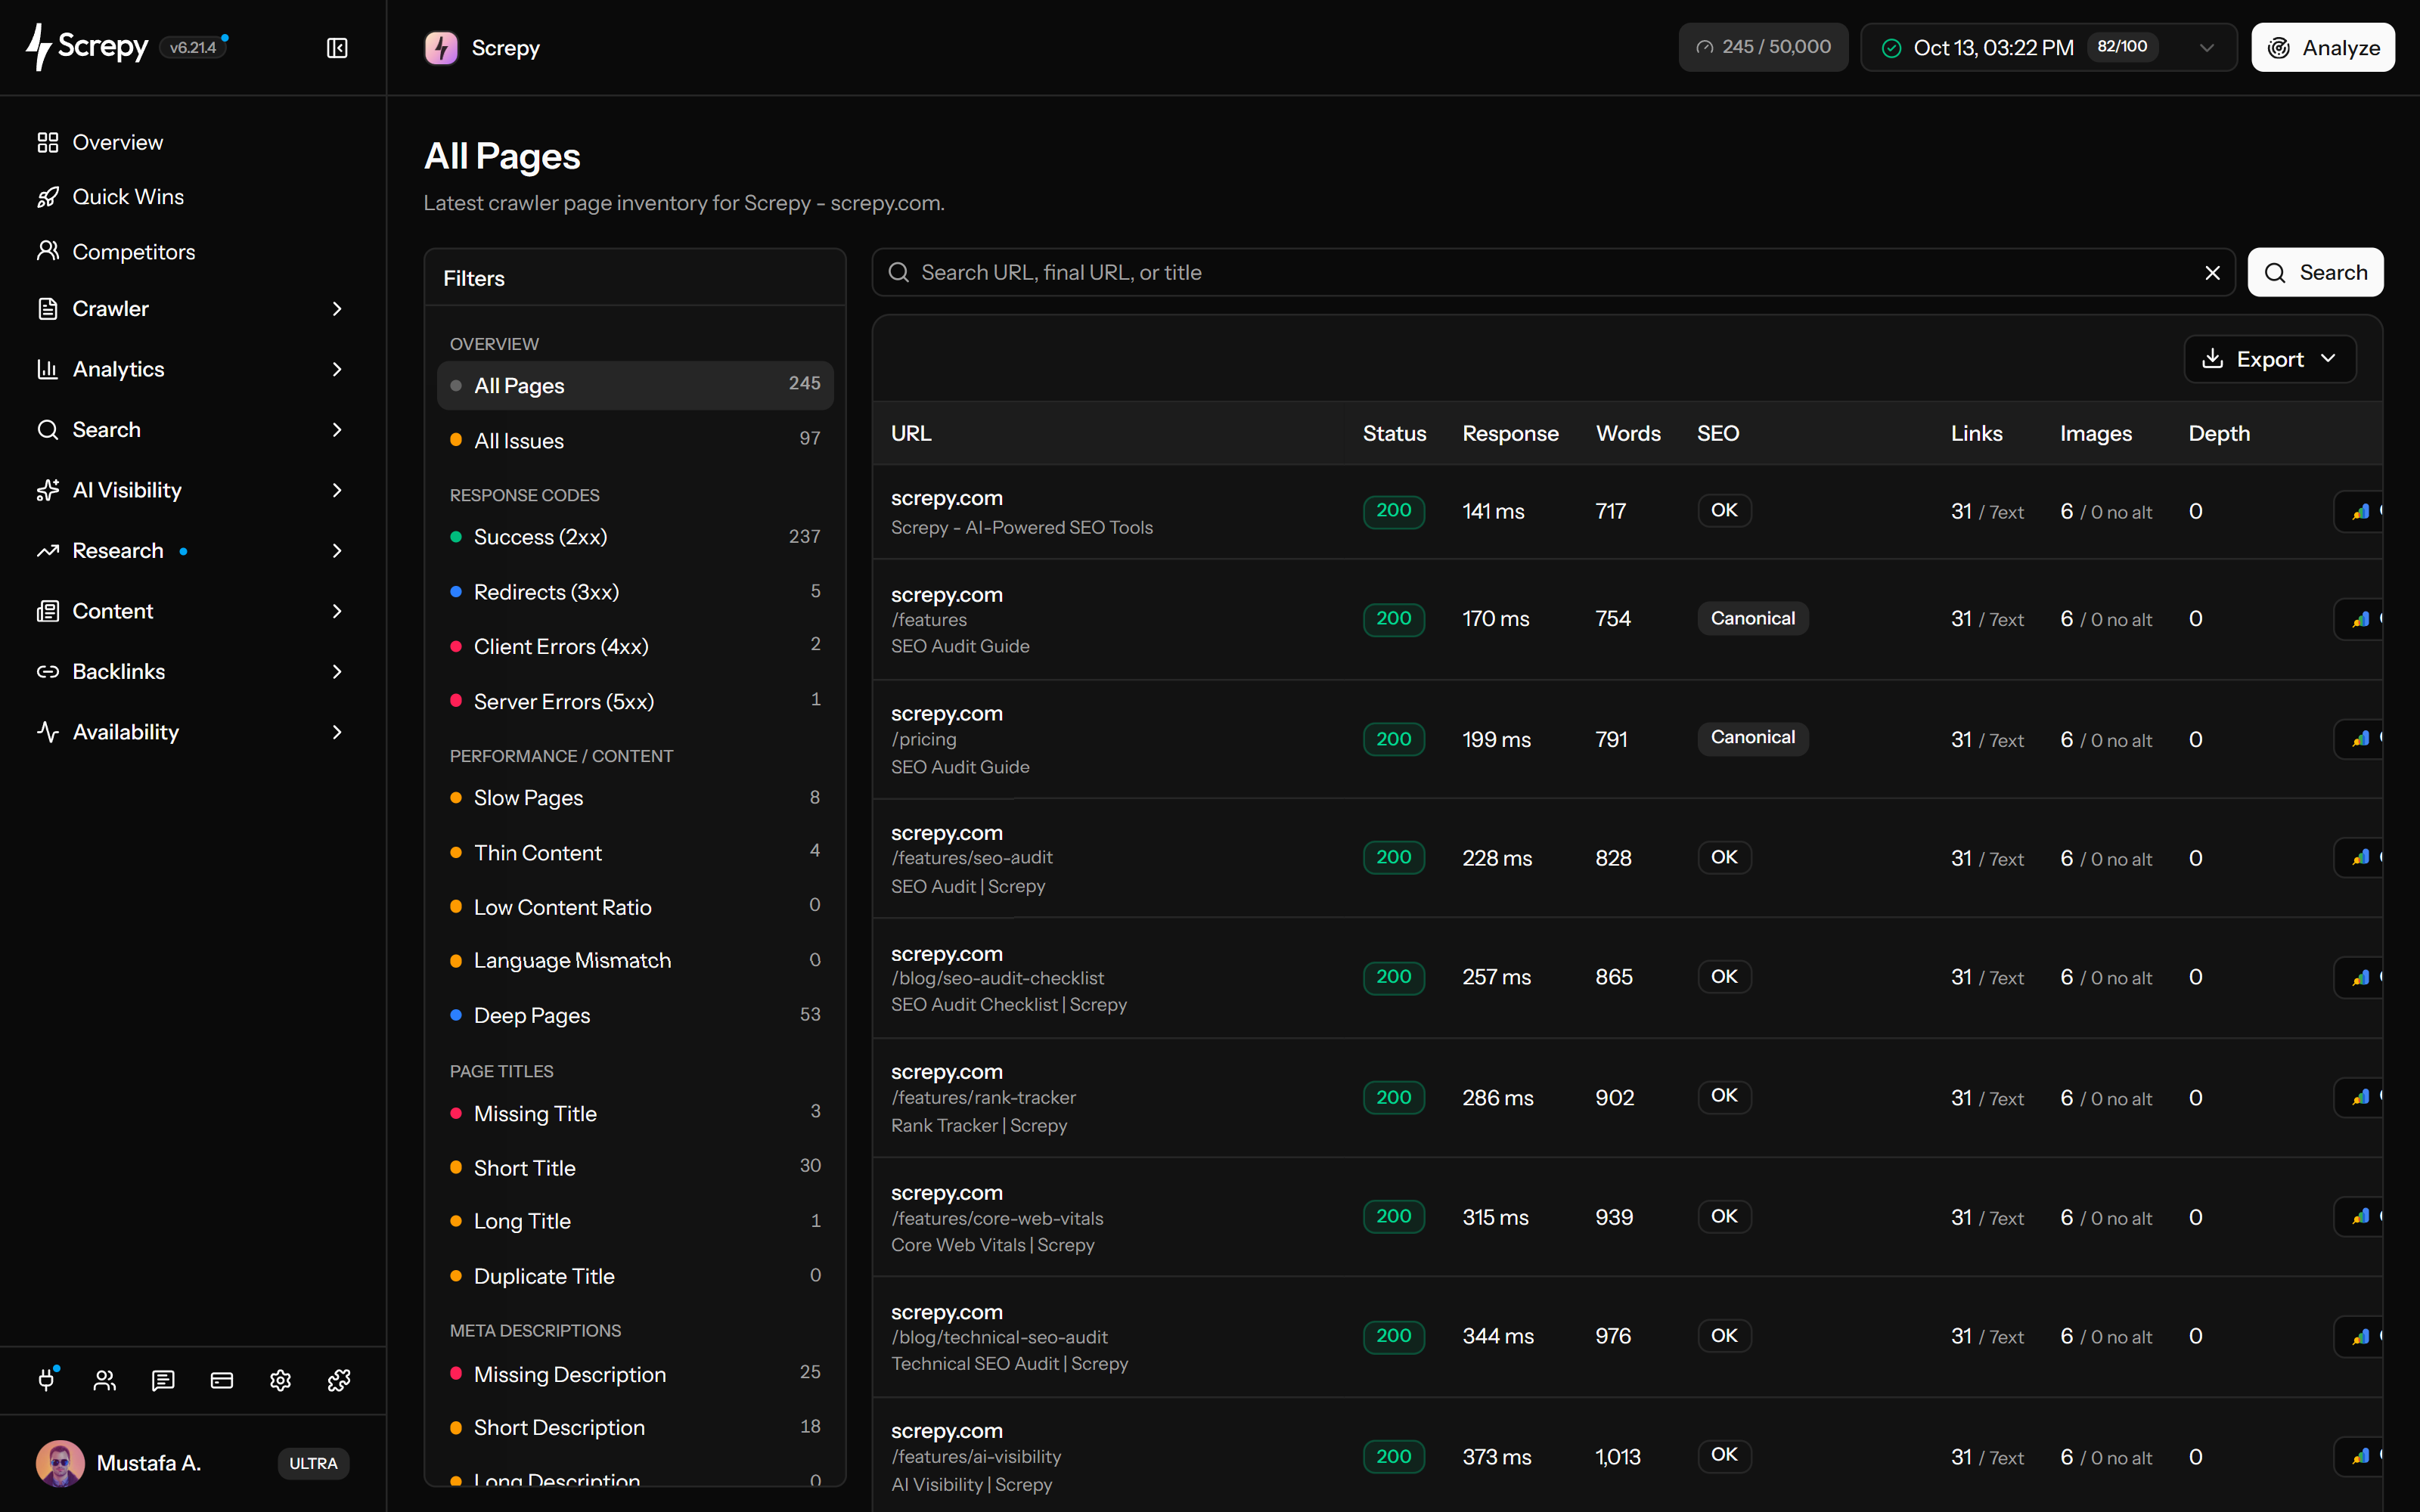


Screpy startet bei Ihrer Projektwebsite und folgt erreichbaren internen Links in der Cloud. Der erste Crawl beginnt bei der Einrichtung; später erstellen Sie über Analysieren im Seiten-, Link- oder Bilderbericht ein neues Inventar.
Clientseitige Navigation kann wichtige Links im ursprünglichen HTML verbergen. Aktivieren Sie JavaScript-Rendering, wenn Skripte wesentliche Inhalte oder Navigation erzeugen; lassen Sie es aus, wenn der Server bereits das benötigte HTML liefert.
<main id="app">
  <script />
</main>Entdeckungsumfang und Anfragetempo lösen unterschiedliche Probleme. Die Tiefe bestimmt die verfolgten internen Linkebenen; Parallelität und Verzögerung steuern die Serverlast. Größere Tiefe macht eine unverlinkte Seite nicht auffindbar.
example.com3
//shop//shop/linen/Verstehen Sie anhand erfasster URLs und Links, wie Kategorien, Produkte oder Artikel mit Ihrer Website verbunden sind. Nutzen Sie Quellseitenbeziehungen, um tiefe Inhalte, veraltete Navigation und Weiterleitungspfade zu untersuchen.
Erstellen Sie eine Arbeitsdatei aus den Datensätzen, die Ihr Team benötigt. Filtern Sie vor dem Export den ausgewählten Crawl, statt die gesamte Website zu übergeben, wenn es nur um eine Vorlage, einen Antwortstatus oder ein Dateimuster geht.
Ein abgeschlossener Crawl erfasst die Website so, wie sie zu diesem Zeitpunkt erreicht wurde. Crawlen Sie nach einer Navigationsänderung oder Migration erneut, um Entdeckung und Ziele zu prüfen; alte Datensätze aktualisieren sich nicht mit der Live-Website.
Verbinden Sie Ihren KI-Assistenten mit Screpys SEO-MCP-Server. Fragen Sie nach dem letzten abgeschlossenen Crawl, prüfen Sie betroffene Seiten und priorisieren Sie technische SEO-Aufgaben.
Umfang sichtbar halten, Datensätze hinter einem Muster prüfen, Ursache beheben und nächsten Crawl zur Bestätigung verwenden.
Start-URL, Kapazität, Tiefe, JavaScript, Parallelität, Verzögerung, Robots-Regeln und Zugriff bestätigen. Diese Einstellungen bestimmen den Snapshot.
Zugängliche Pfade verfolgen und URL, Antwort, Tiefe, Ziel, Linkbeziehung und Seiten- oder Bilddaten im Umfang speichern.
Pages, Links und Images von Summen zu repräsentativen URLs, Quellen, Redirects, Metadaten, Canonicals oder Bildnutzung öffnen.
Nach Änderung erneut crawlen, Umfang und Einstellungen vergleichbar halten und betroffene URLs sowie Muster verifizieren.
Crawl-Daten helfen am meisten, wenn das Team weiß, was geändert wurde. Vor riskanter Arbeit Basis und danach vergleichbaren Snapshot erstellen.
Wichtige URLs, Redirects, Ziele, Canonicals und interne Pfade vor dem Launch speichern und neue Struktur gleich crawlen.
Rendering nutzen, wenn Navigation oder Content im Browser entsteht, und URLs im Inventar bestätigen.
Tiefe, Quellen, Anker, Attribute und Navigationspfade prüfen und schwach verbundene Inhalte finden.
Nach Routing-, Navigation-, CMS-, Template- und Komponentenänderungen erneut crawlen, um Regressionen zu erkennen.
Screpy mit Screaming Frog vergleichen, wenn Bereitstellung, Controls, Extraktion, Monitoring, Teamzugriff und Reporting zählen.
SEO-Crawler für Discovery-Pfade und Pages-, Links- und Images-Datensätze nutzen; Website Audit für gruppierte Befunde und Prioritäten.
Cloud-Crawl konfigurieren, erreichbare URLs abbilden und Rohdaten hinter technischen Mustern prüfen.
Crawl in gruppierte Befunde, URL-Muster, Prioritäten, Exporte und verifizierbaren Fix-Workflow verwandeln.
Gemeinsame Templates und wechselnde URL-Mengen erzeugen unterschiedliche Risiken für SaaS- und E-Commerce-Websites.
Landingpages, Dokumentation, gemeinsame Templates und Release-Regressionen als Akquisitionsfläche prüfen.
Kategorien, Produktseiten, fehlerhafte Kaufpfade und Katalogänderungen auditieren.
Screpy-Dokumentation
Screpy-Leitfäden zu Crawl-Umfang, Crawler-Zugriff, Pages-, Links- und Images-Berichten und unvollständigen Ergebnissen nutzen.
Discovery, Umfang, JavaScript-Rendering, Zugriff, Anfragegeschwindigkeit, Berichte, Snapshots und Unterschied zum Website-Audit verstehen.
Ein SEO-Crawler startet bei einer Website-URL, folgt zugänglichen internen Links im definierten Umfang und speichert technische Informationen zu erreichten Seiten und Ressourcen. Das Inventar hilft bei Pfaden, Statuscodes, Redirects, Canonicals, Links, Metadaten, Bildern und wiederholten Mustern.
Ja. Jeder abgeschlossene Crawl ist ein datierter Snapshot. Nach Release oder Fix mit gleichem Umfang und Einstellungen erneut crawlen und vergleichen.
Ja. Optionales Rendering hilft bei Links oder Content, die im Browser entstehen, umgeht aber keine Robots-Regeln, Authentifizierung, Firewalls, Bot-Challenges, Timeouts oder den Crawl-Umfang.
Pages speichert URL, Antwort, Tiefe, Metadaten, Überschriften, Canonical, Indexierbarkeit, Content und strukturierte Daten. Links verbindet Ziele mit Status, Ankern, Attributen, Nutzung und Quellen. Images gruppiert Quellen mit Status, Alt-Text, Abmessungen und Seitennutzung.
Beide beantworten unterschiedliche Fragen. Search Console meldet Suchleistung; der Crawler folgt internen Links proaktiv und erstellt ein technisches Inventar.
Der Crawler benötigt die echte Seite ohne Login, CAPTCHA, Browser-Challenge, Firewallblock oder Ratenlimit. ScrepyBot und dokumentierte Crawler-IP erlauben, robots.txt prüfen und echtes HTML bestätigen.
Screpy startet bei der Projektwebsite und folgt zugänglichen internen Links innerhalb von Kapazität und Tiefe. Eine Seite kann fehlen, wenn sie nicht verlinkt, zu tief, blockiert, außerhalb des Hosts umgeleitet, JavaScript-abhängig oder unbrauchbar ist.
Ja. Parallelität steuert, wie viele Anfragen gleichzeitig laufen. Eine Anfrageverzögerung ist bei Parallelität 1 verfügbar; bei höherer Parallelität wird die Verzögerung mit null gespeichert. Senken Sie den Anfragedruck, wenn Ihr Server automatisierten Traffic begrenzt, und prüfen Sie beim nächsten Crawl, ob echte Seitenantworten ankommen.
Maximale URLs begrenzen gespeicherte Entdeckungen; Tiefe begrenzt interne Linkebenen. Höhere Werte beheben keine Blockierung, fehlenden Links, Redirects, Ratenlimits oder unbrauchbare Antworten.
Der SEO-Crawler erstellt das technische Inventar mit URLs, Antworten, Pfaden, Seitendaten, Links, Bildern und Kontext. Website-Audit interpretiert diesen Crawl als gruppierte Befunde, Muster, Prioritäten und Fix-Workflow.
Ja. Der Links-Bericht zeigt fehlerhafte oder umgeleitete Ziele und führt sie zu den Quellseiten zurück, damit konkrete Quellen, Komponenten oder Templates korrigiert werden können.
Nein. Crawl-Daten helfen bei technischen Bedingungen; Rankings hängen auch von Relevanz, Content, Autorität, Wettbewerb, Nachfrage und Indexierung ab. Filter sind Untersuchungsbelege, keine automatischen Anweisungen.
Verstehen Sie Super-Intelligence-Begriffe und verbinden Sie Website-Audits, Suchrecherche, Rankings und KI-Sichtbarkeit in einem praktischen Screpy-Ablauf.