Massenprüfung des Google-Indexstatus

Prüfen Sie crawlbare URLs aus einem abgeschlossenen Website-Crawl gegen Googles Indexansicht, gruppieren Sie indexierte und nicht indexierte Seiten nach Abdeckungsgrund und untersuchen Sie jedes Ergebnis mit Wörtern, Überschriften, internen Links und Crawl-Tiefe.

Indexstatus der Website prüfen Audit-Leitfaden lesen
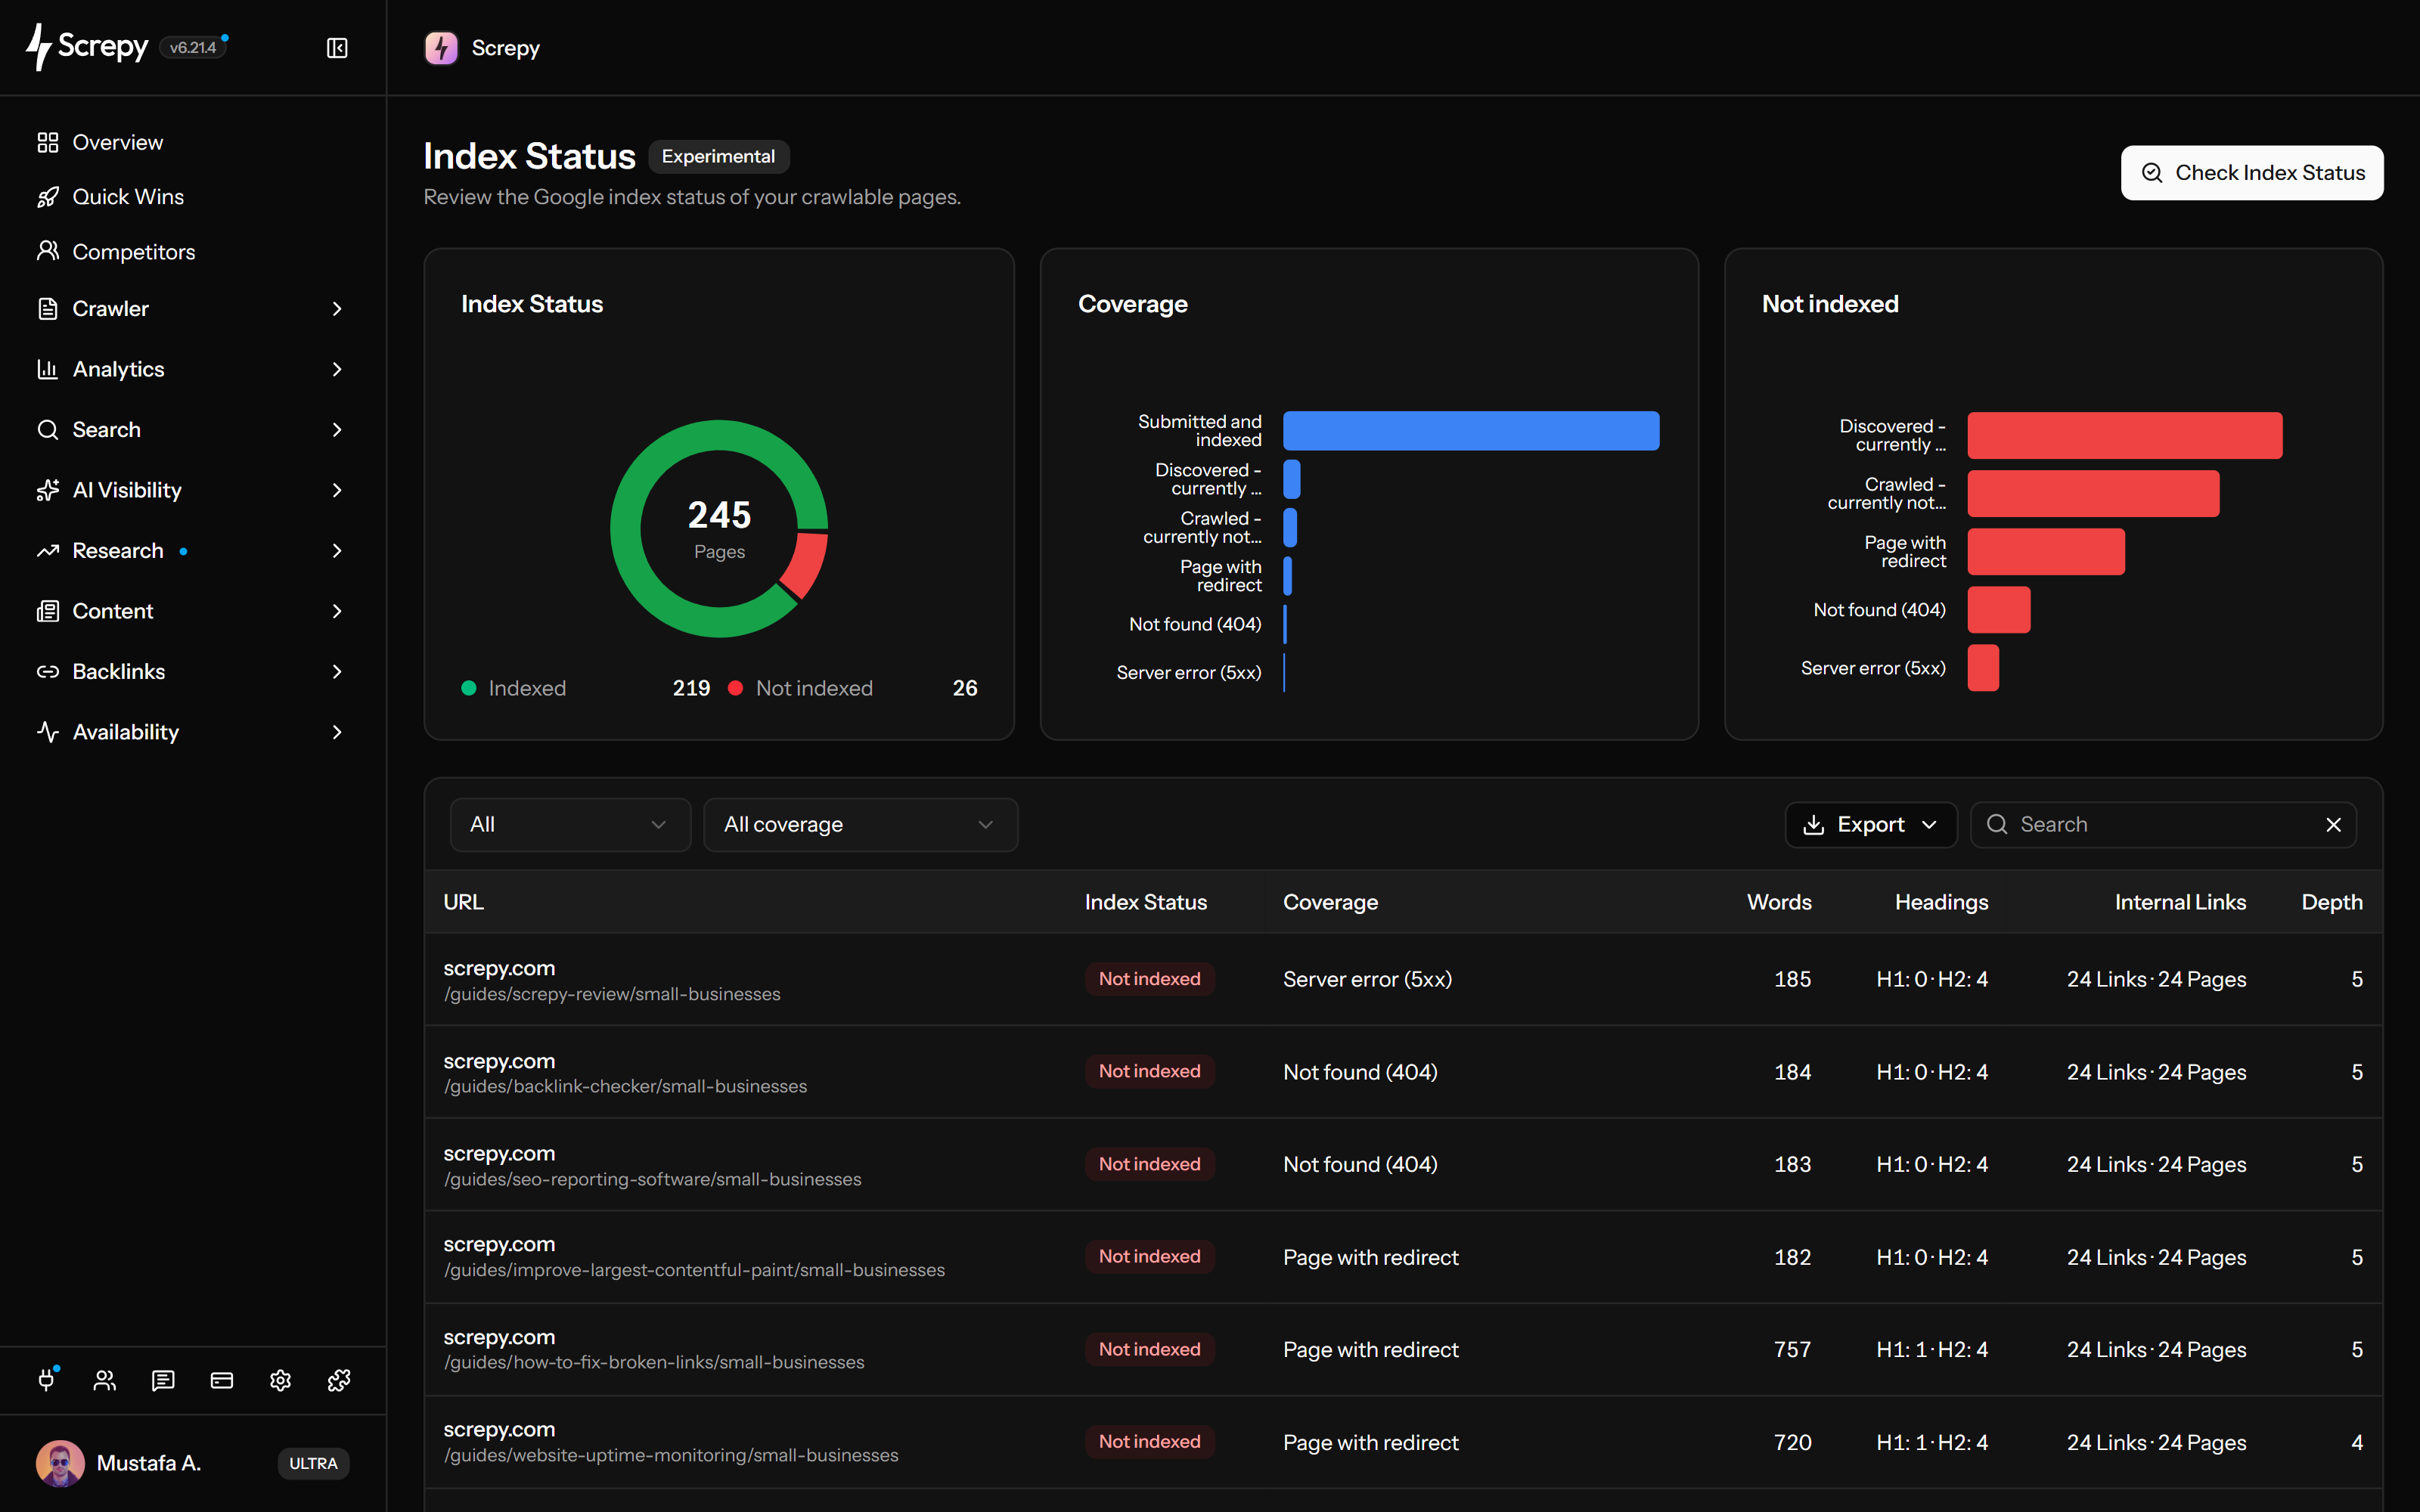
Screpy-Tabelle zum Indexstatus mit Seiten-URLs, Google-Indexabdeckung und Statusdetails
Uber-Logo im Vertrauensbereich der Screpy-SEO-Plattform
Philips-Logo im Vertrauensbereich der Screpy-SEO-Plattform
FedEx Express-Logo im Vertrauensbereich der Screpy-SEO-Plattform
Bosch-Logo im Vertrauensbereich der Screpy-SEO-Plattform
Champion-Logo im Vertrauensbereich der Screpy-SEO-Plattform
Iconfinder-Logo im Vertrauensbereich der Screpy-SEO-Plattform
T-Mobile-Logo im Vertrauensbereich der Screpy-SEO-Plattform
Carrefour-Logo im Vertrauensbereich der Screpy-SEO-Plattform
Stanley-Logo im Vertrauensbereich der Screpy-SEO-Plattform
Skoda-Logo im Vertrauensbereich der Screpy-SEO-Plattform

Google-Indexstatus prüfen

Beginnen Sie mit dem letzten erfolgreich abgeschlossenen Website-Crawl Ihres Projekts und der passenden Google-Search-Console-Property. Screpy prüft die dafür geeigneten URLs anhand von Googles Indexansicht; das Ergebnis beschreibt geprüfte Seiten, nicht sämtliche URLs Ihrer Website.

  • Der Crawl liefert Seiten mit 2xx-Antworten und entweder ohne Canonical oder mit einem Canonical, das ihrer endgültigen URL entspricht.
  • Wenn vorhanden, wird die endgültige URL verwendet; URLs außerhalb der verbundenen Property werden übersprungen.
  • Tabelle und Indexstatus-Übersicht enthalten abgeschlossene Prüfungen, keine ausstehenden, übersprungenen oder fehlgeschlagenen Anfragen.
  • Ein indexiertes Ergebnis garantiert weder Rankings noch Klicks oder eine Anzeige für eine bestimmte Suchanfrage.

Nicht indexierte Seiten finden

Grenzen Sie die Ergebnisse auf wichtige Seiten ein, die in der Google-Suche erscheinen sollen. Kombinieren Sie Indexstatus, Abdeckung und URL-Suche, um eine Produktkategorie, einen Artikelordner oder eine einzelne Landingpage zu prüfen, ohne jede ausgeschlossene URL als Fehler zu behandeln.

  • Wählen Sie Alle, Indexiert oder Nicht indexiert und kombinieren Sie dies mit einem verfügbaren Abdeckungsgrund.
  • Suchen Sie eine vollständige URL oder einen gemeinsamen Pfad, um verwandte Seiten desselben Audits zu untersuchen.
  • Entscheiden Sie, ob jede Seite indexiert sein soll; beabsichtigte Ausschlüsse und alternative Duplikate können korrekt sein.

Gründe der Indexabdeckung prüfen

Die Übersicht trennt indexierte und nicht indexierte Prüfungen, schlüsselt verfügbare Abdeckungszustände auf und zeigt Gründe nicht indexierter Seiten. Wiederkehrende Gründe helfen bei der Entscheidung, welche Templates oder URL-Gruppen zuerst untersucht werden sollten.

  • Lesen Sie den zurückgegebenen Abdeckungsgrund neben der URL; ein fehlender Grund bedeutet fehlende Information, keine Diagnose.
  • Vergleichen Sie Seiten mit demselben Grund und deren Zweck, bevor Sie eine gemeinsame Korrektur wählen.
  • Prüfen Sie aktuelle Bedingungen mit Website Audit und der Live-Seite; das Abdeckungslabel beschreibt Googles Indexansicht.

Crawl-Daten der Seiten prüfen

Behalten Sie die Crawl-Belege neben dem Indexergebnis im Blick. Wortzahl, H1/H2-Anzahl, eingehende interne Links, verlinkende Seiten und Tiefe stammen aus dem Crawl dieses Audits; sie können vom zuletzt durch Google verarbeiteten Seitenstand abweichen.

  • Vergleichen Sie Wort- und Überschriftenzahlen ähnlicher Seiten; Zahlen allein messen keine Inhaltsqualität.
  • Unterscheiden Sie eingehende Linkvorkommen von der Anzahl der Quellseiten, die auf die URL verlinken.
  • Untersuchen Sie mit der Crawl-Tiefe, wie weit eine wichtige Seite vom Startpunkt des Crawls entfernt liegt.
  • Ein Gedankenstrich bedeutet, dass die Kennzahl nicht verfügbar ist; prüfen Sie die Seite vor Schlussfolgerungen in Website Audit.

Indexstatus-Audits fortsetzen

Große Audits können das tägliche Inspektionslimit erreichen oder eine erneute Google-Verbindung benötigen. Audit fortsetzen steht für geeignete unterbrochene Läufe zur Verfügung und bewahrt abgeschlossene Prüfungen, statt die gesamte Untersuchung neu zu beginnen.

  • Setzen Sie mit derselben Search-Console-Property und dem Crawl-Bereich des ursprünglichen Audits fort.
  • Kehren Sie bei verfügbarer Prüfkapazität zurück oder verbinden Sie Google erneut, wenn die Autorisierung erneuert werden muss.
  • Die Fortsetzung bearbeitet ausstehende Arbeit; sie aktualisiert keine bereits geprüften Zeilen und startet kein abgeschlossenes Audit erneut.

Indexstatus-Ergebnisse exportieren

Laden Sie nach Anwendung der gewünschten Filter eine gezielte CSV- oder Excel-Datei herunter. Der Export umfasst die aktuell geladene Tabellenseite mit bis zu 50 Zeilen und eignet sich zur Übergabe einer Prüfung, nicht als Download des gesamten Audits.

  • Die Datei enthält URL, Indexierungskennzeichen, Abdeckungsgrund, Wortzahl und Crawl-Tiefe.
  • Zusammengefasste Überschriften- und interne Linkzellen stehen im Dashboard bereit, sind aber nicht in diesem Export enthalten.
  • Prüfen Sie Filter und aktuelle Seite vor dem Download; weitere Ergebnisseiten werden nicht automatisch hinzugefügt.

Indexierungsänderungen überprüfen

Schließen Sie nach der Korrektur einer zu indexierenden Seite einen neuen Website-Crawl ab und starten Sie ein neues Audit, sobald dies möglich ist. Ein fortgesetztes Audit behält bestehende Prüfungen; auch ein neues Audit verspricht keine sofortige Änderung in Googles Informationen.

  • Ein Projekt kann alle 5 Stunden ein neues Indexstatus-Audit starten; ein aktives Audit muss zuerst abgeschlossen oder anderweitig beendet sein.
  • Für kürzlich geprüfte URLs können dieselben Inspektionsinformationen bis zu 24 Stunden erneut verwendet werden.
  • Geben Sie Google Zeit zur Verarbeitung und bewerten Sie Sichtbarkeit getrennt von Indexierung mit Search-Console-Leistungsdaten.

Über Indexstatus sprechen. Mit SEO MCP.

Prüfen Sie bestehende Index-Status-Audits und URL-Datensätze über SEO MCP. Fragen Sie nach betroffenen Seiten und verfügbaren Search-Console-URL-Prüfungen; MCP startet kein neues Index-Status-Audit.

  1. Screpy: Hallo! Sehen wir uns Indexstatus für example.com an. Was möchten Sie wissen?
  2. Sie: Welche URLs benötigen Aufmerksamkeit im bestehenden Index-Status-Audit?
  3. Screpy: Beginnen Sie mit als prüfbedürftig markierten URLs und untersuchen Sie ihre Belege. Ein gespeichertes Audit ist eine Momentaufnahme, keine Garantie für den aktuellen Google-Index. Index-Belege: Bestehendes Audit: Gespeicherte URL-Datensätze. URL-Prüfung: Vorhandene Search-Console-Daten.
  4. Sie: Mach daraus einen kurzen Maßnahmenplan.
  5. Screpy: Ich trenne Befunde und Empfehlungen. Prüfen Sie die Belege, wählen Sie eine Änderung und kontrollieren Sie anschließend die Ergebnisse. Ihre nächsten Schritte: Prüfen: Quelle und Datum jedes Befunds kontrollieren.. Entscheiden: Die erste Änderung auswählen.. Verifizieren: Ergebnisse nach der Änderung vergleichen..
  6. Sie: Kannst du die Belege verständlich erklären?
  7. Screpy: Ja. Fragen Sie nach einem unterstützten Ergebnis. Ich erkläre, was es zeigt, woher es stammt und was unklar bleibt. Fehlende Daten bleiben nicht verfügbar; Empfehlungen sind keine automatischen Korrekturen.

Aus einer Massenprüfung wird eine gezielte Seitenuntersuchung.

Definieren Sie die URLs, die indexiert sein sollten, führen Sie das Audit gegen einen bekannten Crawl aus, gruppieren Sie wiederkehrende Abdeckungszustände und nutzen Sie den Seitenkontext, bevor Sie Änderungen entscheiden.

  1. Festlegen, welche URLs indexiert sein sollen

    Beginnen Sie mit dem Zweck der Seite. Identifizieren Sie kanonische Produkt-, Service-, Kategorie-, Artikel- oder Kampagnen-URLs für die Suche und trennen Sie Duplikate, Weiterleitungen, Filter und bewusst ausgeschlossene Seiten.

  2. Passende Property verbinden und Crawl abschließen

    Verbinden Sie die passende Search-Console-Property. Ein neues Indexstatus-Audit verwendet automatisch den letzten erfolgreichen Website-Crawl; schließen Sie bei Website-Änderungen zuerst einen neuen Crawl ab.

  3. Indexstatus-Audit ausführen

    Starten Sie das Audit und prüfen Sie abgeschlossene Zeilen, sobald sie verfügbar sind. Nutzen Sie die Übersicht indexierter/nicht indexierter URLs und die Abdeckungsdiagramme; befolgen Sie Hinweise zu Limits oder erneuter Verbindung und setzen Sie fort, sobald das Audit dafür geeignet ist.

  4. Beweise gruppieren, bevor Sie URLs öffnen

    Beginnen Sie mit den Summen indexiert gegenüber nicht indexiert und nutzen Sie danach die Diagramme zu Abdeckung und Gründen. Filtern Sie nach Status, Abdeckungsstatus, vollständiger URL oder gemeinsamem Pfadmuster.

  5. Seite untersuchen und später verifizieren

    Vergleichen Sie Crawl-Kontext, Abdeckungsgrund und Seitenzweck. Korrigieren Sie nur zu indexierende Seiten, schließen Sie einen neuen Crawl ab und starten Sie bei Verfügbarkeit ein neues Audit. Berücksichtigen Sie wiederverwendete Inspektionsinformationen und Googles Verarbeitungszeit.

Nutzen Sie Indexstatus, wenn Seitenwert und Muster zusammentreffen.

Das Audit ist besonders hilfreich, wenn es einen großen Crawl auf geschäftskritische URLs, gemeinsame Abdeckungsgründe, schwache Entdeckungspfade oder vergleichbare Seitengruppen eingrenzt.

Geschäftskritische Seiten schützen

Suchen Sie wichtige Produkt-, Service-, Kategorie-, Standort- oder Artikel-URLs und prüfen Sie, ob ihr Indexstatus zur vorgesehenen Rolle in der organischen Auffindbarkeit passt.

  • Prüfung priorisierter URLs
  • Indexierter gegenüber beabsichtigtem Status
  • Seitenbezogene Belege

Wiederkehrende Abdeckungsmuster finden

Gruppieren Sie nicht indexierte URLs nach dem verfügbaren Google-Abdeckungsgrund und prüfen Sie gemeinsame Templates oder Pfadmuster, bevor Sie jede betroffene Seite als eigenes Problem behandeln.

  • Abdeckungsgruppierung
  • Template-Muster
  • Prüfung gemeinsamer Ursachen

Schwache Entdeckungspfade untersuchen

Nutzen Sie eingehende interne Links, Quellseitenanzahl und Crawl-Tiefe, um zu sehen, ob eine wichtige URL in der gecrawlten Website-Struktur schwer auffindbar ist.

  • Eingehende interne Links
  • Verlinkende Quellseiten
  • Crawl-Tiefe

Inhaltskontext neben dem Indexstatus prüfen

Vergleichen Sie Wort- und Überschriftenanzahlen ähnlicher URLs, um dünne, uneinheitliche oder unerwartet leere Seiten für eine genauere Seiten- und Template-Prüfung zu finden.

  • Wörter
  • H1- und H2-Anzahl
  • Vergleichbare Seitengruppen

Interpretieren Sie Google-Indexinformationen, ohne jeden Status als Fehler zu behandeln.

Indexierung ist für die Suchberechtigung nötig, aber ein Status erklärt weder Seitenwert, aktuelle Indexierbarkeit, Rankingpotenzial noch die richtige technische Maßnahme.

Nicht indexiert bedeutet nicht immer fehlerhaft

Duplikate, alternative URLs, Weiterleitungen und bewusst ausgeschlossene Seiten können korrekt außerhalb des Google-Index bleiben. Entscheiden Sie zuerst, ob die URL indexiert werden soll.

Indexiert garantiert keine Sichtbarkeit

Eine indexierte Seite kann erscheinen, aber das Ergebnis verspricht weder Rankings, Impressionen, Klicks noch das Erscheinen für eine bestimmte Suchanfrage.

Das Ergebnis ist Googles Indexansicht

Das Audit führt keinen Live-URL-Test aus. Eine aktuelle Änderung an Inhalt, Direktive, Canonical oder Server ist möglicherweise noch nicht in den zurückgegebenen Indexinformationen enthalten.

Das Audit nutzt einen bekannten Crawl-Bereich

Screpy prüft crawlbare URLs des ausgewählten abgeschlossenen Crawls, nicht jede historische oder extern entdeckte URL, die Google kennen könnte. Inspektionslimits können ein großes Audit zudem pausieren.

Wählen Sie den Workflow, der Ihre Indexierungsfrage beantwortet.

Verwenden Sie Indexstatus für Googles Indexansicht gecrawlter URLs, Website Audit für aktuelle Crawl- und Seitensignale und Search Console für beobachtete Suchleistung.

Screpy-Dokumentation

Indexstatus analysieren lernen

Nutzen Sie den Screpy-Leitfaden, um indexierte und nicht indexierte URLs zu prüfen, Abdeckungsgründe zu untersuchen und Änderungen zu validieren.

Indexstatus-Leitfaden lesen

FAQ zum Google-Indexstatus-Checker

Verstehen Sie, was ein Indexstatus-Audit meldet, welche Voraussetzungen es hat und wie das Ergebnis in Ihren SEO-Workflow passt.

Was prüft Screpy Indexstatus?

Screpy Indexstatus vergleicht crawlbare URLs eines abgeschlossenen Projekt-Crawls mit Indexinformationen der verbundenen Google-Search-Console-Property. Für die geprüften URLs werden indexierte und nicht indexierte Zustände, verfügbare Abdeckungsgründe und der zugehörige Crawl-Kontext gemeldet.

Ist Screpy Indexstatus experimentell?

Das Dashboard kennzeichnet Indexstatus derzeit als experimentell. Auditstatus und verfügbare Google-Abdeckungsinformationen können sich ändern. Prüfen Sie wichtige Ergebnisse daher gegen die aktuelle Seite, Search Console und einen frischen Crawl.

Führt Indexstatus einen Live-URL-Test aus?

Nein. Das Audit prüft die in Googles Index über die verbundene Search-Console-Property vertretene Version. Es testet nicht die aktuelle Live-Seite und beweist nicht, dass eine aktuelle Änderung bereits verarbeitet wurde.

Ist jede nicht indexierte URL ein SEO-Problem?

Nein. Doppelte, alternative, weitergeleitete, bewusst mit noindex versehene oder unnötige URLs können korrekt außerhalb des Google-Index bleiben. Entscheiden Sie zuerst, ob die URL indexiert werden soll.

Warum kann eine indexierte Seite trotzdem wenig Sichtbarkeit haben?

Indexiert bedeutet, dass Google eine Version der Seite im Index hat; Rankings, Impressionen, Klicks oder eine bestimmte Position sind damit nicht garantiert. Prüfen Sie Seite, Suchintention, technische Bedingungen und Suchleistung vor der nächsten Maßnahme.

Was benötigt ein Indexstatus-Audit?

Das Projekt benötigt eine verbundene, zugängliche Google-Search-Console-Property und einen erfolgreichen Website-Crawl. Ein neues Audit verwendet automatisch den letzten erfolgreichen Crawl. Es kann nur ein Audit aktiv sein; neue Audits können alle 5 Stunden gestartet werden.

Fordert Screpy Indexierung bei Google an?

Nein. Indexstatus meldet Google-Indexinformationen für die geprüften URLs. Es sendet keine Indexierungsanfragen, erzwingt keinen Crawl und garantiert nicht, dass eine URL in der Google-Suche erscheint.

Enthält das Audit jede Google bekannte URL?

Nein. Ein neues Audit beginnt mit 2xx-Seiten des letzten erfolgreichen Crawls, ohne Canonical oder mit einem Canonical passend zur endgültigen URL. Nur URLs innerhalb der verbundenen Property werden geprüft. Einige gecrawlte URLs sind ausgeschlossen; dies ist nicht Googles vollständiges URL-Inventar. Eine fehlende Ergebniszeile bedeutet nicht automatisch nicht indexiert: Die URL kann außerhalb des Bereichs liegen, ausstehen, übersprungen sein oder eine fehlgeschlagene Prüfung haben.

Kann ich ein unvollständiges Indexstatus-Audit fortsetzen?

Ja. Wenn ein Audit fortsetzbar ist, wählen Sie Audit fortsetzen, um dieselbe Prüfung mit dem vorhandenen Fortschritt weiterzuführen. Ein tägliches Inspektionslimit oder ein unterbrochener Lauf kann eine spätere Rückkehr erfordern.