Masowy sprawdzacz statusu indeksacji Google

Porównaj możliwe do przeskanowania adresy URL z zakończonego crawlu witryny z widokiem indeksacji Google, grupuj strony zindeksowane i niezindeksowane według przyczyny pokrycia oraz analizuj każdy wynik na podstawie słów, nagłówków, linków wewnętrznych i głębokości crawlu.

Sprawdź status indeksacji witryny Przeczytaj przewodnik audytu
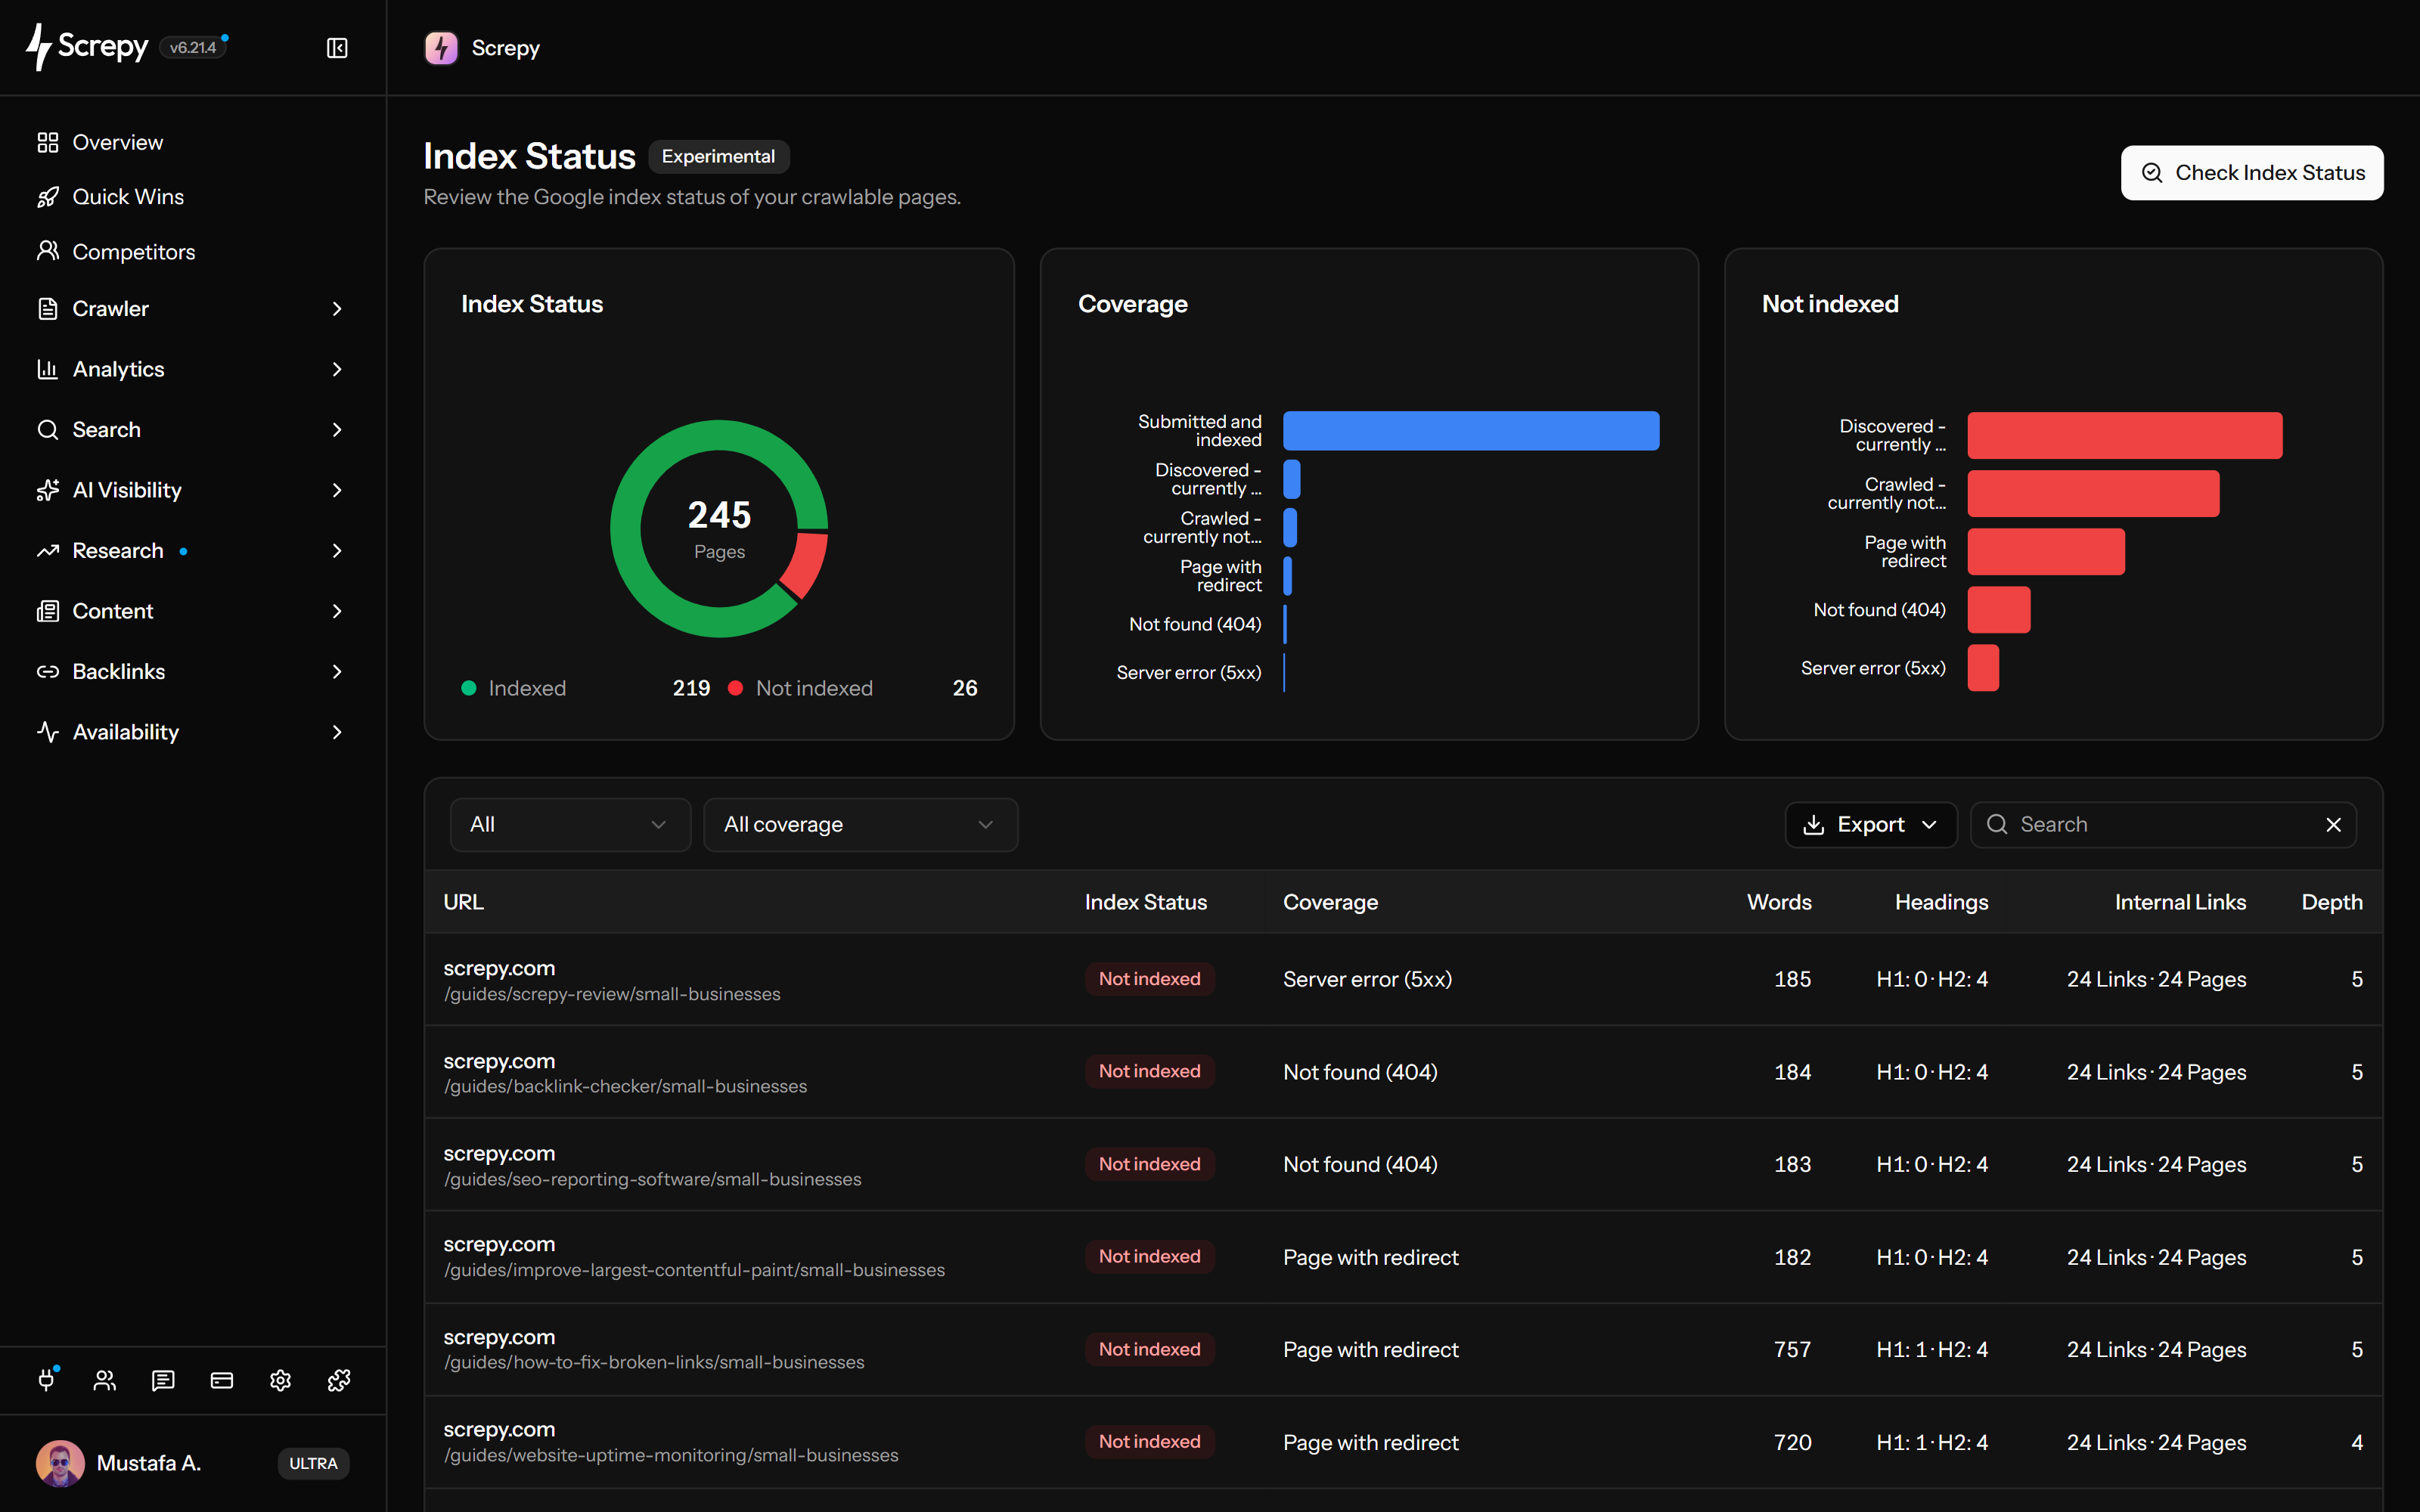
Tabela stanu indeksowania Screpy z adresami URL, pokryciem indeksu Google i szczegółami statusu
Logo Uber w sekcji zaufania klientów platformy SEO Screpy
Logo Philips w sekcji zaufania klientów platformy SEO Screpy
Logo FedEx Express w sekcji zaufania klientów platformy SEO Screpy
Logo Bosch w sekcji zaufania klientów platformy SEO Screpy
Logo Champion w sekcji zaufania klientów platformy SEO Screpy
Logo Iconfinder w sekcji zaufania klientów platformy SEO Screpy
Logo T-Mobile w sekcji zaufania klientów platformy SEO Screpy
Logo Carrefour w sekcji zaufania klientów platformy SEO Screpy
Logo Stanley w sekcji zaufania klientów platformy SEO Screpy
Logo Skoda w sekcji zaufania klientów platformy SEO Screpy

Sprawdź indeksowanie w Google

Zacznij od ostatniego pomyślnie zakończonego crawla witryny w projekcie oraz odpowiadającej mu usługi Google Search Console. Screpy sprawdza kwalifikujące się URL-e według informacji z indeksu Google; wyniki opisują sprawdzone strony, a nie wszystkie adresy witryny.

  • Crawl dostarcza strony z odpowiedziami 2xx i bez canonicala albo z canonicalem zgodnym z końcowym URL-em.
  • Gdy jest dostępny, używany jest końcowy URL; adresy poza zakresem połączonej usługi są pomijane.
  • Tabela i podsumowanie indeksowania zawierają zakończone inspekcje, nie oczekujące, pominięte ani nieudane żądania.
  • Wynik zaindeksowania nie gwarantuje pozycji, kliknięć ani wyświetlenia dla konkretnego zapytania.

Znajdź strony poza indeksem

Zawęź wyniki do ważnych stron, które powinny pojawiać się w Google Search. Połącz stan indeksowania, pokrycie i wyszukiwanie URL, aby zbadać kategorię produktów, katalog artykułów lub stronę docelową bez uznawania każdego wykluczenia za usterkę.

  • Wybierz Wszystkie, Zaindeksowane lub Niezaindeksowane i połącz wybór z dostępnym powodem pokrycia.
  • Wyszukaj pełny URL lub wspólną ścieżkę, aby zbadać powiązane strony w tym samym audycie.
  • Ustal, czy każda strona powinna być indeksowana; celowe wykluczenia i alternatywne duplikaty mogą być prawidłowe.

Przejrzyj powody pokrycia indeksu

Podsumowanie oddziela inspekcje zaindeksowane od niezaindeksowanych, pokazuje rozkład dostępnych stanów pokrycia i powody dla stron poza indeksem. Powtarzające się powody pomagają wybrać szablony lub grupy URL do zbadania w pierwszej kolejności.

  • Odczytaj zwrócony powód przy każdym URL-u; brak powodu oznacza niedostępną informację, a nie diagnozę.
  • Porównaj strony z tym samym powodem oraz ich przeznaczenie, zanim wybierzesz wspólną poprawkę.
  • Sprawdź bieżące warunki w Website Audit i na opublikowanej stronie; etykieta pokrycia opisuje widok indeksu Google.

Sprawdź dane crawla stron

Podczas badania czytaj dane crawla obok wyniku indeksowania. Liczby słów, H1/H2, przychodzących linków wewnętrznych, linkujących stron i głębokość pochodzą z crawla użytego przez audyt i mogą różnić się od wersji ostatnio przetworzonej przez Google.

  • Porównuj liczby słów i nagłówków podobnych stron; same liczby nie mierzą jakości treści.
  • Odróżnij liczbę wystąpień linków przychodzących od liczby stron źródłowych linkujących do URL-a.
  • Użyj głębokości crawla, aby zbadać odległość ważnej strony od punktu rozpoczęcia crawla.
  • Myślnik oznacza niedostępną metrykę; sprawdź stronę w Website Audit przed wyciągnięciem wniosków.

Wznów audyty indeksowania

Duże audyty mogą zatrzymać się na dziennym limicie inspekcji lub wymagać ponownego połączenia z Google. Kontynuacja audytu jest dostępna dla kwalifikujących się przerwanych uruchomień i zachowuje zakończone inspekcje zamiast zaczynać całe badanie od nowa.

  • Kontynuuj z tą samą usługą Search Console i zakresem crawla pierwotnego audytu.
  • Wróć, gdy będzie dostępny limit inspekcji, lub połącz Google ponownie, jeśli autoryzacja wymaga odnowienia.
  • Kontynuacja przetwarza pozostałą pracę; nie odświeża sprawdzonych wierszy i nie uruchamia ponownie zakończonego audytu.

Eksportuj wyniki indeksowania

Po zastosowaniu potrzebnych filtrów pobierz wybrany zestaw wyników w pliku CSV lub Excel. Eksport obejmuje aktualnie załadowaną stronę tabeli, do 50 wierszy; służy przekazaniu danych do przeglądu, a nie pobraniu całego audytu.

  • Plik zawiera URL, znacznik indeksowania, powód pokrycia, liczbę słów i głębokość crawla.
  • Zbiorcze komórki nagłówków i linków wewnętrznych są dostępne w panelu, ale nie są uwzględnione w tym eksporcie.
  • Przed pobraniem sprawdź filtry i bieżącą stronę; inne strony wyników nie są dodawane automatycznie.

Zweryfikuj zmiany indeksowania

Po poprawieniu strony przeznaczonej do indeksowania ukończ kolejny crawl witryny i rozpocznij nowy audyt, gdy będzie to możliwe. Kontynuacja starego audytu zachowuje jego inspekcje; również nowy audyt nie obiecuje natychmiastowej zmiany informacji Google.

  • Projekt może uruchomić nowy audyt indeksowania co 5 godzin; najpierw trzeba zakończyć lub rozwiązać aktywny audyt.
  • Dla niedawno sprawdzonych URL-i te same informacje z inspekcji mogą być ponownie używane przez maksymalnie 24 godziny.
  • Daj Google czas na przetworzenie strony i oceniaj widoczność oddzielnie na podstawie danych skuteczności Search Console.

Porozmawiaj o Stan indeksowania. Z SEO MCP.

Sprawdź istniejące audyty Index Status i rekordy URL przez SEO MCP. Pytaj o dotknięte problemem strony i dostępne dowody inspekcji URL z Search Console; MCP nie uruchamia nowego audytu.

  1. Screpy: Cześć! Przyjrzyjmy się Stan indeksowania dla example.com. Co chcesz wiedzieć?
  2. Ty: Które URL wymagają uwagi w istniejącym audycie Index Status?
  3. Screpy: Zacznij od URL oznaczonych do sprawdzenia i przejrzyj ich dowody. Zapisany audyt to stan z konkretnej chwili, nie gwarancja aktualnego indeksu Google. Dowody indeksowania: Istniejący audyt: Zapisane rekordy URL. Inspekcja URL: Dostępne dane Search Console.
  4. Ty: Zamień to w krótki plan działania.
  5. Screpy: Oddzielę ustalenia od rekomendacji. Sprawdź dowody, wybierz jedną zmianę i później zweryfikuj wyniki. Twoje następne kroki: Sprawdź: Zweryfikuj źródło i datę każdego ustalenia.. Zdecyduj: Wybierz pierwszą zmianę.. Zweryfikuj: Porównaj wyniki po zmianie..
  6. Ty: Możesz wyjaśnić dowody prostymi słowami?
  7. Screpy: Tak. Zapytaj o obsługiwany wynik, a wyjaśnię, co pokazuje, skąd pochodzi i co pozostaje niepewne. Brakujące dane pozostają niedostępne; rekomendacje nie są automatycznymi poprawkami.

Zamień zbiorcze sprawdzanie indeksu w ukierunkowane badanie stron.

Zdefiniuj URL-e, które powinny być indeksowane, uruchom audyt na znanym crawlu, grupuj powtarzalne stany pokrycia i użyj kontekstu strony przed decyzją o zmianie.

  1. Zdefiniuj URL-e do indeksowania

    Zacznij od celu strony. Wskaż kanoniczne URL-e produktu, usługi, kategorii, artykułu lub kampanii kwalifikujące się do wyszukiwania i oddziel duplikaty, przekierowania, filtry oraz strony celowo wykluczone.

  2. Połącz właściwą usługę i zakończ crawl

    Połącz usługę Search Console odpowiadającą projektowi. Nowy audyt automatycznie używa ostatniego pomyślnie zakończonego crawla witryny; po zmianach w witrynie najpierw ukończ nowy crawl.

  3. Uruchom audyt Index Status

    Uruchom audyt i przeglądaj sprawdzone wiersze, gdy będą dostępne. Użyj podsumowania indeksowania i wykresów pokrycia; postępuj zgodnie z komunikatami o limicie lub ponownym połączeniu i kontynuuj, gdy audyt będzie się do tego kwalifikować.

  4. Grupuj dane przed otwarciem URL-i

    Zacznij od sum indeksowanych i nieindeksowanych, następnie użyj wykresów pokrycia i powodów. Filtruj według statusu, stanu pokrycia, pełnego URL-a lub wspólnej ścieżki.

  5. Zbadaj stronę i zweryfikuj później

    Porównaj kontekst crawla z powodem pokrycia i przeznaczeniem strony. Popraw tylko strony do indeksowania, ukończ kolejny crawl i uruchom nowy audyt, gdy będzie to możliwe. Uwzględnij ponownie używane informacje z inspekcji oraz czas przetwarzania przez Google.

Używaj Index Status tam, gdzie ważność stron spotyka powtarzalne wzorce.

Audyt jest najbardziej przydatny, gdy zawęża duży crawl do kluczowych URL-i, wspólnych powodów pokrycia, słabych ścieżek odkrywania lub porównywalnych grup stron.

Chroń strony kluczowe dla firmy

Wyszukuj ważne URL-e produktów, usług, kategorii, lokalizacji lub artykułów i potwierdzaj, że ich stan indeksacji odpowiada roli w organicznym odkrywaniu.

  • Przegląd priorytetowych adresów URL
  • Stan indeksowania a oczekiwany stan
  • Dane dotyczące poszczególnych stron

Znajdź powtarzalne wzorce pokrycia

Grupuj nieindeksowane URL-e według dostępnego powodu pokrycia Google, a następnie sprawdzaj wspólne szablony lub wzorce ścieżek.

  • Grupowanie według pokrycia
  • Wzorce szablonów
  • Analiza wspólnej przyczyny problemów

Zbadaj słabe ścieżki odkrywania

Użyj przychodzących linków wewnętrznych, liczby stron źródłowych i głębokości crawlu, aby sprawdzić, czy ważny URL jest trudny do odkrycia w strukturze witryny.

  • Przychodzące linki wewnętrzne
  • Strony źródłowe linków
  • Głębokość crawla

Sprawdź kontekst treści obok stanu indeksu

Porównuj liczbę słów i nagłówków między podobnymi URL-ami, aby znaleźć cienkie, niespójne lub nieoczekiwanie puste strony wymagające dokładniejszego przeglądu strony i szablonu.

  • Liczba słów
  • Liczba nagłówków H1 i H2
  • Porównywalne grupy stron

Interpretuj informacje o indeksie Google bez uznawania każdego stanu za błąd.

Indeksacja jest niezbędna do obecności w wyszukiwaniu, ale sam status nie wyjaśnia wartości strony, bieżącej indeksowalności, potencjału rankingu ani właściwego działania technicznego.

Nieindeksowane nie zawsze znaczy uszkodzone

Duplikaty, alternatywne URL-e, przekierowania i celowo wykluczone strony mogą prawidłowo pozostać poza indeksem Google. Najpierw zdecyduj, czy URL powinien być indeksowany.

Indeksacja nie gwarantuje widoczności

Zindeksowana strona kwalifikuje się do wyświetlenia, ale wynik nie gwarantuje pozycji, wyświetleń, kliknięć ani pojawienia się dla konkretnego zapytania.

Wynik to zindeksowany widok Google

Audyt nie wykonuje testu URL-a na żywo. Niedawna zmiana treści, dyrektywy, canonicala lub serwera może nie być jeszcze odzwierciedlona w informacjach indeksu zwróconych dla strony.

Audyt korzysta ze znanego zakresu crawlu

Screpy sprawdza crawlowalne URL-e z wybranego ukończonego crawlu, a nie każdy historyczny lub zewnętrznie odkryty adres znany Google. Limity inspekcji mogą też wstrzymać duży audyt.

Wybierz workflow odpowiadający pytaniu o indeksowanie.

Użyj Index Status do zindeksowanego widoku Google dla crawlowanych URL-i, Website Audit do bieżących sygnałów crawlu i strony oraz Search Console do obserwowanej wydajności wyszukiwania.

Dokumentacja Screpy

Dowiedz się, jak analizować stan indeksu

Skorzystaj z poradnika Screpy, aby sprawdzać zindeksowane i niezindeksowane URL-e, badać powody pokrycia i weryfikować zmiany.

Przeczytaj przewodnik Index Status

Częste pytania o tester stanu indeksowania Google

Poznaj zakres raportu audytu Index Status, jego wymagania i miejsce wyniku w workflow SEO.

Co sprawdza Screpy Index Status?

Screpy Index Status porównuje crawlowalne URL-e z zakończonego crawlu projektu z informacjami indeksu z połączonej usługi Google Search Console. Raportuje stany zindeksowania, dostępne powody pokrycia i powiązany kontekst crawlu dla audytowanych URL-i.

Czy audyt obejmuje każdy URL znany Google?

Nie. Nowy audyt zaczyna od stron 2xx z ostatniego pomyślnego crawla, bez canonicala lub z canonicalem zgodnym z końcowym URL-em. Sprawdzane są tylko adresy w połączonej usłudze. Część przeskanowanych URL-i jest pomijana i nie jest to pełny inwentarz Google. Brak adresu w wynikach nie oznacza automatycznie braku indeksacji: URL może być poza zakresem, oczekiwać, być pominięty lub mieć nieudaną inspekcję.

Czy Screpy Index Status jest eksperymentalny?

Dashboard obecnie oznacza Index Status jako eksperymentalny. Stany audytu i dostępne informacje pokrycia Google mogą się zmieniać, dlatego przed szeroką zmianą witryny zweryfikuj ważne ustalenia z bieżącą stroną, Search Console i świeżym crawlem.

Czy mogę kontynuować nieukończony audyt Index Status?

Tak. Gdy audyt można kontynuować, użyj Continue Audit, aby wznowić ten sam przegląd zamiast odrzucać dotychczasowy postęp. Dzienny limit kontroli lub przerwane uruchomienie może wymagać powrotu później.

Dlaczego zindeksowana strona może nadal mieć niską widoczność?

Zindeksowanie oznacza, że Google ma wersję strony w indeksie; nie gwarantuje pozycji, wyświetleń, kliknięć ani konkretnego miejsca. Przed kolejnym działaniem sprawdź stronę, jej intencję, warunki techniczne i wydajność wyszukiwania.

Czego wymaga audyt Index Status?

Projekt wymaga połączonej i dostępnej usługi Google Search Console oraz pomyślnego crawla witryny. Nowy audyt automatycznie używa ostatniego pomyślnego crawla. Aktywny może być tylko jeden audyt, a nowy można rozpocząć co 5 godzin.

Czy Index Status wykonuje test URL-a na żywo?

Nie. Audyt sprawdza wersję reprezentowaną w indeksie Google przez połączoną usługę Search Console. Nie testuje bieżącej strony ani nie dowodzi przetworzenia niedawnej zmiany przez Google.

Czy każdy niezindeksowany URL jest problemem SEO?

Nie. Zduplikowane, alternatywne, przekierowane, celowo noindexowane lub niepotrzebne URL-e mogą prawidłowo pozostać poza indeksem Google. Najpierw ustal, czy URL powinien być indeksowany.

Czy Screpy Index Status wysyła żądania indeksowania do Google?

Nie. Index Status raportuje informacje indeksu Google dla audytowanych URL-i. Nie wysyła żądań indeksowania, nie wymusza crawlowania strony przez Google ani nie gwarantuje pojawienia się URL-a w wynikach.