


Przed i po migracji
Zapisz przekierowania, kanoniczne adresy, ścieżki wewnętrzne, ważne szablony i pokrycie crawlu przed uruchomieniem, a następnie porównaj nową witrynę z tą samą bazą.
Zamień crawl całej witryny w spis stron, pogrupowane ustalenia i praktyczną kolejkę poprawek. Przeglądaj crawlowalność, kody statusu, przekierowania, canonicale, metadane, nagłówki, linki, obrazy, czas odpowiedzi, dane strukturalne i sygnały bezpieczeństwa, a następnie wykonaj ponowny crawl, aby potwierdzić zmiany.
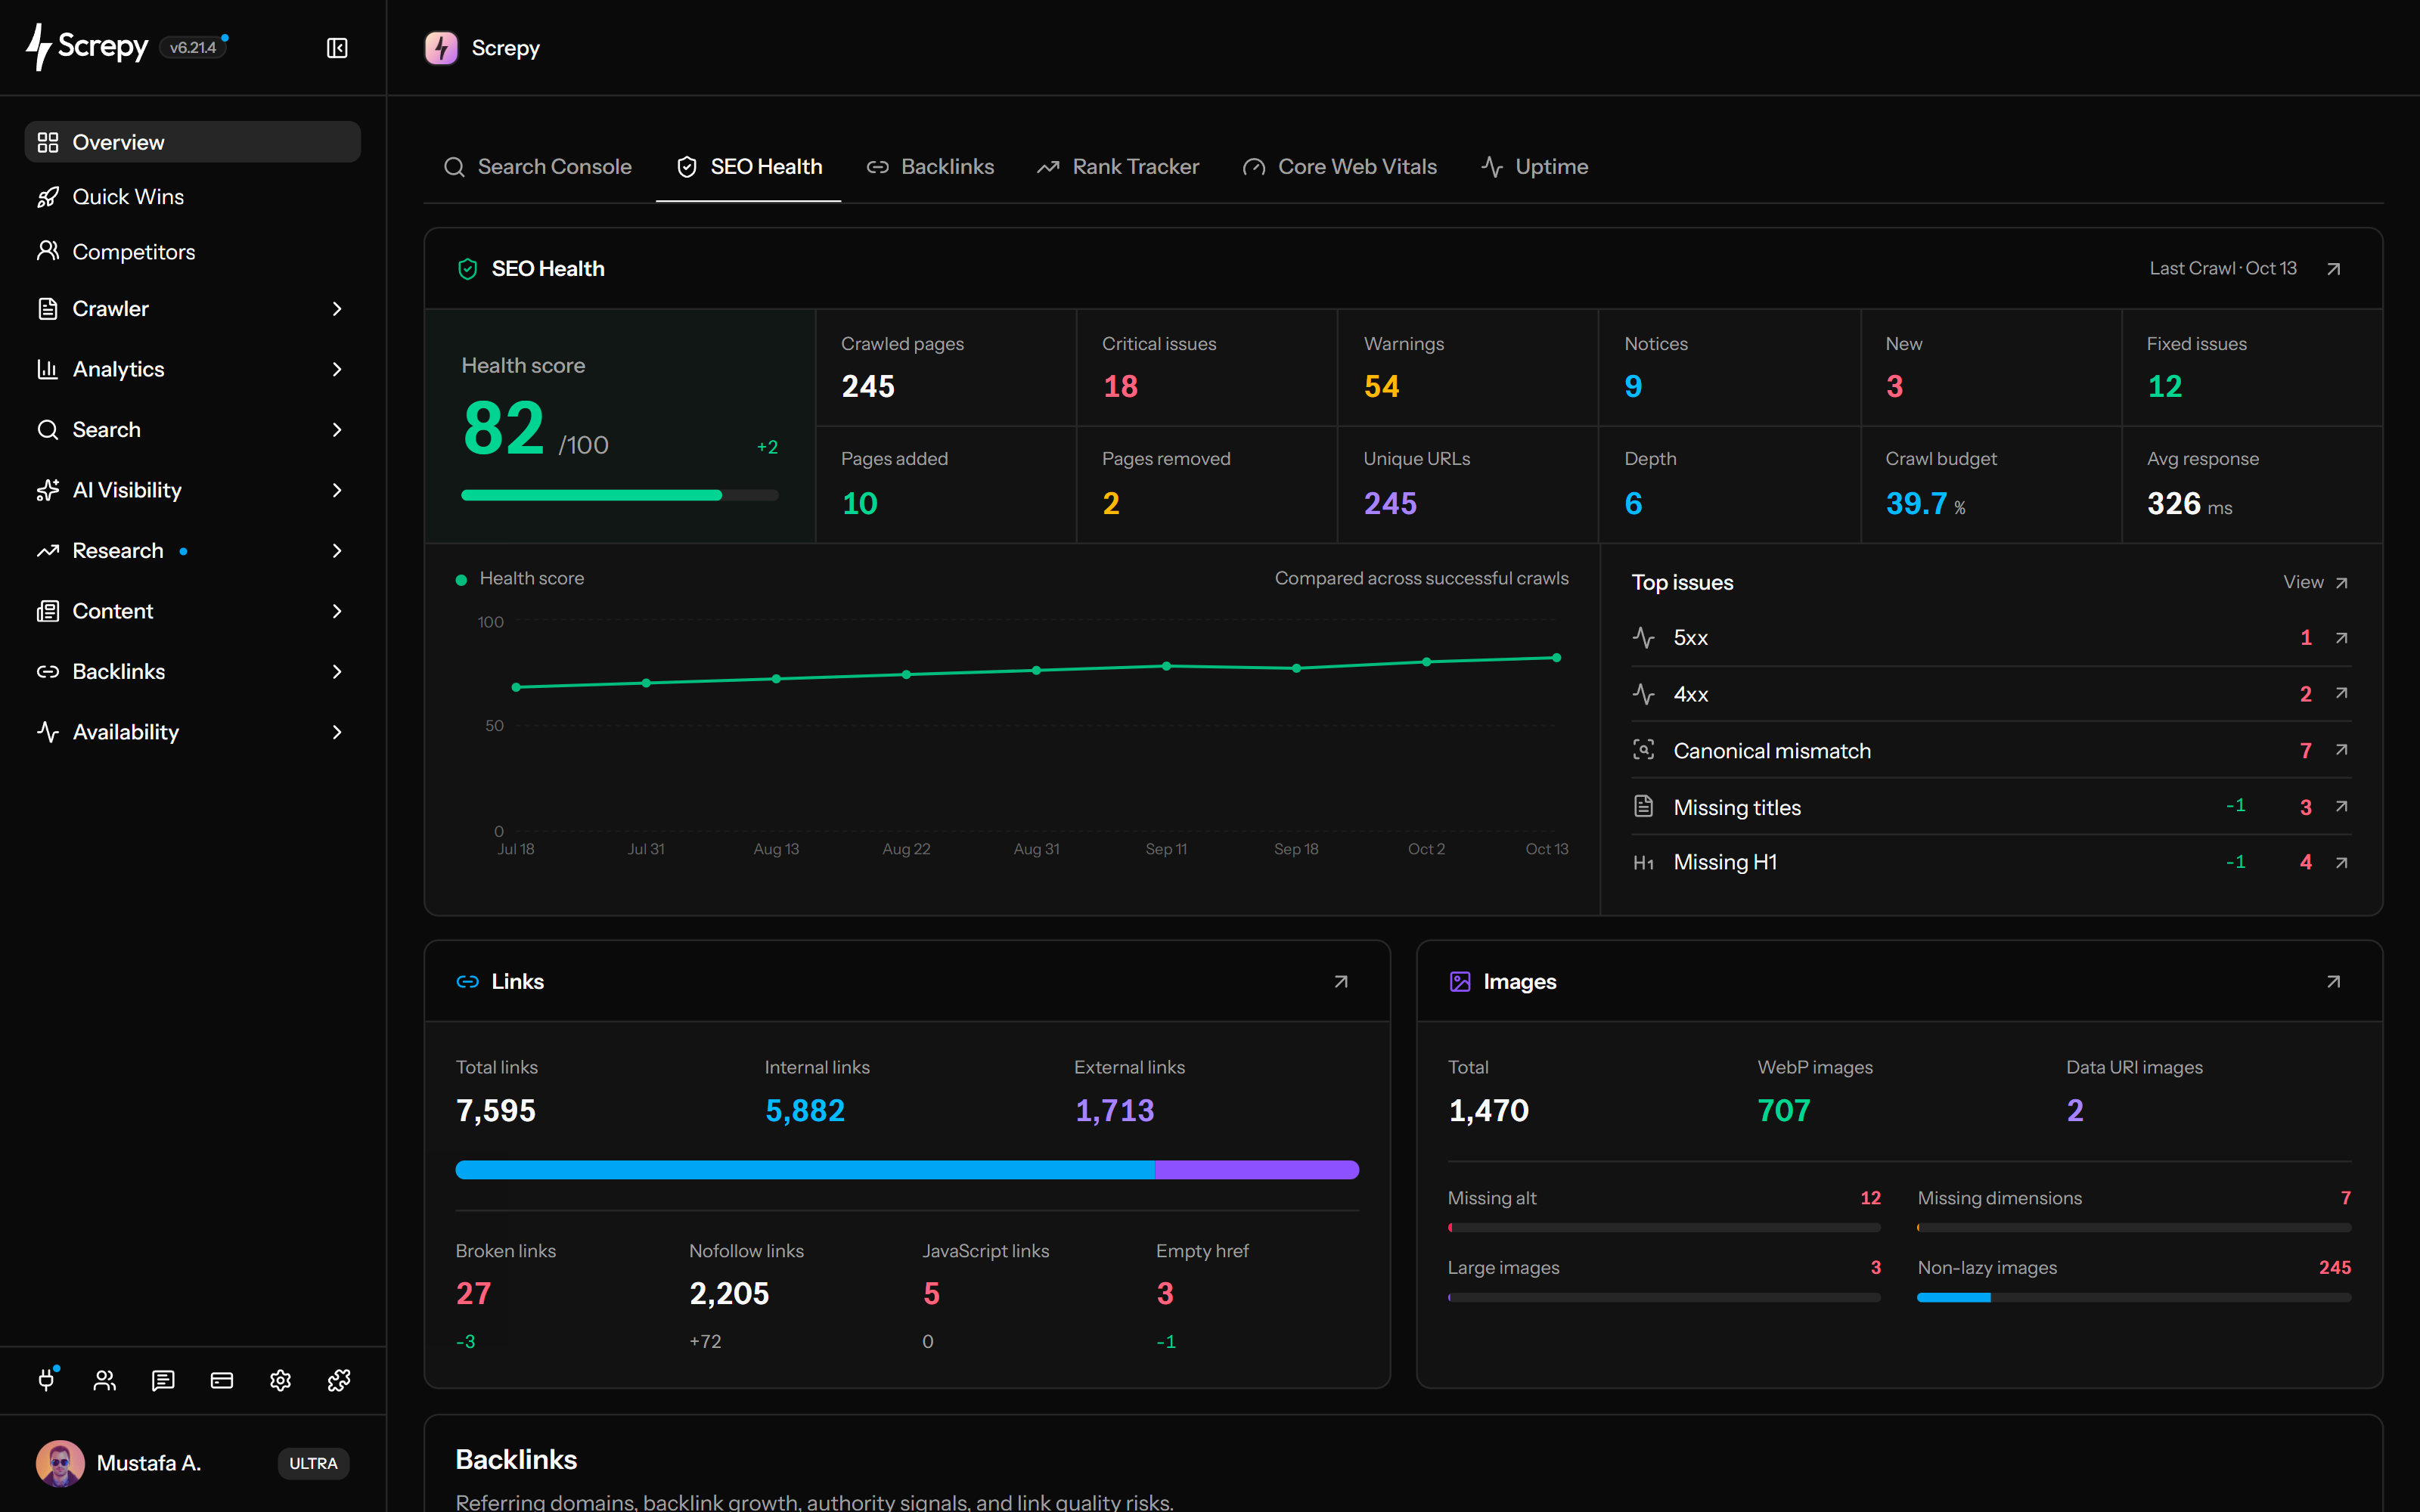


Zacznij od adresów URL, do których muszą docierać wyszukiwarki i użytkownicy. Spis stron pokazuje odpowiedzi, cele przekierowań i głębokość skanowania przy każdym URL, ułatwiając zbadanie niedziałającej ścieżki produktu lub niedostępnego artykułu.
/guides/seo200
Powtarzalne metadane mogą pochodzić ze wspólnego szablonu zamiast z setek oddzielnych błędów redakcyjnych. Filtruj tytuły i opisy, porównuj adresy URL z problemem i zdecyduj, czy poprawić szablon, czy treść strony.
example.com › guides
SEO · TytułOpisZobacz, jak każda zeskanowana strona przedstawia główny temat. Liczby nagłówków i słów oraz udział treści pomagają odróżnić niekompletny artykuł od zwięzłej strony kontaktowej; różne cele stron nie wymagają jednego standardu treści.
TreśćH1
Porównaj cel canonical strony z końcowym adresem osiągniętym podczas skanowania. Jest to szczególnie przydatne po migracji lub gdy filtry i parametry tworzą kilka wersji tej samej treści.
/shop?sort=new
/shop?filter=linen
/shop
Niedziałający cel pokazuje, co jest zepsute; strony źródłowe pokazują, gdzie to naprawić. Spis linków łączy każdy cel z odsyłającymi stronami i tekstami kotwic, w tym powtarzalnymi linkami nawigacji i stopki.
Źródło/guides
/old-pricing404/setup503Przeglądaj adresy obrazów razem ze stronami, które ich używają. Brakujący obraz we wspólnym szablonie produktu może wpływać na wiele URL; tekst alternatywny zależy od tego, co obraz przekazuje na każdej stronie.
Znajduj strony z wykrytym JSON-LD lub microdata oraz strony bez wykrytego schema. Badaj pokrycie według typu treści; wykrycie znaczników nie potwierdza ich poprawności ani kwalifikacji do wyniku rozszerzonego.
ArticleJSON-LD@contextschema.org
@typeArticle
headlinelinen shirt
Sprawdzaj, które zeskanowane strony zwracają typowe ochronne nagłówki odpowiedzi. Filtry brakujących nagłówków pokazują różnice konfiguracji; wybór właściwej polityki nadal wymaga zrozumienia sposobu ładowania treści witryny.
Content-Security-PolicyX-Content-Type-OptionsStrict-Transport-SecurityZachowaj zakończone skanowanie jako punkt odniesienia przed następnym wdrożeniem lub migracją. Porównuj późniejsze snapshoty, sprawdzając zmiany adresów z problemem, a następnie przekaż konkretne przefiltrowane ustalenia deweloperom lub redaktorom.
Połącz asystenta AI z serwerem SEO MCP Screpy. Zapytaj o ostatni ukończony crawl, sprawdź dotknięte problemem strony i ustal kolejność prac nad technicznym SEO.
Użyteczny audyt nie kończy się na liczbie problemów. Zachowaj porównywalność crawlu, zweryfikuj reprezentatywne adresy URL, znajdź wspólną przyczynę i określ, co powinien pokazać kolejny crawl.
Potwierdź początkowy adres URL, maksymalną liczbę adresów, głębokość crawlu, tryb JavaScript, reguły dostępu i wersję witryny. Ukończony crawl staje się datowanym snapshotem, a nie stale zmieniającym się widokiem witryny.
Otwórz jeden zmieniony adres URL i zweryfikuj jego odpowiedź, wyrenderowany wynik, cel, indeksowalność, szablon i wartość biznesową, zanim uznasz filtr za wadę.
Oddziel pojedynczy problem redakcyjny od typu treści CMS, wspólnego komponentu, reguły nawigacji, ścieżki lub konfiguracji całej witryny. Napraw wzorzec zamiast edytować każdy wiersz osobno.
Sprawdź publiczną zmianę, uruchom kolejny crawl z porównywalnymi ustawieniami i potwierdź zmianę odsetka oraz wzorca adresów URL z właściwej przyczyny.
Regresje techniczne często zaczynają się od zwykłych wdrożeń, prac nad treścią, migracji i edycji wspólnych szablonów. Crawl przed i po zmianie daje zespołowi dane, gdy kontekst wdrożenia jest jeszcze świeży.
Zapisz przekierowania, kanoniczne adresy, ścieżki wewnętrzne, ważne szablony i pokrycie crawlu przed uruchomieniem, a następnie porównaj nową witrynę z tą samą bazą.
Sprawdź, czy zmiany wspólnych layoutów, routingu, metadanych, obrazów, skryptów lub bezpieczeństwa wprowadziły powtarzalny problem na wartościowych stronach.
Utrzymuj nowe artykuły, landing pages, kategorie i szablony programatyczne w stanie połączonym, crawlowalnym, wewnętrznie linkowanym i technicznie spójnym.
Używaj danych crawlu obok Search Console, historii wdrożeń, logów serwera i wyrenderowanych stron, aby zbadać zmianę bez zakładania, że jeden sygnał audytu spowodował ruch.
Użyj bezpłatnego sprawdzania dla jednego działającego adresu URL. Wybierz Website Audit, gdy potrzebujesz snapshotu crawlu, analizy powtarzalnych wzorców, kontekstu strony źródłowej, eksportów i weryfikacji w całej witrynie.
Wykonuj crawl wielu adresów URL jako jeden projekt, analizuj inwentarze stron, linków i obrazów oraz weryfikuj poprawki całej witryny w późniejszym snapshocie.
Sprawdź wyrenderowane metadane, nagłówki, linki, obrazy, dane strukturalne, dostępność i sygnały techniczne jednego publicznego adresu URL.
Dokumentacja Screpy
Skorzystaj z przewodnika Screpy, aby przeglądać wyniki audytu, analizować zmienione adresy URL, ustalać priorytety problemów i weryfikować poprawki po nowym crawlu.
Poznaj zakres crawlu, renderowanie JavaScript, brakujące strony, liczbę problemów, priorytetyzację, porównania, raportowanie oraz to, co audyt techniczny może i czego nie może udowodnić.
Wykonuj pełny audyt po dużych zmianach witryny, migracjach, redesignach i aktualizacjach treści. W aktywnych witrynach cykliczne audyty są przydatne, ponieważ nowe problemy techniczne mogą pojawić się po rutynowych wdrożeniach i edycjach.
Najpierw sprawdź, czy adres URL zwraca użyteczny HTML, zezwala na ScrepyBot, jest połączony z crawlowaną stroną, mieści się w wybranej głębokości i limicie adresów oraz nie wpada w pętle przekierowań, uwierzytelnianie, wyzwania botów, timeouty lub błędy serwera.
Tak. Traktuj ukończone crawle jako datowane snapshoty i porównuj je przy równoważnym zakresie oraz ustawieniach. Sprawdzaj, które ustalenia naprawiono, które pozostały, które są nowe oraz czy w obu crawlach uwzględniono te same typy stron i ważne adresy URL.
Tak. Screpy obsługuje raporty i eksporty, dzięki czemu ustalenia audytu, wykonane prace i pozostałe problemy łatwiej komunikować współpracownikom, klientom, deweloperom i interesariuszom.
Tak. Crawl całej witryny ułatwia zauważenie, gdy ten sam problem występuje w szablonach, kategoriach lub grupach adresów URL. Pomaga to naprawić podstawowy wzorzec zamiast analizować każdą stronę osobno.
Kontrola jednej strony sprawdza jeden adres URL w konkretnym momencie. Audyt witryny wykonuje crawl stron jako jednej witryny, znajduje powtarzalne wzorce, porównuje adresy URL i zapewnia zespołowi proces ustalania priorytetów oraz monitorowania poprawek w całej witrynie.
Screpy analizuje dostęp crawlera, kody statusu HTTP, przekierowania, głębokość crawlu, czas odpowiedzi, metadane, nagłówki, kanoniczne adresy, sygnały treści, dane strukturalne, tagi społecznościowe, nagłówki bezpieczeństwa, linki wewnętrzne i zewnętrzne, obrazy oraz powiązane ustalenia techniczne na crawlowanych stronach.
Zacznij od problemów wpływających na crawl, indeksowanie, dostępność lub wiele ważnych stron. Następnie uwzględnij wartość strony, zmienione szablony, ruch z wyszukiwania, wpływ na konwersję i wysiłek potrzebny do naprawy przyczyny.
Screpy udostępnia ustawienie crawlu JavaScript dla witryn, których ważne linki lub treści są tworzone w przeglądarce. Renderowanie JavaScript nie omija reguł robots, uwierzytelniania, ochrony botów, błędów serwera ani zakresu crawlu projektu.
Nowszy crawl może odkryć więcej stron, dotrzeć do wcześniej zablokowanego szablonu lub użyć innych ustawień zakresu. Porównaj liczbę crawlowanych stron, odsetek zmienionych, wzorce adresów URL, konfigurację crawlu i wersję witryny przed oceną poprawy lub pogorszenia kondycji.
Nie. Audyt witryny pomaga analizować stan techniczny i weryfikować zmiany wdrożeniowe, ale nie gwarantuje pozycji ani ruchu. Wyniki wyszukiwania zależą także od trafności, jakości treści, autorytetu, konkurencji, popytu, indeksowania i interpretacji każdej strony przez wyszukiwarki.
Zrozum Super Intelligence i połącz audyty, badania, pozycje oraz widoczność AI w praktycznym procesie Screpy.
Kompleksowy zestaw narzędzi SEO w naprawdę przystępnej cenie.