

Umsatzwebsites
Überwachen Sie Shop, Buchungsseite, Abonnementprodukt oder Lead-Website regelmäßig auf externe Verfügbarkeit.
Prüfen Sie, ob die Projektwebsite erreichbar ist, messen Sie Verfügbarkeit und Antwortzeiten der letzten 30 Tage, untersuchen Sie HTTP-Fehler und Wiederherstellung und benachrichtigen Sie das richtige Postfach, ohne Uptime als Rankingversprechen darzustellen.
Aktivieren Sie regelmäßige Verfügbarkeitsprüfungen für die öffentliche Projekt-URL. Wählen Sie zuerst ein sinnvolles Ziel für Ihre Besucher.
example.com60 s
Erkennen Sie, welcher Anteil der Prüfungen in den letzten 30 Tagen erfolgreich war. Berücksichtigen Sie auch Prüfungsanzahl und letzten Zeitpunkt.
Uptime
93,8 %Erkennen Sie langsamere Antworten und wiederholte Fehler im Verlauf. Eine erreichbare URL kann trotzdem langsam antworten.
Antwortzeit
240 msPrüfen Sie die acht neuesten Ergebnisse mit Status, Zeitpunkt, HTTP-Code und Antwortzeit gegen das erwartete Verhalten Ihrer URL.
HTTP-Status
200GET /HTTP/2 200Verfolgen Sie einen Ausfall vom ersten fehlgeschlagenen bis zu einem späteren erfolgreichen Check. Ursachen erfordern eine separate Untersuchung.
Zeitraum
12 minSenden Sie berechtigte Ausfallmeldungen an Projektmitglieder und eine zusätzliche optionale Adresse. Vorfälle werden bereits vor der E-Mail-Berechtigung erfasst.
Projektexample.com
PrüfungLassen Sie einen verbundenen KI-Assistenten gespeicherte Ergebnisse eines zugänglichen Projekts erklären. Der Zeitstempel unterscheidet vorhandene Daten von einer neuen Prüfung.
/projectsJSON{
"data": [
{ "domain": "example.com" }
]
}Teilen Sie Verfügbarkeitsdaten in einem gespeicherten SEO-Bericht. Ein Berichtsschnappschuss unterscheidet sich vom laufenden Monitoring.
aACMEBerichtPDF
Fragen Sie Ihren KI-Assistenten über SEO MCP nach Screpys verfügbarer Uptime-Zusammenfassung. Verstehen Sie Verfügbarkeit und Antwortzeiten, ohne Monitoring-Daten als Beweis für die Ursache zu behandeln.
Ein Check ist wertvoll, wenn das Ziel öffentlich ist, das Intervall zur Bedeutung der Website passt, Benachrichtigungen ein verantwortliches Postfach erreichen und jeder Vorfall mit bestätigter Wiederherstellung endet.
Wählen Sie ein stabiles öffentliches Ziel, das Besucher und Crawler erreichen müssen. Vermeiden Sie private Admin-Routen oder absichtlich nicht verfügbare Pfade.
Aktivieren Sie Uptime Monitoring in den Projekteinstellungen, verwenden Sie das verfügbare Intervall und ergänzen Sie optional eine Zuständigkeitsadresse.
Vergleichen Sie Status, Uptime, Antwortzeitverlauf, HTTP-Ergebnisse und wiederholte Fehler, statt wegen eines einzelnen Datenpunkts einen Ausfall zu erklären.
Prüfen Sie Deployment, DNS, TLS, Hosting, Firewall und Anwendung außerhalb von Screpy und bestätigen Sie, dass ein späterer erfolgreicher Check den Vorfall löst.
Nutzen Sie wiederkehrende Checks für Projekte, bei denen Verfügbarkeit Verkäufe, Leads, Kampagnen, Kundenzugriff oder das Abrufen öffentlicher Inhalte durch Suchcrawler beeinflusst.
Überwachen Sie Shop, Buchungsseite, Abonnementprodukt oder Lead-Website regelmäßig auf externe Verfügbarkeit.
Beobachten Sie die öffentliche Website, die Suchcrawler und organische Besucher erreichen müssen, bevor Content- oder Rankingarbeit Wirkung zeigt.
Verfolgen Sie die Projektwebsite während Launches, Migrationen, Redesigns und aktiver Kampagnen, wenn ein Verfügbarkeitsproblem sofort mehr kostet.
Prüfen Sie die Uptime jedes Screpy-Projekts getrennt, damit Agenturen und interne Teams Kunden- oder Markenwebsites in einem Workflow verwalten.
Screpy liefert externe HTTP-Nachweise und Vorfallverlauf für die konfigurierte Projektwebsite. Bei weitergehenden Fragen benötigen Sie Infrastruktur, Logs, Transaktionstests und Suchdaten.
Uptime Monitoring prüft die öffentliche Website-URL des Screpy-Projekts. Es ist keine allgemeine Liste unabhängiger Endpunkt-Monitore.
Das Ergebnis beschreibt, ob das öffentliche Ziel antwortete. CPU, Speicher, Container, Datenbanken, private Netzwerke und Serverlogs werden nicht geprüft.
HTTP-Status, Zeit und Vorfallzeitpunkte grenzen die Untersuchung ein, beweisen aber nicht, ob DNS, TLS, Hosting, Deployment, Firewall oder Anwendungscode die Ursache war.
Eine funktionierende öffentliche Seite ist für Besucher und Crawling nötig, aber eine hohe Uptime garantiert keine Indexierung, Rankings, Besucher, Umsätze oder Conversions.
Überwachen Sie Erreichbarkeit über die Zeit, prüfen Sie die gesamte Website bei wiederkehrenden Fehler- oder Crawlingmustern oder untersuchen Sie Seitenleistung nach stabiler Verfügbarkeit.
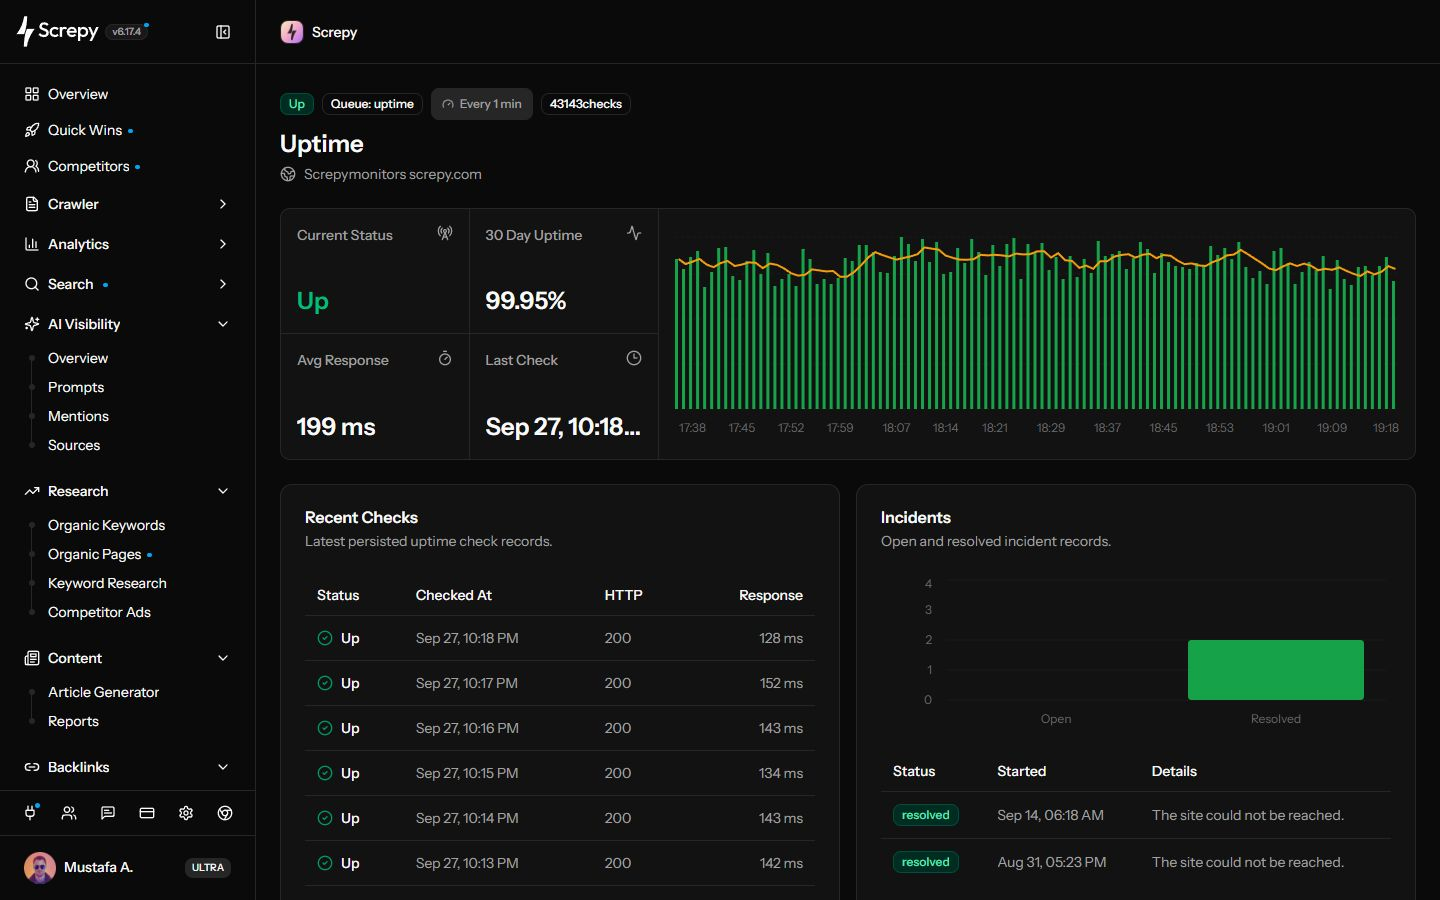
Verfolgen Sie aktuellen Status, 30-Tage-Uptime, Antwortzeitverlauf, letzte HTTP-Checks und Vorfälle der Projektwebsite.
Crawlen Sie die Website, um wiederkehrende Fehlerseiten, Weiterleitungsprobleme, defekte Ziele und technische Muster rund um eine Verfügbarkeitsstörung zu finden.
Führen Sie wiederkehrende Laborprüfungen aus, wenn die Website erreichbar ist, aber Ladezeit oder Reaktionsfähigkeit noch untersucht werden müssen.
Screpy-Dokumentation
Folgen Sie dem Screpy-Leitfaden: Wählen Sie eine sinnvolle öffentliche Projekt-URL, konfigurieren Sie tarifabhängiges Intervall und Benachrichtigungsadresse, interpretieren Sie die 30-Tage-Nachweise und bestätigen Sie die Wiederherstellung.
Verstehen Sie Ziel-URL, HTTP-Statuslogik, Prüfintervall, 30-Tage-Verlauf, Antwortzeiten, Vorfallwiederherstellung, Benachrichtigungsumfang und den Unterschied zwischen Uptime- und vollständigem Infrastrukturmonitoring.
Screpy kann Projektmitglieder und eine optionale Projektadresse über unterstützte Ausfallereignisse per E-Mail benachrichtigen. Nach einem benachrichtigten Vorfall kann eine Wiederherstellungsnachricht folgen. Die Vorfallliste ist maßgeblich, da nicht jeder Fehler eine E-Mail auslöst.
Screpy verwendet das für das Projekt konfigurierte Intervall. Voreinstellungen und Zugriff hängen vom Tarif ab; berechtigte Tarife können Intervalle bis zu einer Minute nutzen. Das Dashboard zeigt den letzten Check zur direkten Einschätzung der Aktualität.
Eine abgeschlossene HTTP-Antwort im Bereich 200 oder 300 gilt als verfügbar. Andere HTTP-Antworten gelten als nicht verfügbar; Zeitüberschreitungen und andere Anfragefehler werden separat als Timeout oder Fehler erfasst.
Nein. Screpy prüft die konfigurierte öffentliche Projektwebsite von außen. Private Infrastruktur wird nicht untersucht und mehrstufige Abläufe wie Login, Suche, Formular oder Checkout werden nicht getestet.
Screpy prüft die für ein Projekt konfigurierte öffentliche Website-URL und erfasst Verfügbarkeitsstatus, HTTP-Antwortcode, Antwortzeit, Prüfzeitpunkt und sicheren Fehlerstatus. Das Dashboard fasst die letzten 30 Tage mit Uptime, durchschnittlicher Antwortzeit, letzten Checks, Statusverteilung und Vorfällen zusammen.
Ja. Die Uptime-Ansicht zeigt aktuelle Antwortzeiten als Diagramm und den 30-Tage-Durchschnitt erfolgreicher Checks. Antwortzeit ist ein betrieblicher Hinweis, nicht dasselbe wie vollständige Seitenladezeit oder echte Nutzererfahrung.
Ein fehlgeschlagener Check eröffnet oder aktualisiert den aktuellen Vorfall. Wenn ein späterer Check erfolgreich ist, löst Screpy den offenen Vorfall und speichert die Wiederherstellungszeit.
Verfügbarkeitsprobleme können Crawler am Abrufen einer Seite hindern; wiederholte Serverfehler oder Timeouts können Crawling reduzieren. Uptime Monitoring liefert Untersuchungsnachweise, garantiert aber nicht, wann eine Suchmaschine eine URL crawlt, indexiert oder rankt.
Entdecken Sie Audits, Rankings, KI-Sichtbarkeit und Monitoring in Screpy — mit klaren Tariflimits.