


Sites de receita
Mantenha loja, site de reservas, produto por assinatura ou site de geração de leads sob verificações externas recorrentes.
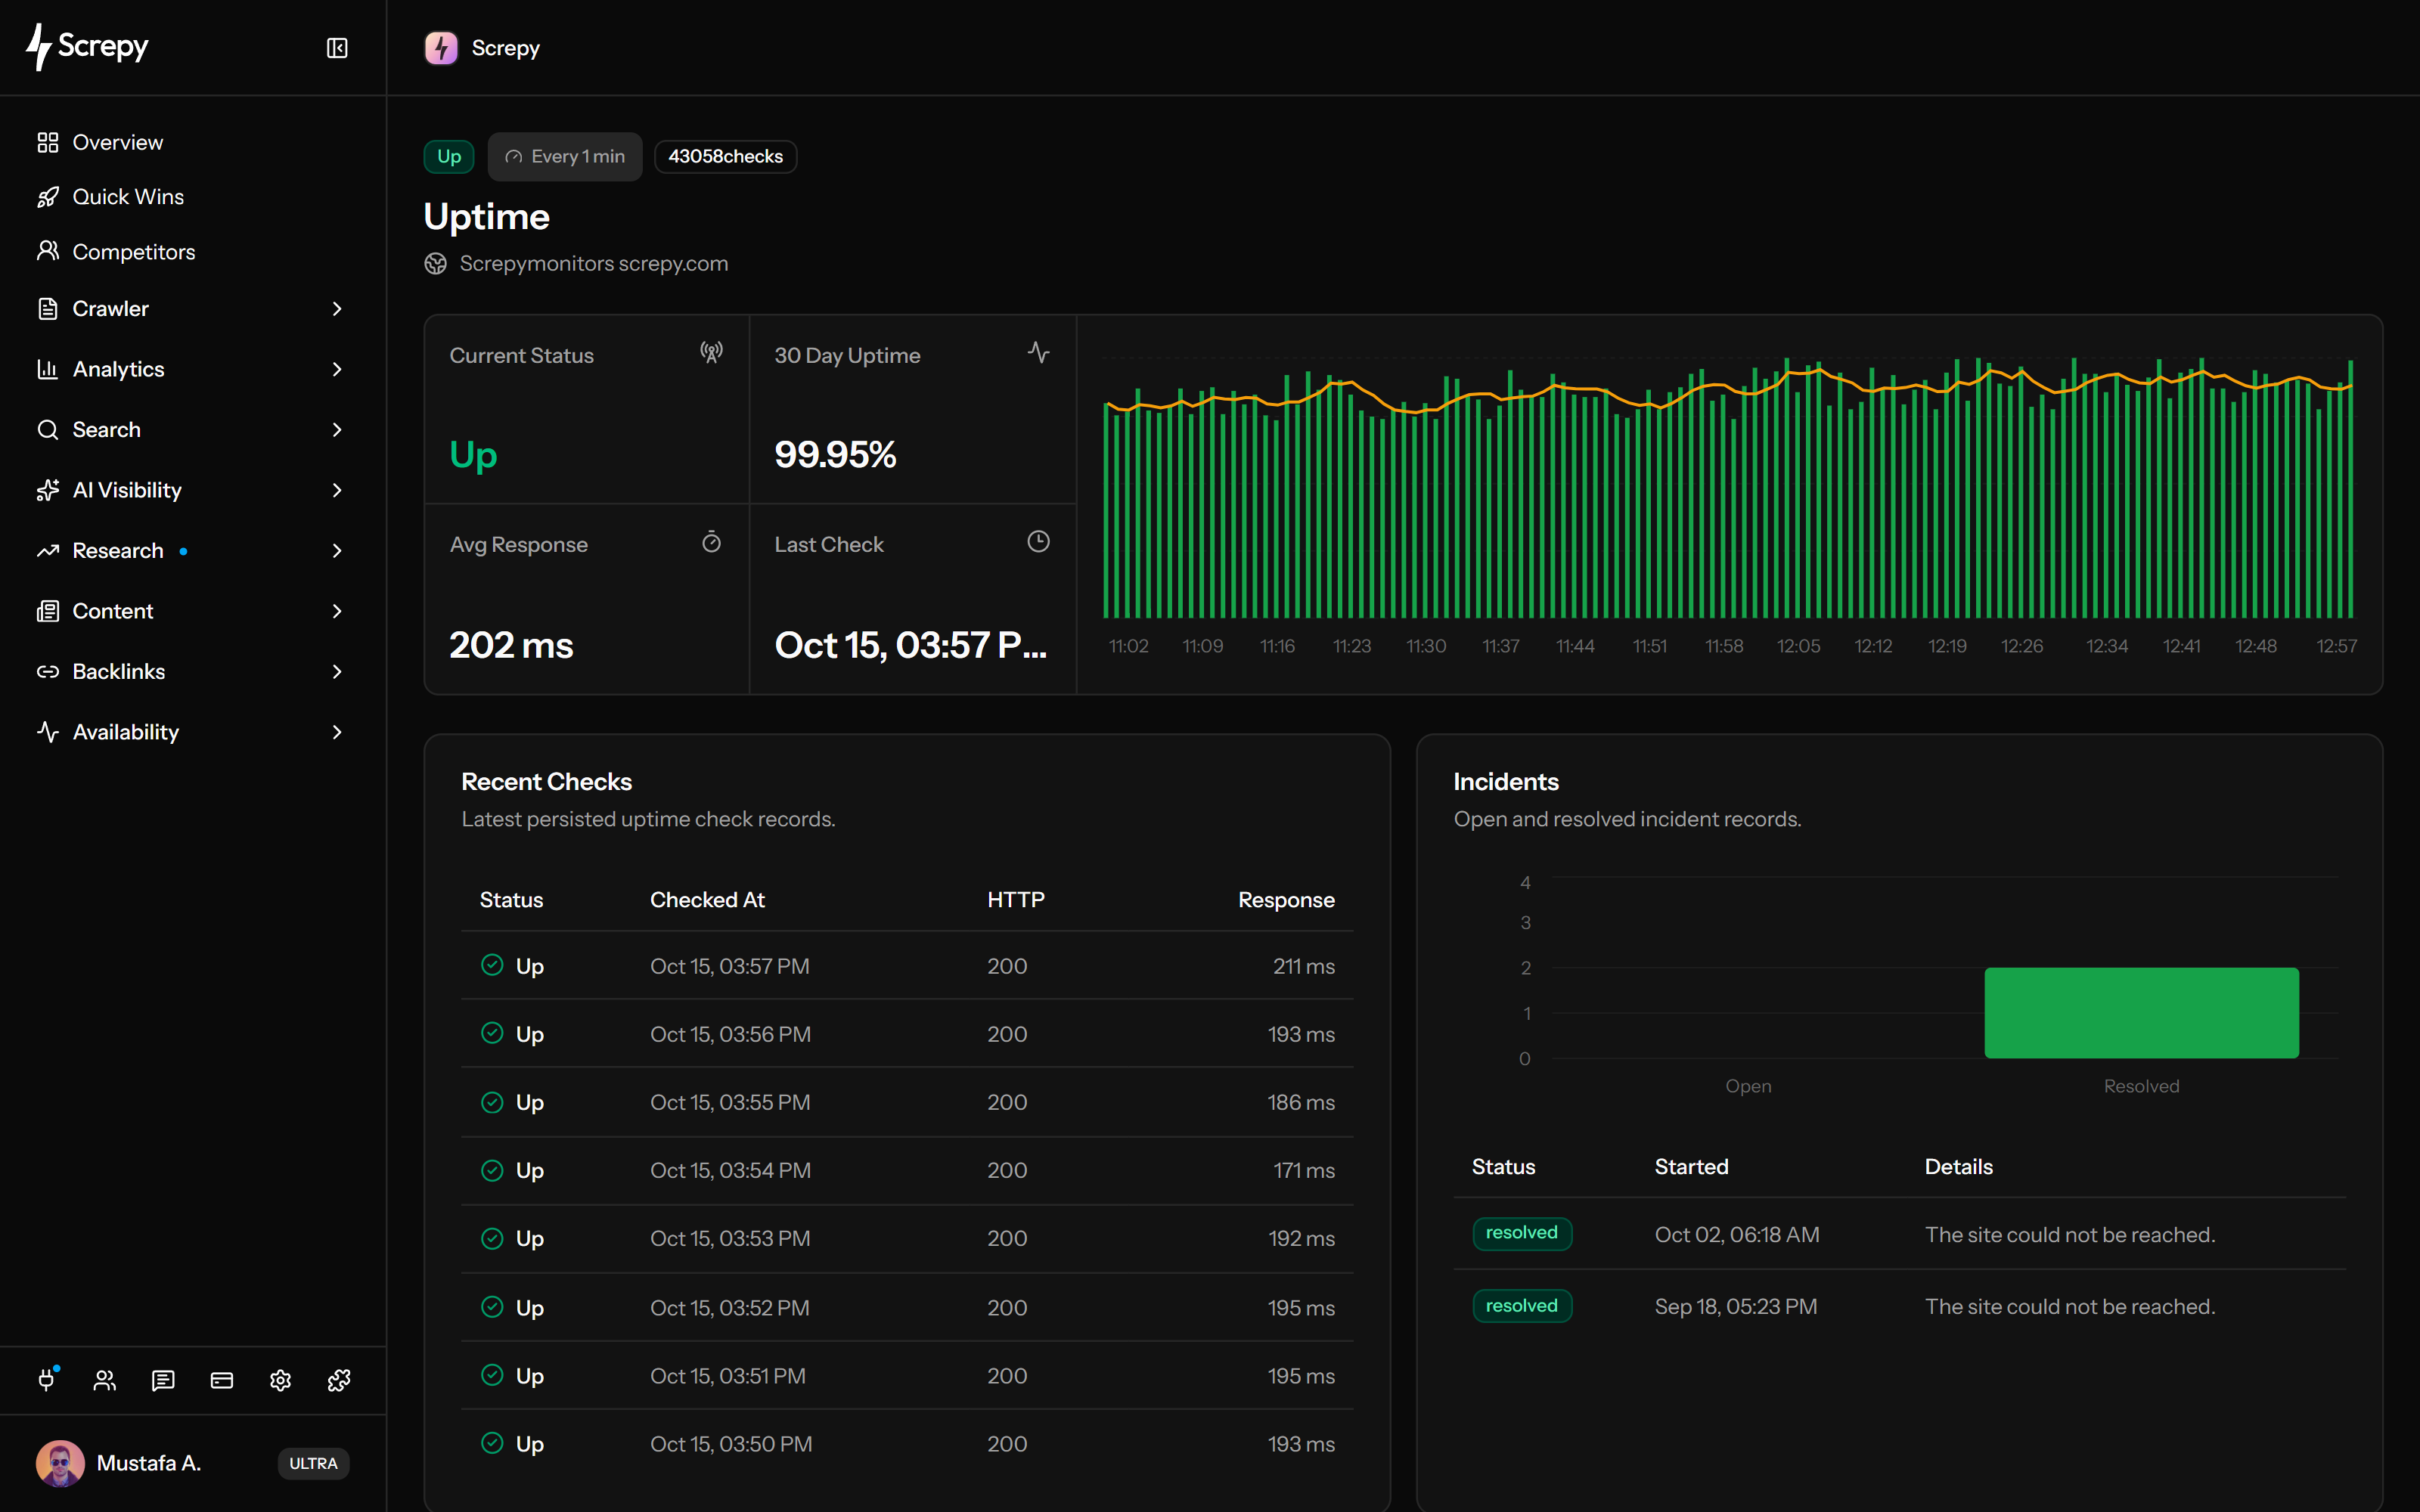
Monitore a URL pública do projeto, revise disponibilidade e respostas de 30 dias e investigue verificações HTTP com falha. Mantenha histórico de incidentes e emails elegíveis junto ao trabalho SEO.


Ative verificações recorrentes da URL pública salva no projeto Screpy. Escolha um destino útil para visitantes antes de definir a frequência.
example.com60 s
Veja a proporção de verificações bem-sucedidas nos últimos 30 dias. Leia a porcentagem junto com a quantidade e a última data.
Disponibilidade
93,8%Identifique respostas lentas e falhas repetidas no gráfico. Uma URL acessível também pode responder lentamente.
Tempo de resposta
240 msVeja as oito últimas verificações com status, data, código HTTP e resposta. Compare com o comportamento esperado da URL pública.
Estado HTTP
200GET /HTTP/2 200Acompanhe o incidente da primeira falha até uma verificação posterior bem-sucedida. Investigue a causa separadamente.
Período
12 minEnvie avisos elegíveis aos membros e a um endereço adicional opcional. O registro do incidente começa antes de se tornar elegível para email.
Projetoexample.com
RevisãoPeça a um assistente conectado que explique resultados salvos de um projeto acessível. Use a data para distinguir registros de uma nova verificação.
/projectsJSON{
"data": [
{ "domain": "example.com" }
]
}Compartilhe dados de disponibilidade em um relatório salvo para cliente ou equipe. Um retrato do período difere do monitoramento ao vivo.
aACMERelatórioPDF
Leia pelo SEO MCP o uptime salvo de 30 dias e registros recentes de status e resposta. Confira a data antes de considerar o último status atual; não inclui incidentes ou códigos HTTP.
Escolha um destino público, ative o monitoramento e configure um email responsável. Diante de falhas, investigue os registros atuais e confirme uma verificação posterior bem-sucedida.
Use a URL pública prevista, sem login obrigatório. Verifique destinos separadamente: essas verificações não seguem redirecionamentos.
Ative o monitoramento nas configurações, salve intervalo e email opcional; confirme acesso pago elegível e verificações recentes.
Leia status, última verificação, resultados HTTP e detalhes. Investigue falhas críticas agora; a porcentagem de 30 dias dá contexto, não motivo para esperar.
Compare a falha com registros de publicação, DNS, TLS, hospedagem e aplicação. Confirme uma verificação bem-sucedida; resolver o incidente não valida todas as jornadas.
Use verificações recorrentes para projetos cuja disponibilidade afeta vendas, leads, campanhas, acesso dos clientes ou a recuperação de conteúdo público pelos crawlers.
Mantenha loja, site de reservas, produto por assinatura ou site de geração de leads sob verificações externas recorrentes.
Acompanhe o site público que crawlers e visitantes orgânicos precisam alcançar antes que conteúdo ou ranking possam fazer diferença.
Monitore o site durante lançamentos, migrações, redesigns e campanhas ativas, quando um problema de disponibilidade tem custo imediato.
Analise o uptime separadamente para cada projeto Screpy e mantenha sites de clientes ou marcas no mesmo fluxo.
O Screpy fornece evidências HTTP externas e histórico de incidentes para o site configurado. Use infraestrutura, logs, testes de transação e dados de busca quando a pergunta ultrapassar esse escopo.
O Uptime Monitoring verifica a URL pública configurada para o projeto Screpy; não é uma lista geral de monitores de endpoints independentes.
O resultado descreve se o destino público respondeu. Não inspeciona CPU, memória, containers, bancos de dados, redes privadas ou logs do servidor.
Status HTTP, tempos e horários restringem a investigação, mas não comprovam se DNS, TLS, hospedagem, deploy, firewall ou código causou o problema.
Uma página pública funcionando é necessária para visitantes e crawling, mas uptime alto não garante indexação, rankings, tráfego, receita ou conversões.
Monitore a acessibilidade ao longo do tempo, audite o site quando falhas ou padrões de crawling se repetirem ou analise o desempenho depois que a disponibilidade estiver estável.
Revise uptime de 30 dias baseado em verificações, respostas, resultados HTTP e incidentes da URL pública.
Rastreie o site para encontrar páginas com falha, problemas de redirecionamento, destinos quebrados e padrões técnicos ligados à indisponibilidade.
Execute verificações de desempenho em laboratório quando o site estiver acessível, mas carregamento ou responsividade ainda precisarem de investigação.
Documentação do Screpy
Aprenda a escolher um destino público, configurar monitoramento e avisos, interpretar respostas e investigar incidentes.
Respostas sobre amostras, projetos inativos, redirecionamentos, verificações ausentes, emails elegíveis e desempenho das páginas.
O Screpy registra status, código HTTP quando disponível, resposta e data de uma URL pública. O painel usa verificações de 30 dias para porcentagem e médias, mostra oito verificações recentes e, separadamente, totais históricos e cinco últimos incidentes.
As configurações aceitam 1–60 minutos com acesso pago. Dentro de um dia da atividade da equipe, usa-se esse intervalo. Depois, no mínimo 10 minutos; após sete dias, no mínimo 60. Após 30 dias inativos, as verificações programadas param. Consulte sempre a última data real.
Erros persistentes do servidor podem reduzir o rastreamento e impedir a obtenção do conteúdo. Um resultado disponível não comprova acesso do Googlebot, destino de redirect, indexação ou posições. Investigue também com dados de rastreamento e pesquisa.
A primeira falha abre um incidente, as seguintes o mantêm aberto e uma verificação bem-sucedida o resolve. O painel mostra status, início e detalhes; emails elegíveis de recuperação incluem duração registrada. Amostras não determinam início exato nem detectam toda queda breve.
Uma falha posterior em incidente aberto pode gerar email para 404, 410, 500, 501, 502, 503, 504, 505, 507, 508, 525 ou 526. Membros e email adicional distinto recebem avisos elegíveis. Queda e recuperação têm limites separados de um email por projeto a cada 24 horas. Um incidente suprimido não é notificado depois; recuperação exige aviso anterior de queda não suprimido. Tempos esgotados, erros sem código e outros códigos não são elegíveis.
HTTP 200–399 é disponível; outras respostas HTTP são indisponíveis. Tempo esgotado e erro são estados separados. Redirecionamentos não são seguidos e o conteúdo não é validado: um redirect ou página de erro HTTP 200 pode contar como disponível sem confirmar a página esperada.
Sim. O gráfico carrega até 160 respostas recentes de 30 dias, com menos pontos visíveis em telas menores. A tendência de cinco verificações difere da média dos sucessos de 30 dias. A resposta HTTP não mede renderização ou interações.
Não. O Screpy verifica um destino HTTP(S) público. Não inspeciona infraestrutura privada, executa login ou compras, valida conteúdo, comprova disponibilidade geográfica nem diagnostica causas. Use registros e verificações específicas.
Um conjunto completo de ferramentas de SEO a um preço realmente acessível.