


Migraciones y cambios de URL
Registra URL importantes, redirecciones, destinos, canónicas y rutas antes del lanzamiento y rastrea la nueva estructura con el mismo alcance.
Ejecuta un rastreo en la nube y mapea el sitio desde sus enlaces internos en lugar de comprobar URL una a una. Configura capacidad, profundidad, renderizado JavaScript, concurrencia y retraso; después inspecciona los registros exactos de Páginas, Enlaces e Imágenes detrás de cada patrón técnico.
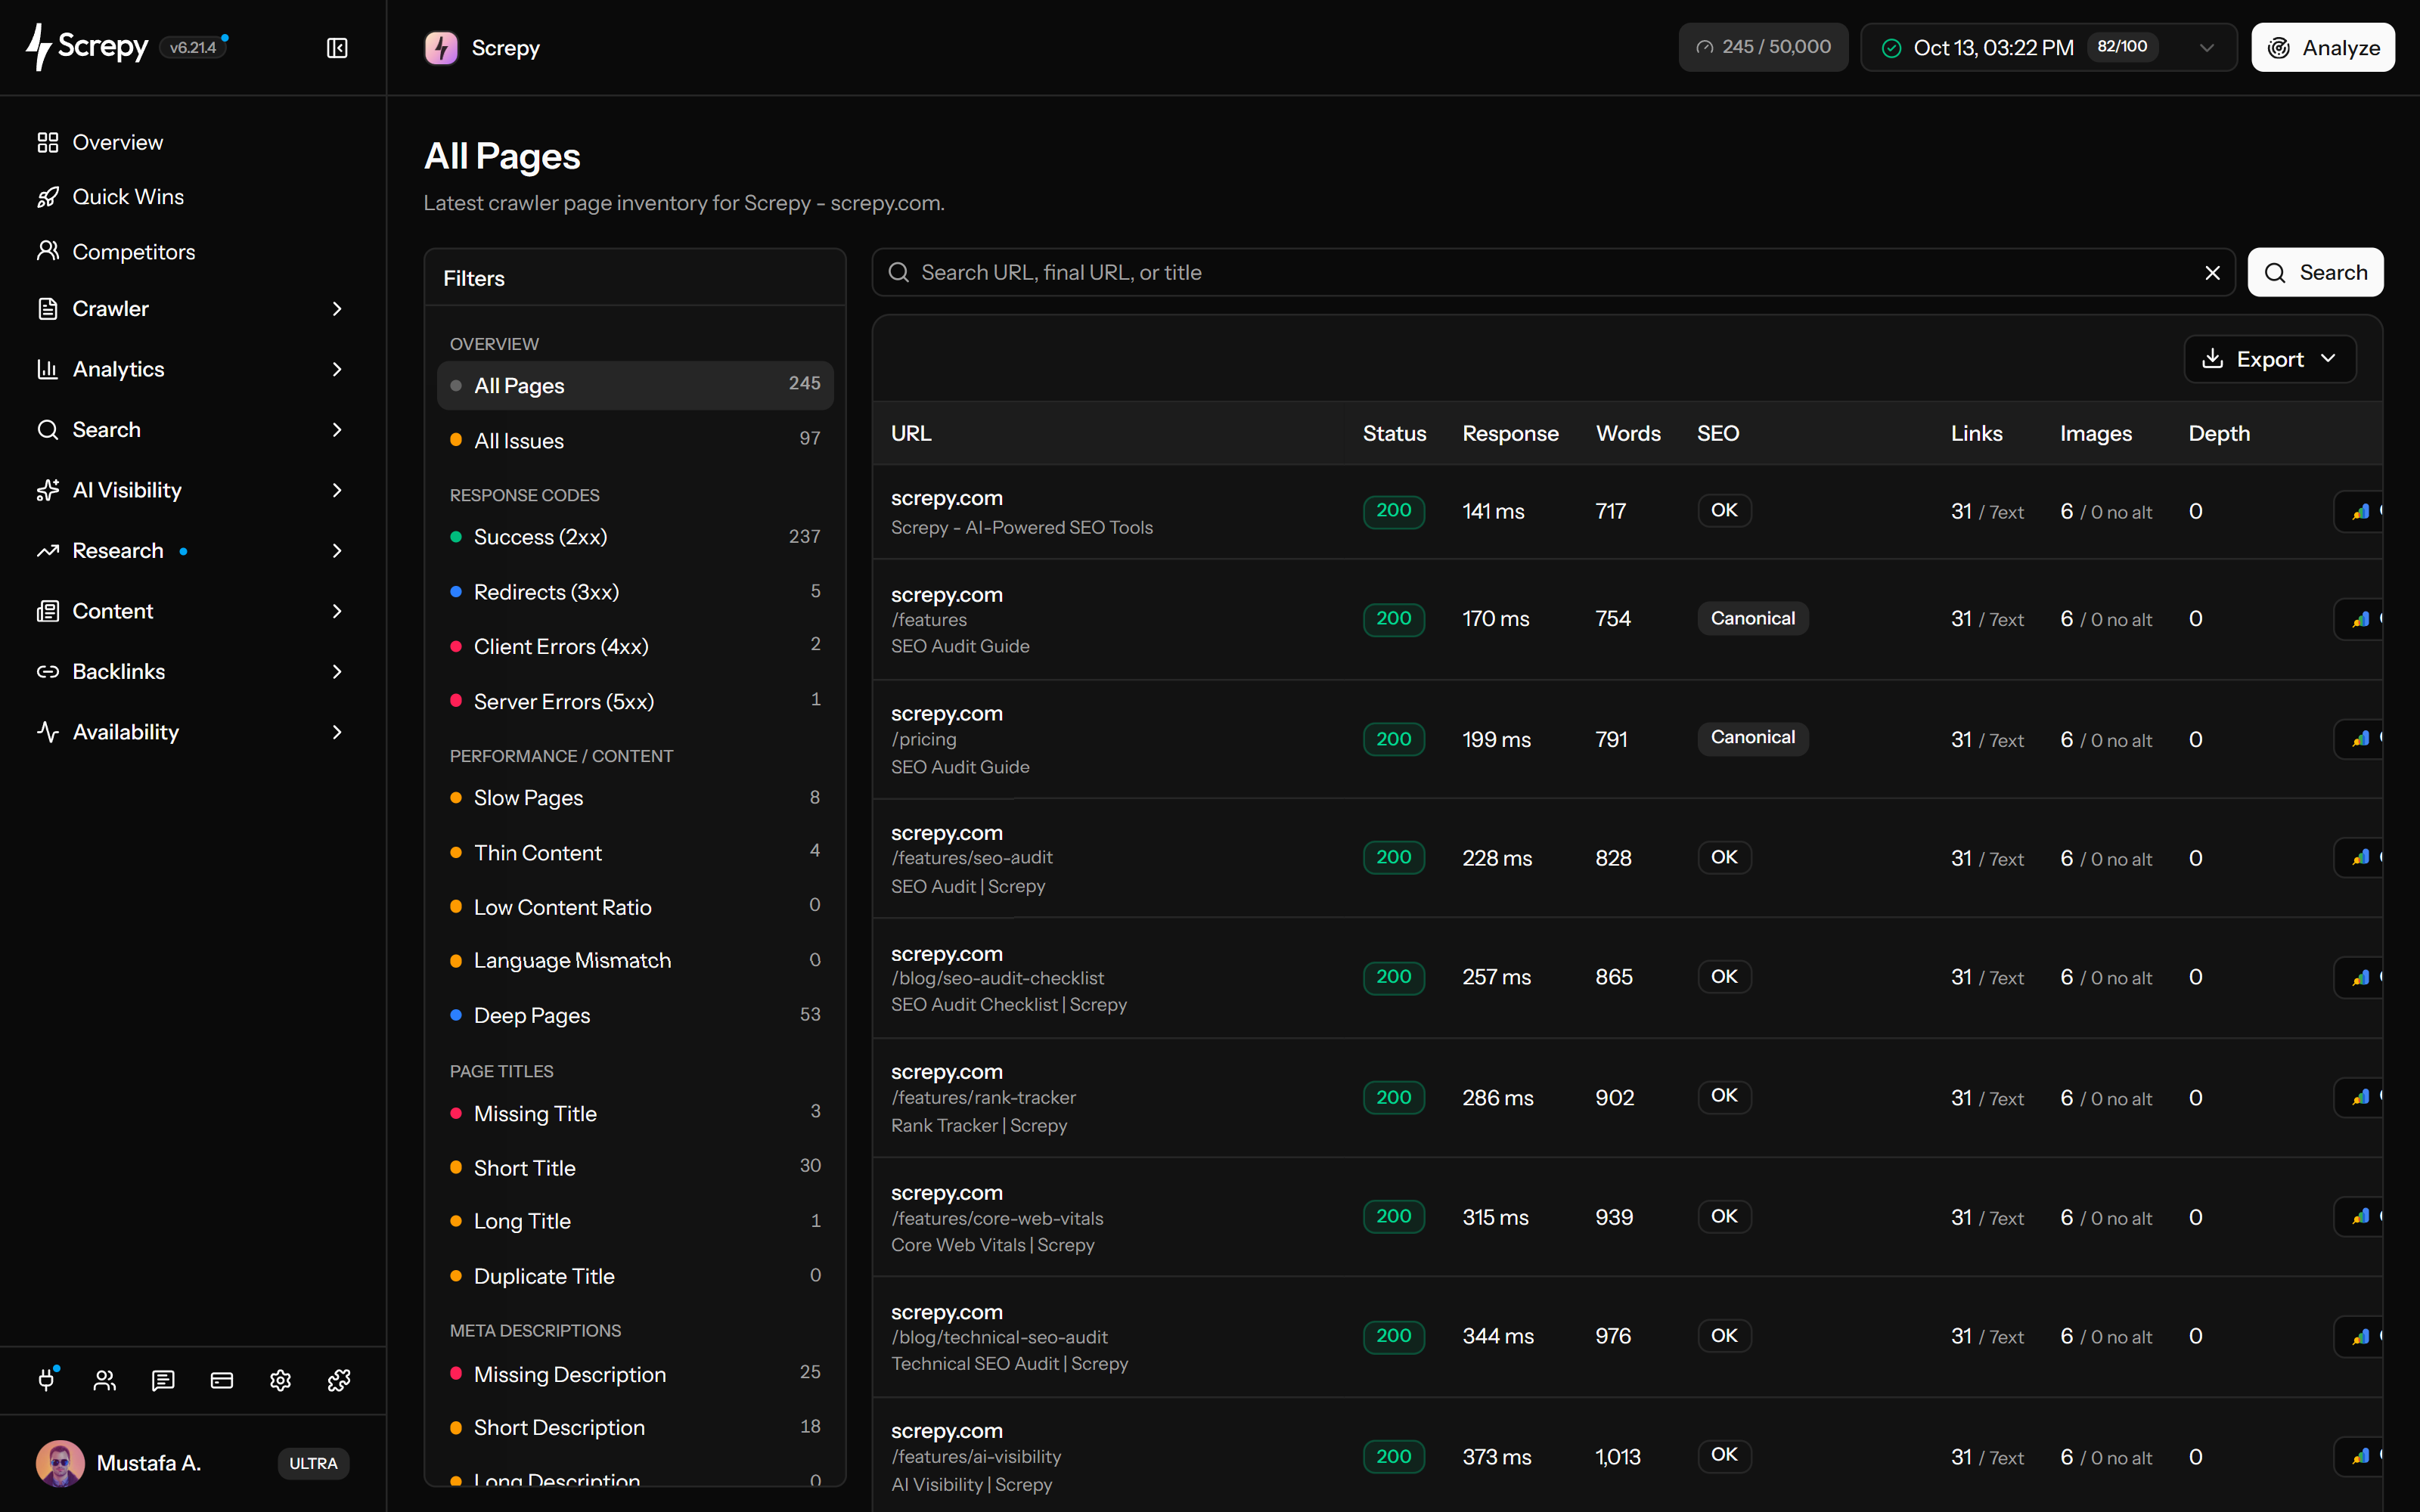


Screpy empieza en el sitio de tu proyecto y sigue los enlaces internos accesibles en la nube. El primer rastreo comienza durante la configuración; después usa Analizar en Páginas, Enlaces o Imágenes para crear un inventario nuevo.
La navegación del lado del cliente puede ocultar enlaces importantes al rastreo del HTML inicial. Activa JavaScript cuando los scripts generen contenido significativo o navegación; déjalo desactivado si el servidor ya devuelve el HTML necesario.
<main id="app">
  <script />
</main>El alcance del descubrimiento y el ritmo de solicitudes resuelven problemas diferentes. La profundidad determina los niveles de enlaces internos seguidos; la concurrencia y el retraso controlan la carga del servidor. Más profundidad no descubre una página sin enlaces.
example.com3
//shop//shop/linen/Entiende cómo una categoría, producto o artículo se conecta con el sitio mediante las URL y enlaces registrados. Usa relaciones con páginas de origen para investigar contenido profundo, navegación obsoleta y rutas que llevan al visitante por redirecciones.
Crea un archivo de implementación con los registros que tu equipo necesita. Filtra el rastreo seleccionado antes de exportar, en lugar de entregar todo el sitio cuando la tarea afecta a una plantilla, estado de respuesta o patrón de archivos.
Un rastreo completo registra el sitio tal como se alcanzó en ese momento. Tras cambiar la navegación o migrar, ejecuta otro para comprobar descubrimiento y destinos; los registros antiguos no se actualizan automáticamente al cambiar el sitio activo.
Conecta tu asistente de IA al servidor SEO MCP de Screpy. Pregunta por el último rastreo completado, revisa las páginas afectadas y prioriza los hallazgos de SEO técnico.
Mantén visible el alcance, inspecciona registros detrás de un patrón, corrige la implementación y usa el siguiente rastreo para confirmar el resultado.
Confirma URL inicial, capacidad, profundidad, modo JavaScript, concurrencia, retraso, robots y acceso. Estas opciones determinan qué representa la instantánea.
Screpy sigue rutas internas accesibles y registra cada URL, respuesta, profundidad, destino, relación y datos de página o imagen dentro del alcance.
Usa informes de Páginas, Enlaces e Imágenes para pasar del total a URL representativas, redirecciones, canónicas, metadatos o usos antes de elegir una corrección.
Ejecuta otro rastreo tras cambiar el sitio. Mantén alcance y ajustes comparables y verifica que las URL y el patrón cambiaron por la razón correcta.
Los datos sirven más cuando el equipo sabe qué cambió. Crea una base antes de trabajos de riesgo y una instantánea comparable después del lanzamiento.
Registra URL importantes, redirecciones, destinos, canónicas y rutas antes del lanzamiento y rastrea la nueva estructura con el mismo alcance.
Usa renderizado cuando navegación o contenido se cree en el navegador y confirma que esas URL aparecen en el inventario.
Revisa profundidad, páginas de origen, anclas, atributos y rutas repetidas para encontrar contenido débilmente conectado.
Vuelve a rastrear tras cambios de rutas, navegación, CMS, plantillas o componentes para detectar regresiones repetidas.
Compara Screpy con Screaming Frog cuando el modelo de despliegue, controles de rastreo, extracción, monitorización, acceso de equipo e informes influyan en la decisión.
Usa el Rastreador SEO para mapear rutas y revisar registros de Páginas, Enlaces e Imágenes. Usa Auditoría del sitio para hallazgos agrupados, prioridades y flujo de salud técnico.
Configura un rastreo en la nube, mapea URL accesibles e inspecciona registros técnicos sin agrupar.
Convierte un rastreo en hallazgos agrupados, patrones, prioridades, exportaciones y verificación repetible.
Las plantillas compartidas y conjuntos de URL cambiantes crean riesgos distintos para sitios SaaS y catálogos de comercio electrónico.
Revisa páginas de destino, documentación, plantillas y regresiones como una superficie de adquisición.
Audita tipos de páginas de categoría y producto, rutas rotas y cambios estructurales del catálogo.
Documentación de Screpy
Usa las guías de Screpy para configurar alcance, permitir acceso, interpretar Páginas, Enlaces e Imágenes y diagnosticar resultados incompletos.
Comprende descubrimiento, alcance, JavaScript, acceso, ritmo, informes, instantáneas y diferencia frente a una auditoría.
Sí. Cada rastreo completo es una instantánea fechada. Ejecuta otro tras un lanzamiento y compara con alcance y ajustes equivalentes para no confundir cobertura con configuración distinta.
Comienza en el sitio del proyecto y sigue enlaces internos accesibles dentro de capacidad y profundidad. Una página puede faltar si no está enlazada, supera la profundidad, está bloqueada, redirige fuera del host, depende de JavaScript o devuelve contenido inutilizable.
Sí, ofrece un ajuste JavaScript opcional. El renderizado ayuda a descubrir contenido creado en el navegador, pero no evita robots, autenticación, firewalls, desafíos, tiempos de espera ni el alcance configurado.
El Rastreador crea el inventario técnico de URL, respuestas, rutas, páginas, enlaces, imágenes y contexto. Auditoría interpreta ese inventario como hallazgos agrupados, prioridades y flujo de verificación. Usa Rastreador para registros brutos y Auditoría para revisión priorizada.
Sí. El informe de Enlaces identifica destinos fallidos o redirigidos y los devuelve a páginas rastreadas. Así se corrige la página de origen, componente o plantilla, no solo la URL destino.
Responden preguntas distintas. Search Console informa rendimiento y cierta indexación; el rastreador sigue enlaces internos y crea un inventario técnico antes de que Google informe un problema.
Empieza en una URL, sigue enlaces internos accesibles dentro de un alcance y registra información técnica de páginas y recursos. El inventario ayuda a investigar rutas, estados, redirecciones, canónicas, enlaces, metadatos, imágenes y patrones repetidos.
Sí. La concurrencia controla cuántas solicitudes se ejecutan a la vez. El retraso está disponible con concurrencia 1; con concurrencia mayor, el retraso guardado es cero. Reduce la presión de solicitudes si tu servidor limita el tráfico automatizado y verifica que el siguiente rastreo reciba respuestas de las páginas reales.
Debe recibir la página real sin inicio de sesión, CAPTCHA, desafío, bloqueo o rechazo por límite. Permite ScrepyBot y sus IP documentadas, confirma robots.txt y verifica que la respuesta contenga el HTML real.
URL máximas limita cuántas URL puede guardar el rastreo. Profundidad limita niveles de enlaces desde la página inicial. Aumentarlas no corrige bloqueos, enlaces ausentes, redirecciones, límites ni respuestas inutilizables.
Páginas registra URL, respuesta, profundidad, metadatos, encabezados, canónica, indexabilidad, contenido, datos estructurados y señales sociales. Enlaces conecta destinos con estado, anclas, atributos, usos y páginas. Imágenes agrupa fuentes con respuesta, alt, dimensiones, entrega y uso.
No. Los datos ayudan a descubrir condiciones técnicas, pero también influyen relevancia, calidad, autoridad, competencia, demanda e indexación. Trata los filtros como evidencia para investigar, no instrucciones automáticas.
Comprende Super Intelligence y conecta auditorías, investigación de búsqueda, posiciones y visibilidad en IA en un flujo práctico de Screpy.