

वेबसाइट माइग्रेशन और URL में बदलाव
लॉन्च से पहले महत्वपूर्ण URL, रीडायरेक्ट, अंतिम गंतव्य, कैनोनिकल और आंतरिक पाथ दर्ज करें। फिर उसी दायरे में नई संरचना क्रॉल करें।
URL एक-एक करके जाँचने के बजाय क्लाउड क्रॉल चलाएँ और आंतरिक लिंक से वेबसाइट की संरचना समझें। क्रॉल क्षमता, गहराई, JavaScript रेंडरिंग, एक साथ चलने वाले अनुरोधों की संख्या और अनुरोधों के बीच अंतराल निर्धारित करें। फिर हर तकनीकी पैटर्न के पीछे मौजूद Pages, Links और Images के वास्तविक रिकॉर्ड देखें।
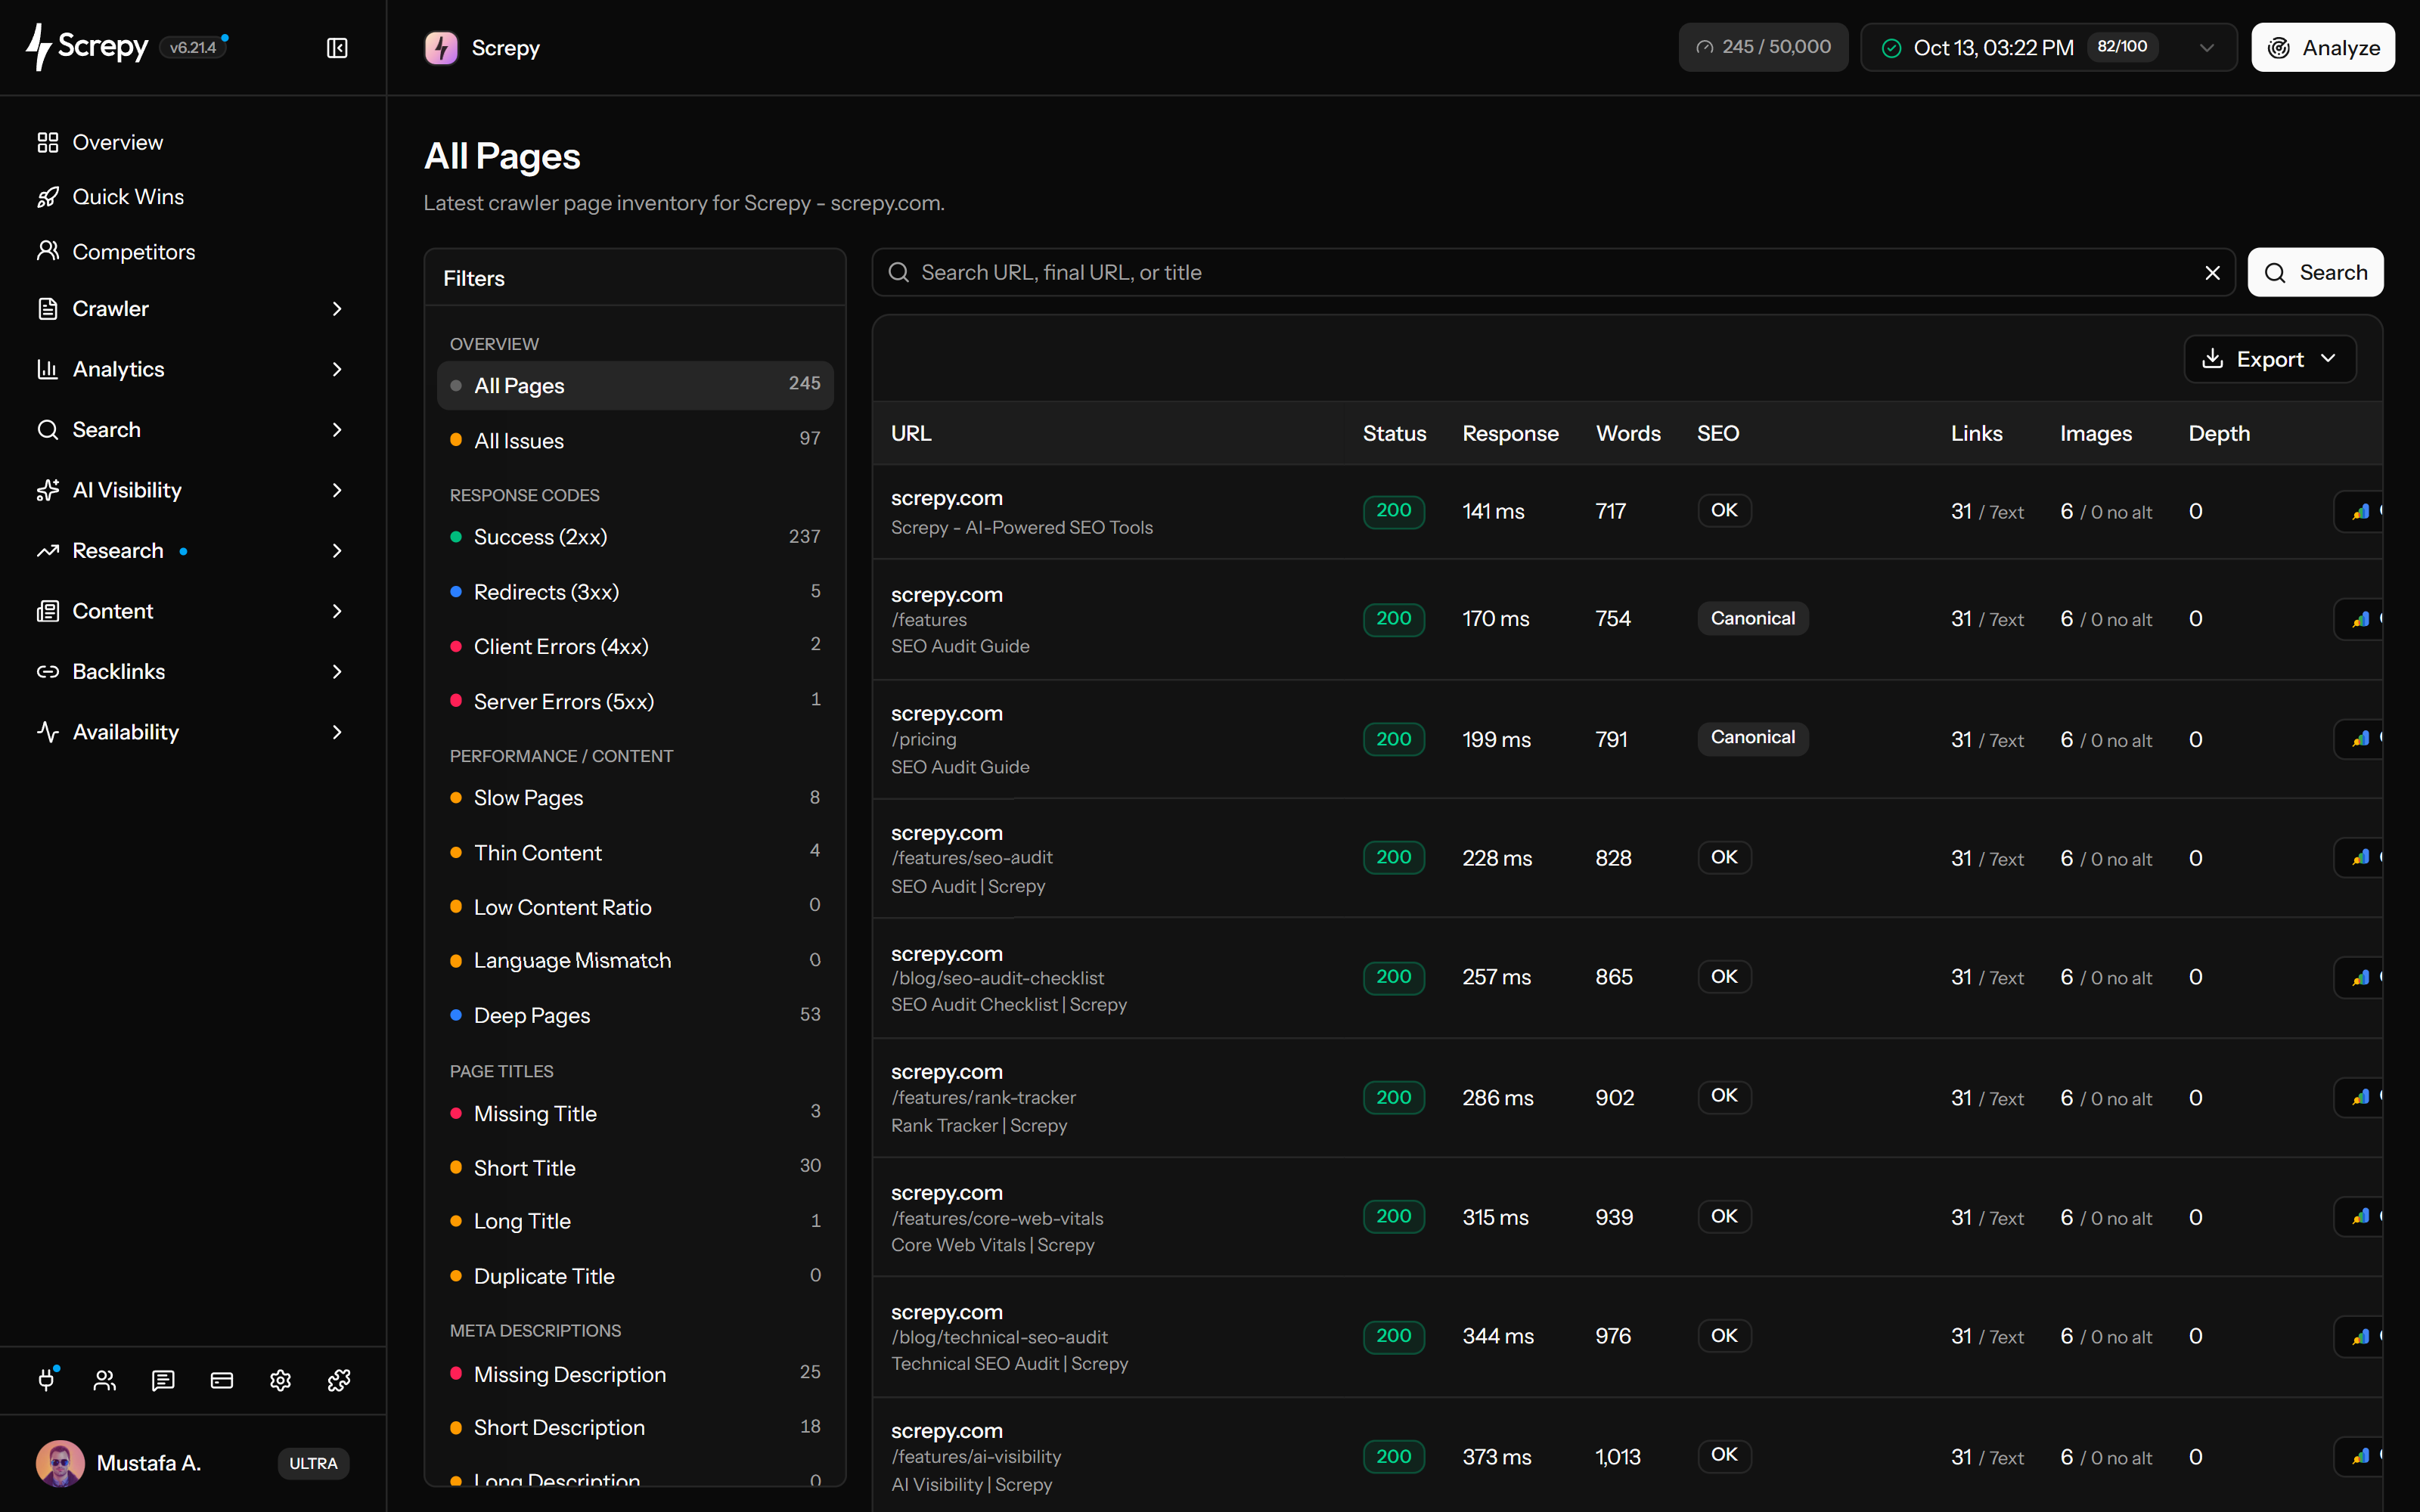
Screpy प्रोजेक्ट की वेबसाइट से शुरू करके क्लाउड में पहुँच योग्य आंतरिक लिंक का अनुसरण करता है। पहला क्रॉल सेटअप में शुरू होता है; बाद में नई सूची बनाने के लिए पेज, लिंक या इमेज रिपोर्ट में विश्लेषण करें का उपयोग करें।
क्लाइंट पर बना नेविगेशन शुरुआती HTML के क्रॉल से महत्वपूर्ण लिंक छिपा सकता है। स्क्रिप्ट महत्वपूर्ण सामग्री या नेविगेशन बनाएँ तो JavaScript रेंडरिंग चालू करें; सर्वर ज़रूरी HTML पहले से लौटाए तो बंद रखें।
<main id="app">
  <script />
</main>खोज का दायरा और अनुरोध गति अलग समस्याएँ हल करते हैं। गहराई तय करती है कि आंतरिक लिंक के कितने स्तर अनुसरण हों; समानांतर अनुरोध और अंतराल सर्वर दबाव नियंत्रित करते हैं। अधिक गहराई लिंक रहित पेज नहीं खोजती।
example.com3
//shop//shop/linen/रिकॉर्ड किए URL और लिंक से समझें कि श्रेणी, प्रोडक्ट या लेख साइट से कैसे जुड़ा है। गहरी सामग्री, पुराने नेविगेशन और रीडायरेक्ट से जाने वाले पाथ जाँचने के लिए स्रोत पेज संबंध उपयोग करें।
टीम के आवश्यक रिकॉर्ड से कार्यान्वयन फ़ाइल बनाएँ। काम किसी एक टेम्पलेट, रिस्पॉन्स स्टेटस या फ़ाइल पैटर्न का हो तो पूरी साइट भेजने के बजाय एक्सपोर्ट से पहले चुना क्रॉल फ़िल्टर करें।
पूर्ण क्रॉल वेबसाइट को उस समय पहुँचे रूप में दर्ज करता है। नेविगेशन बदलाव या माइग्रेशन के बाद खोज और लक्ष्य जाँचने के लिए नया क्रॉल चलाएँ; लाइव साइट बदलने पर पुराने रिकॉर्ड अपने आप अपडेट नहीं होते।
अपने AI सहायक को Screpy के SEO MCP सर्वर से जोड़ें। आखिरी पूरा क्रॉल पूछें, प्रभावित पेज देखें और तकनीकी SEO निष्कर्षों को काम के स्पष्ट क्रम में बदलें।
दायरा स्पष्ट रखें, किसी पैटर्न के पीछे मौजूद रिकॉर्ड जाँचें, मूल कार्यान्वयन सुधारें और अगले क्रॉल से परिणाम की पुष्टि करें।
शुरुआती URL, URL क्षमता, लिंक गहराई, JavaScript मोड, समानांतर अनुरोधों की संख्या, अनुरोधों के बीच अंतराल, robots नियम और क्रॉलर की पहुँच की पुष्टि करें। ये सेटिंग तय करती हैं कि स्नैपशॉट किन चीज़ों का प्रतिनिधित्व कर सकता है।
Screpy निर्धारित दायरे में उपलब्ध आंतरिक पाथ का अनुसरण करता है और हर खोजे गए URL, रिस्पॉन्स, गहराई, गंतव्य, लिंक संबंध तथा संबंधित पेज या इमेज डेटा को दर्ज करता है।
सुधार चुनने से पहले Pages, Links और Images रिपोर्ट से कुल संख्या के पीछे मौजूद प्रतिनिधि URL, स्रोत पेज, रीडायरेक्ट व्यवहार, मेटाडेटा, कैनोनिकल या इमेज उपयोग देखें।
वेबसाइट बदलने के बाद एक और क्रॉल चलाएँ। दायरा और सेटिंग तुलना योग्य रखें। फिर सत्यापित करें कि लक्षित URL और मूल पैटर्न सही कारण से बदले हैं।
क्रॉल डेटा तब सबसे उपयोगी होता है जब टीम को अभी याद हो कि क्या बदला है। अधिक जोखिम वाले काम से पहले शुरुआती स्थिति दर्ज करें और उसे जारी करने के बाद तुलना योग्य स्नैपशॉट बनाएँ।
लॉन्च से पहले महत्वपूर्ण URL, रीडायरेक्ट, अंतिम गंतव्य, कैनोनिकल और आंतरिक पाथ दर्ज करें। फिर उसी दायरे में नई संरचना क्रॉल करें।
जब नेविगेशन या महत्वपूर्ण पेज सामग्री ब्राउज़र में बनती हो, तो JavaScript रेंडरिंग उपयोग करें। फिर पुष्टि करें कि वे URL क्रॉल की सूची में आते हैं।
कमज़ोर तरीके से जुड़ी या मुश्किल से खोजी जा सकने वाली महत्वपूर्ण सामग्री पहचानने के लिए क्रॉल गहराई, स्रोत पेज, एंकर, विशेषताएँ और बार-बार आने वाले नेविगेशन पाथ देखें।
रूटिंग, नेविगेशन, CMS, टेम्पलेट और कंपोनेंट बदलने के बाद फिर क्रॉल करें। इससे कार्यान्वयन का संदर्भ ताज़ा रहते हुए बार-बार आने वाली तकनीकी समस्याएँ पकड़ने में मदद मिलती है।
जब डिप्लॉयमेंट मॉडल, क्रॉल नियंत्रण, कस्टम डेटा एक्सट्रैक्शन, नियमित निगरानी, टीम की पहुँच और रिपोर्टिंग निर्णय को प्रभावित करें, तो Screpy की तुलना Screaming Frog से करें।
खोज के पाथ समझने और पेज, लिंक तथा इमेज रिकॉर्ड जाँचने के लिए SEO Crawler उपयोग करें। जब टीम को समूहों में व्यवस्थित निष्कर्ष, समस्याओं की प्राथमिकता और तकनीकी स्थिति की व्यापक समीक्षा चाहिए, तो Website Audit उपयोग करें।
क्लाउड क्रॉल निर्धारित करें, पहुँच योग्य URL का नक्शा बनाएँ और तकनीकी पैटर्न के पीछे मौजूद Pages, Links तथा Images के मूल रिकॉर्ड देखें।
पूर्ण क्रॉल को समूहों में व्यवस्थित निष्कर्ष, प्रभावित URL पैटर्न, प्राथमिकताओं, एक्सपोर्ट और सुधार सत्यापित करने की दोहराने योग्य प्रक्रिया में बदलें।
साझा टेम्पलेट और बदलते URL समूह SaaS की ग्राहक प्राप्ति वेबसाइट तथा ईकॉमर्स कैटलॉग के लिए अलग-अलग जोखिम पैदा करते हैं।
लैंडिंग पेज, दस्तावेज़, साझा टेम्पलेट और रिलीज़ के बाद आई समस्याओं को ग्राहक प्राप्ति के एक संयुक्त माध्यम के रूप में देखें।
श्रेणी और उत्पाद पेज के प्रकारों, काम न करने वाले खरीदारी पाथ और कैटलॉग की संरचना में बदलाव का ऑडिट करें।
Screpy दस्तावेज़
क्रॉल का दायरा निर्धारित करने, क्रॉलर को पहुँच देने, Pages, Links और Images रिपोर्ट समझने तथा अधूरे परिणामों का कारण जानने के लिए Screpy की मार्गदर्शिकाएँ देखें।
क्रॉल में खोज, दायरा, JavaScript रेंडरिंग, पहुँच, अनुरोध की गति, रिपोर्ट, स्नैपशॉट और क्रॉल डेटा तथा वेबसाइट ऑडिट का अंतर समझें।
SEO क्रॉलर वेबसाइट के URL से शुरू करता है, निर्धारित दायरे में उपलब्ध आंतरिक लिंक का अनुसरण करता है और पहुँचने वाले पेज तथा संसाधनों की तकनीकी जानकारी दर्ज करता है। इससे बनी सूची टीमों को खोज के पाथ, रिस्पॉन्स कोड, रीडायरेक्ट, कैनोनिकल, आंतरिक लिंक, मेटाडेटा, इमेज और साइट पर बार-बार आने वाले पैटर्न जाँचने में मदद करती है।
SEO क्रॉलर तकनीकी सूची बनाता है, जिसमें खोजे गए URL, रिस्पॉन्स, पाथ, पेज डेटा, लिंक, इमेज और क्रॉल का संदर्भ शामिल होते हैं। Website Audit उस क्रॉल को समूहों में व्यवस्थित निष्कर्ष, प्रभावित पैटर्न, प्राथमिकताओं और सुधार सत्यापित करने की प्रक्रिया के रूप में समझाता है। खोज और मूल रिकॉर्ड चाहिए तो क्रॉलर उपयोग करें; वेबसाइट की स्थिति की व्यापक समीक्षा और प्राथमिकता वाली कार्रवाई चाहिए तो ऑडिट उपयोग करें।
Pages में क्रॉल किए गए URL और उनके रिस्पॉन्स, गहराई, मेटाडेटा, हेडिंग, कैनोनिकल, इंडेक्स किए जा सकने की स्थिति, सामग्री, संरचित डेटा, सोशल तथा संबंधित संकेत दर्ज होते हैं। Links में गंतव्य को स्थिति, एंकर, विशेषताओं, उपयोग और स्रोत पेज से जोड़ा जाता है। Images में इमेज स्रोतों को रिस्पॉन्स, alt टेक्स्ट, आयाम, लोडिंग संबंधी विशेषताओं और पेज पर उपयोग के साथ समूहित किया जाता है।
हाँ। हर पूर्ण क्रॉल तारीख वाला स्नैपशॉट है। रिलीज़ या सुधार के बाद नया क्रॉल चलाएँ और समान दायरे तथा सेटिंग वाले स्नैपशॉट की तुलना करें, ताकि कवरेज या समस्याओं की कुल संख्या में बदलाव को अलग क्रॉल कॉन्फ़िगरेशन के प्रभाव से न मिलाया जाए।
हाँ। Links रिपोर्ट असफल या रीडायरेक्ट होने वाले गंतव्य पहचानने और उनका संदर्भ देने वाले क्रॉल किए गए पेज तक पहुँचने में मदद करती है। इससे डेवलपर और संपादकों को केवल गंतव्य URL के बजाय सुधारने के लिए विशिष्ट स्रोत पेज, साझा कंपोनेंट या टेम्पलेट मिलता है।
नहीं। क्रॉल डेटा तकनीकी स्थितियाँ खोजने और सत्यापित करने में मदद करता है, लेकिन रैंकिंग प्रासंगिकता, सामग्री की गुणवत्ता, विश्वसनीयता, प्रतिस्पर्धा, माँग, इंडेक्सिंग और सर्च इंजन द्वारा हर पेज की व्याख्या पर भी निर्भर करती है। क्रॉलर फ़िल्टर को जाँच के प्रमाण मानें, रैंकिंग बढ़ाने के स्वचालित निर्देश नहीं।
Screpy प्रोजेक्ट की वेबसाइट से शुरू करता है और निर्धारित URL क्षमता तथा क्रॉल गहराई के भीतर उपलब्ध आंतरिक लिंक का अनुसरण करता है। पेज का लिंक न होने, चुनी गई गहराई से बाहर होने, अवरुद्ध होने, प्रोजेक्ट के होस्ट से बाहर रीडायरेक्ट होने, JavaScript रेंडरिंग पर निर्भर होने या अनुपयोगी सामग्री लौटाने के कारण वह सूची में नहीं आ सकता।
जिन वेबसाइट के महत्वपूर्ण लिंक या सामग्री ब्राउज़र में बनते हैं, उनके लिए Screpy वैकल्पिक JavaScript सेटिंग देता है। रेंडरिंग उन साइटों पर खोज बेहतर कर सकती है, लेकिन robots नियम, प्रमाणीकरण, फ़ायरवॉल, बॉट सत्यापन चुनौतियाँ, टाइमआउट या निर्धारित क्रॉल दायरे को दरकिनार नहीं करती।
अधिकतम URL यह सीमा तय करता है कि क्रॉल कितने खोजे गए URL सहेज सकता है। क्रॉल गहराई शुरुआती पेज से Screpy द्वारा अनुसरण किए जाने वाले आंतरिक लिंक स्तरों की संख्या सीमित करती है। इनमें से कोई भी सेटिंग बढ़ाने से अवरुद्ध पहुँच, अनुपस्थित आंतरिक लिंक, रीडायरेक्ट, अनुरोध दर की सीमाएँ या अनुपयोगी रिस्पॉन्स ठीक नहीं होते।
क्रॉलर को लॉगिन, CAPTCHA, ब्राउज़र सत्यापन चुनौती, फ़ायरवॉल अवरोध या अनुरोध दर की सीमा के कारण अस्वीकृति के बिना वास्तविक पेज मिलना चाहिए। हर सुरक्षा स्तर पर ScrepyBot और दस्तावेज़ों में दिए गए क्रॉलर IP को अनुमति दें, robots.txt में पहुँच की पुष्टि करें और जाँचें कि सफल रिस्पॉन्स में वास्तविक पेज का HTML है।
हाँ। समानांतर अनुरोधों की सेटिंग तय करती है कि एक साथ कितने अनुरोध चलें। अनुरोध अंतराल केवल समानांतर अनुरोधों की संख्या 1 होने पर उपलब्ध है; अधिक संख्या पर सहेजा गया अंतराल शून्य होता है। सर्वर स्वचालित ट्रैफ़िक सीमित करे तो अनुरोधों का दबाव घटाएँ और अगले क्रॉल में वास्तविक पेज रिस्पॉन्स मिलने की पुष्टि करें।
दोनों अलग प्रश्नों के उत्तर देते हैं। Search Console Google Search का प्रदर्शन और चुनिंदा इंडेक्सिंग जानकारी दिखाता है। SEO क्रॉलर सक्रिय रूप से आपके आंतरिक लिंक का अनुसरण करता है और तकनीकी सूची बनाता है, जिसे आप Google के समस्या बताने या ट्रैफ़िक बदलने से पहले जाँच सकते हैं।
Super Intelligence शब्दावली समझें और वेबसाइट ऑडिट, सर्च रिसर्च, रैंकिंग व AI विज़िबिलिटी को Screpy के एक व्यावहारिक कार्यप्रवाह में जोड़ें।